2026 年 10 月模型趋势报告:能力、成本与选型边界
截至 2026 年 10 月 20 日的模型趋势快照:解读 48 张能力、价格、规模、速度与偏好图表,对照 8 月报告,说明评分更新与数据口径的边界。
- 整体趋势总结
- 与上一期相比
- 方法与局限
- 数据范围与读图方法
- 基准与综合能力:前沿上移,头部仍有明显差距
- 实验室与国家:中美主导供给,累计收录仍在补齐
- 开放模型:发布占比与能力前沿需要分开看
- 模型形态:多模态普及,MoE 集中于开放高分区
- 价格与价值
- 效率与规模
- 速度与上下文:容量上限和任务速度分别验收
- 人类偏好:能力有参考价值,价格解释力有限
数据来源:AI Trends (October 2026) — AI Trend Analysis, LLM Statistics & Industry Insights;抓取日期:2026-10-20;动态图表数量:48。
AI 模型的能力、价格、速度和使用偏好都在持续变化。单看某一张排行榜,很容易把评测分数、真实体验和成本效率混为一谈。这份报告先给出跨图整体判断及其依据,再说明方法和口径,随后按主题逐图展开。
本期是截至 2026 年 10 月 20 日的快照,10 月和第四季度均未结束。 仓库中上一期是 8 月报告,因此下文是 8 月至 10 月的跨期对照,不是 9 月至 10 月的月度环比。长期选型原则沉淀在 AI、LLM 与 Agent 维基。
整体趋势总结
1. 头部能力仍在提高,追赶差距随时间变化
判断依据: 本期综合分最高为 Claude Opus 5.5 的 60.3,Anthropic 的最佳编程指数为 49.7。领先差距图中,Opus 5.5 在 9 月首次登顶时领先 9.6 分,最近一次采样为 8.4 分,说明前沿提高与追赶同时发生。图 1–5 展示的是本期口径下的历史轨迹,不能据此直接计算相对 8 月报告的评分增幅。
2. 模型供给继续扩展,累计数量包含历史回补
判断依据: 累计收录从 8 月快照的 334 个增至 414 个;国家图排除 5 个国家信息缺失的模型后,美国和中国分别为 216、145 个。2 月、4 月、6 月和 7 月的历史数量也被上调,因此净增的 80 个不等于两期之间新发布的 80 个。数量变化需要结合图 6–9 的时间与覆盖范围理解。
3. 多模态成为常见能力,开放比例是另一条独立维度
判断依据: 截至抓取日,第四季度 12 个模型中有 11 个支持视觉或多模态,开放模型则为 5 个,分别约占 92% 和 42%。图 10 与图 13 的标签描述不同属性,不能相互替代;第四季度和 10 月都尚未结束,这些比例只是阶段快照。
4. 固定能力门槛的最低 API 价格下降,但价格比较必须统一口径
判断依据: 图 17 在当前评分口径下回溯得到:40+ 分模型最低混合价格由每百万 token 3.8 美元降至 0.08 美元。图 15 的中国价格中位数为 0.45 美元,低于 8 月标签的 0.48 美元。前者是历史门槛曲线,后者是两期样本中位数;都不能解释成同一批模型统一降价,更不能与使用不同输入输出混合比例的价格图直接拼接。
5. 参数和训练数据规模不足以单独解释模型能力
判断依据: 图 27 显示,当前样本达到 50+ 分的最小总参数量为 753B,达到 40+ 分为 27.8B;图 34–36 则显示相近规模仍有明显能力差异。图 30 的训练数据量与综合分拟合 R² 仅为 0.09。规模可用于筛选部署候选,但不能代替对任务能力、激活参数与运行成本的验证。
6. 长上下文、输出吞吐和能力需要分别验收
判断依据: 图 38 的最大上下文纪录仍为 200 万 token,与 8 月相同。图 39 中 Claude Opus 5.5 为 72 token/s、60.3 分,Mercury 2 为 1009 token/s、23.3 分,显示最高能力与最高吞吐分属不同模型。标称窗口不是长文利用质量,吞吐也不包含首 token 等待、推理和工具执行的全部耗时。
7. 偏好评测仍有独立价值,昂贵并不保证更受偏爱
判断依据: 图 45 的综合分与一般偏好 Pearson r 为 0.56,图 47 中价格与偏好的拟合 R² 仅为 4%;它们说明综合分可提供线索,API 单价却很难解释这组体验差异。图 48 的八个模型及分数又与 8 月完全一致,提醒我们逐图核对更新边界,再用自己的任务验证候选。
与上一期相比
对比基线:2026 年 8 月 AI/LLM 趋势图表解读;上一期抓取日期:2026-08-03。
两期均为 48 张图,原始标题与顺序全部相同,没有新增、删除或改名。不过,综合分方法页已在两次抓取之间更新,且来源会回补历史模型。本节区分页面快照变化、统计覆盖变化与尚未确认的评分可比性,不把累计收录差值当作本月发布量,也不计算同名综合分的跨期增幅。
1. 图表清单未变,但综合分不能据同名直接比较
对比证据: 8 月与本期的 48 个原始标题逐项一致。当前 LLM Stats Score 方法页 标注 v3.1、更新于 2026 年 9 月 2 日;8 月报告没有保留当时的方法版本或公式。
可比性说明: 无法确认两期综合分及其门槛使用同一版本,因此不计算最高分、40+ 门槛价格、每分成本、参数效率或相关系数的跨期增幅;本期图内的历史曲线是当前口径的回溯。
2. 累计收录由 334 增至 414,国家图的主要增量来自中美
对比证据: 总收录净增 80。国家图中美国 173→216、中国 121→145,分别增加 43 和 24;法国 32→34、加拿大 3→5、韩国 1→4,另新增日本 1 个。当前 414 个收录中有 5 个缺少国家字段,因此国家图合计为 409。
可比性说明: 这是同一来源累计标签的快照差值,可能包含补录或分类修订;已核查公开代码,国家图会过滤国家字段缺失的记录,不能将 409 的国家构成直接当作全部 414 个模型的构成。
3. 历史月份被回补,净增收录不等于最近三个月的新发布
对比证据: 2026 年 2 月由 16 改为 19,4 月由 18 改为 21,6 月由 13 改为 15,7 月由 12 改为 16。本期 8、9、10 月分别显示 28、22、12 个,10 月尚未结束。
可比性说明: 同一月份可以直接核对来源显示值是否修订,但修订不代表那些模型在两次抓取之间才发布;本期月度数应按本期收录范围理解,不能从两期总数相减还原月度新增。
4. 最新显示季度由第三季度切换到第四季度
对比证据: 8 月报告的第三季度当时仅覆盖 7 月,开放 3/12(25%);本期完整第三季度为 30/66(45%)。最新第四季度截至抓取时开放 5/12(42%),多模态 11/12(92%)。
可比性说明: 第三季度从部分收录补齐为完整季度,且历史月份会回补,因此 25%→45% 不能称为同周期增长;第四季度仍未结束,42% 和 92% 也不是最终季度结构。
5. 中国价格中位数标签下降到每百万 token 0.45 美元
对比证据: Price by Country 图卡在 8 月写明中国最低中位数为 0.48 美元,本期为 0.45 美元。
可比性说明: 可确认同名图的价格中位数标签下降;样本组成、供应商选择和价格混合规则可能变化,不能解释为同一批模型普遍降价,也不将其等同于单位任务成本下降。
6. 上下文纪录保持 200 万 token,大训练数据样本增加
对比证据: 两期 The Context Race 都将 Grok-4 Fast Reasoning 的 2.0M token 列为当前纪录;The Training Data Race 中使用 1T+ 训练 token 的模型由 66 个变为 73 个。
可比性说明: 这些字段不直接依赖综合分,可作来源披露值的快照比较;新增样本可能来自公开信息补齐,不代表训练刚刚完成,最大窗口也不能证明有效长上下文质量保持不变。
7. 人类偏好图的八个可见排名与分数未变
对比证据: 两期 Human Preference Map 都列出 GPT-5.6 Sol 29.5、Claude Fable 5 27.2、GPT-5.5 24.5,后五个模型及分数也逐项一致;本期其他能力图已显示 Claude Opus 5.5。
可比性说明: 只能确认这张图没有显示新的快照变化,不能据页面月份推定每张图都同步更新,也不能据此认定现实中的用户偏好两个月没有变化。
方法与局限
- 时间快照:图表采集与交互数值核对在 2026 年 10 月 20 日完成。10 月和第四季度均未结束,源站各图也未必同步更新;本报告不把页面月份视为每个数据点的更新时间。
- 评分方法:当前 LLM Stats Score 方法说明 标注 v3.1,更新于 9 月 2 日。它汇总各基准内的相对表现,并考虑证据的不确定性;缺失评测不被当成失败。公开说明未包含完整实现参数,本文无法独立复算综合指数,也无法确认 8 月报告与本期采用同一版本。
- 价格口径:多张图按输入与输出 5∶1 混合报价,图 22–24 则采用 1∶1,另有图优先采用数据源提供的混合价格。同一模型在不同图中的美元数值可能因此不同。所有单价都不能直接替代一次成功任务的总费用。
- 样本与标签:不同图表对国家、参数、价格、架构和评分字段有不同完整性要求。本文保留源图,并在对应解读中说明已核实的百分号误标、单位倍率差异和颜色分类失效,不根据有问题的标签推导结论。
- 相关不等于因果:散点图或时间趋势只能说明变量共同变化,不能单独证明某个因素导致另一个结果。
- 来源边界:图表版权与原始数据解释权归来源网站;引用时应保留来源链接和抓取日期。
数据范围与读图方法
本次分析覆盖来源页面在抓取时稳定呈现的 48 张图表、8 个主题分组,两次扫描得到相同的图表顺序和标题。明确数字来自图卡、坐标、图例及交互悬浮提示;涉及统计筛选或标签错误时,另核对来源页面公开加载的数据和绘图逻辑。悬浮点只用于核对文中代表性数值,不声称覆盖源站全部记录;仅凭图形走势得到的判断标记为视觉推断。
为完整保留坐标、图例和脚注,站内图片以来源的原始 SVG 绘图区渲染,并补齐原站图卡文字。此步骤修复响应式页面截图中的裁切,没有改动原图的数据点、曲线或坐标尺度。每张图下的“证据依据”可展开查看。
不同评测、价格口径、参数规模和吞吐量的采集条件并不完全一致,因此跨图比较适合发现候选趋势,不应被理解为严格受控实验。
读图术语
- 综合能力分(LLM Stats Score;LLM = Large Language Model):来源对多项评测中的相对表现与证据不确定性进行汇总的分数,不是正确率,也不是单项测试的百分制成绩。当前方法页标注 v3.1。
- 编程指数(Coding Index):来源用编程评测子集形成的能力视图;与整体综合分分别观察,缺失评测不代表模型能力为零。
- AIME(American Invitational Mathematics Examination,美国数学邀请赛):数学解题评测所采用的试题来源;图中的 AIME 2025 与其他年份或任务不能默认同难度。
- MMMU(Massive Multi-discipline Multimodal Understanding and Reasoning,多学科多模态理解与推理):考察跨学科图文理解与推理的评测。MMMU 与 MMMU Pro 是不同评测视图,分数不能混用。
- MoE(Mixture of Experts,混合专家):通过路由选择部分专家参与计算的架构;总参数量与每次推理激活的参数量不同,不能直接用总参数估算计算成本。
- 开放权重(Open Weights):公开可获取的模型权重,不必然同时公开训练数据、训练代码或提供无限制许可。来源图例中的 Open Source 在本文按其模型分类理解。
- 混合 API 单价(Blended API Price;Application Programming Interface):把输入与输出单价按某种权重组合后的每百万 token 价格。图表未必采用相同权重、服务商或时间点,必须逐图核对。
- Arena 偏好评分(Arena Rating):由模型对比选择等偏好数据形成的相对分数。原始 rating、标准化分和$\mu-3\sigma$保守分属于不同尺度;默认图卡也不一定使用同一投票池。
- 帕累托前沿(Pareto Frontier):在图中给定的两个维度与样本内,没有另一个点同时更好的候选集合。前沿会随任务指标、样本和服务条件改变。
- 相关统计(Pearson Correlation Coefficient, r;Coefficient of Determination, R²):r 描述线性关系的方向与强度,R² 描述给定回归解释的方差比例。二者不是准确率,也不能单独支持因果结论。
基准与综合能力:前沿上移,头部仍有明显差距
本组结论: 本期综合分与编程指数均由 Anthropic 领先,前沿竞争同时覆盖多家实验室;若干基准已进入高分区,但不同任务的饱和程度和头部追赶节奏并不一致。
图 01|基准测试的饱和程度
原始标题:Benchmark Saturation
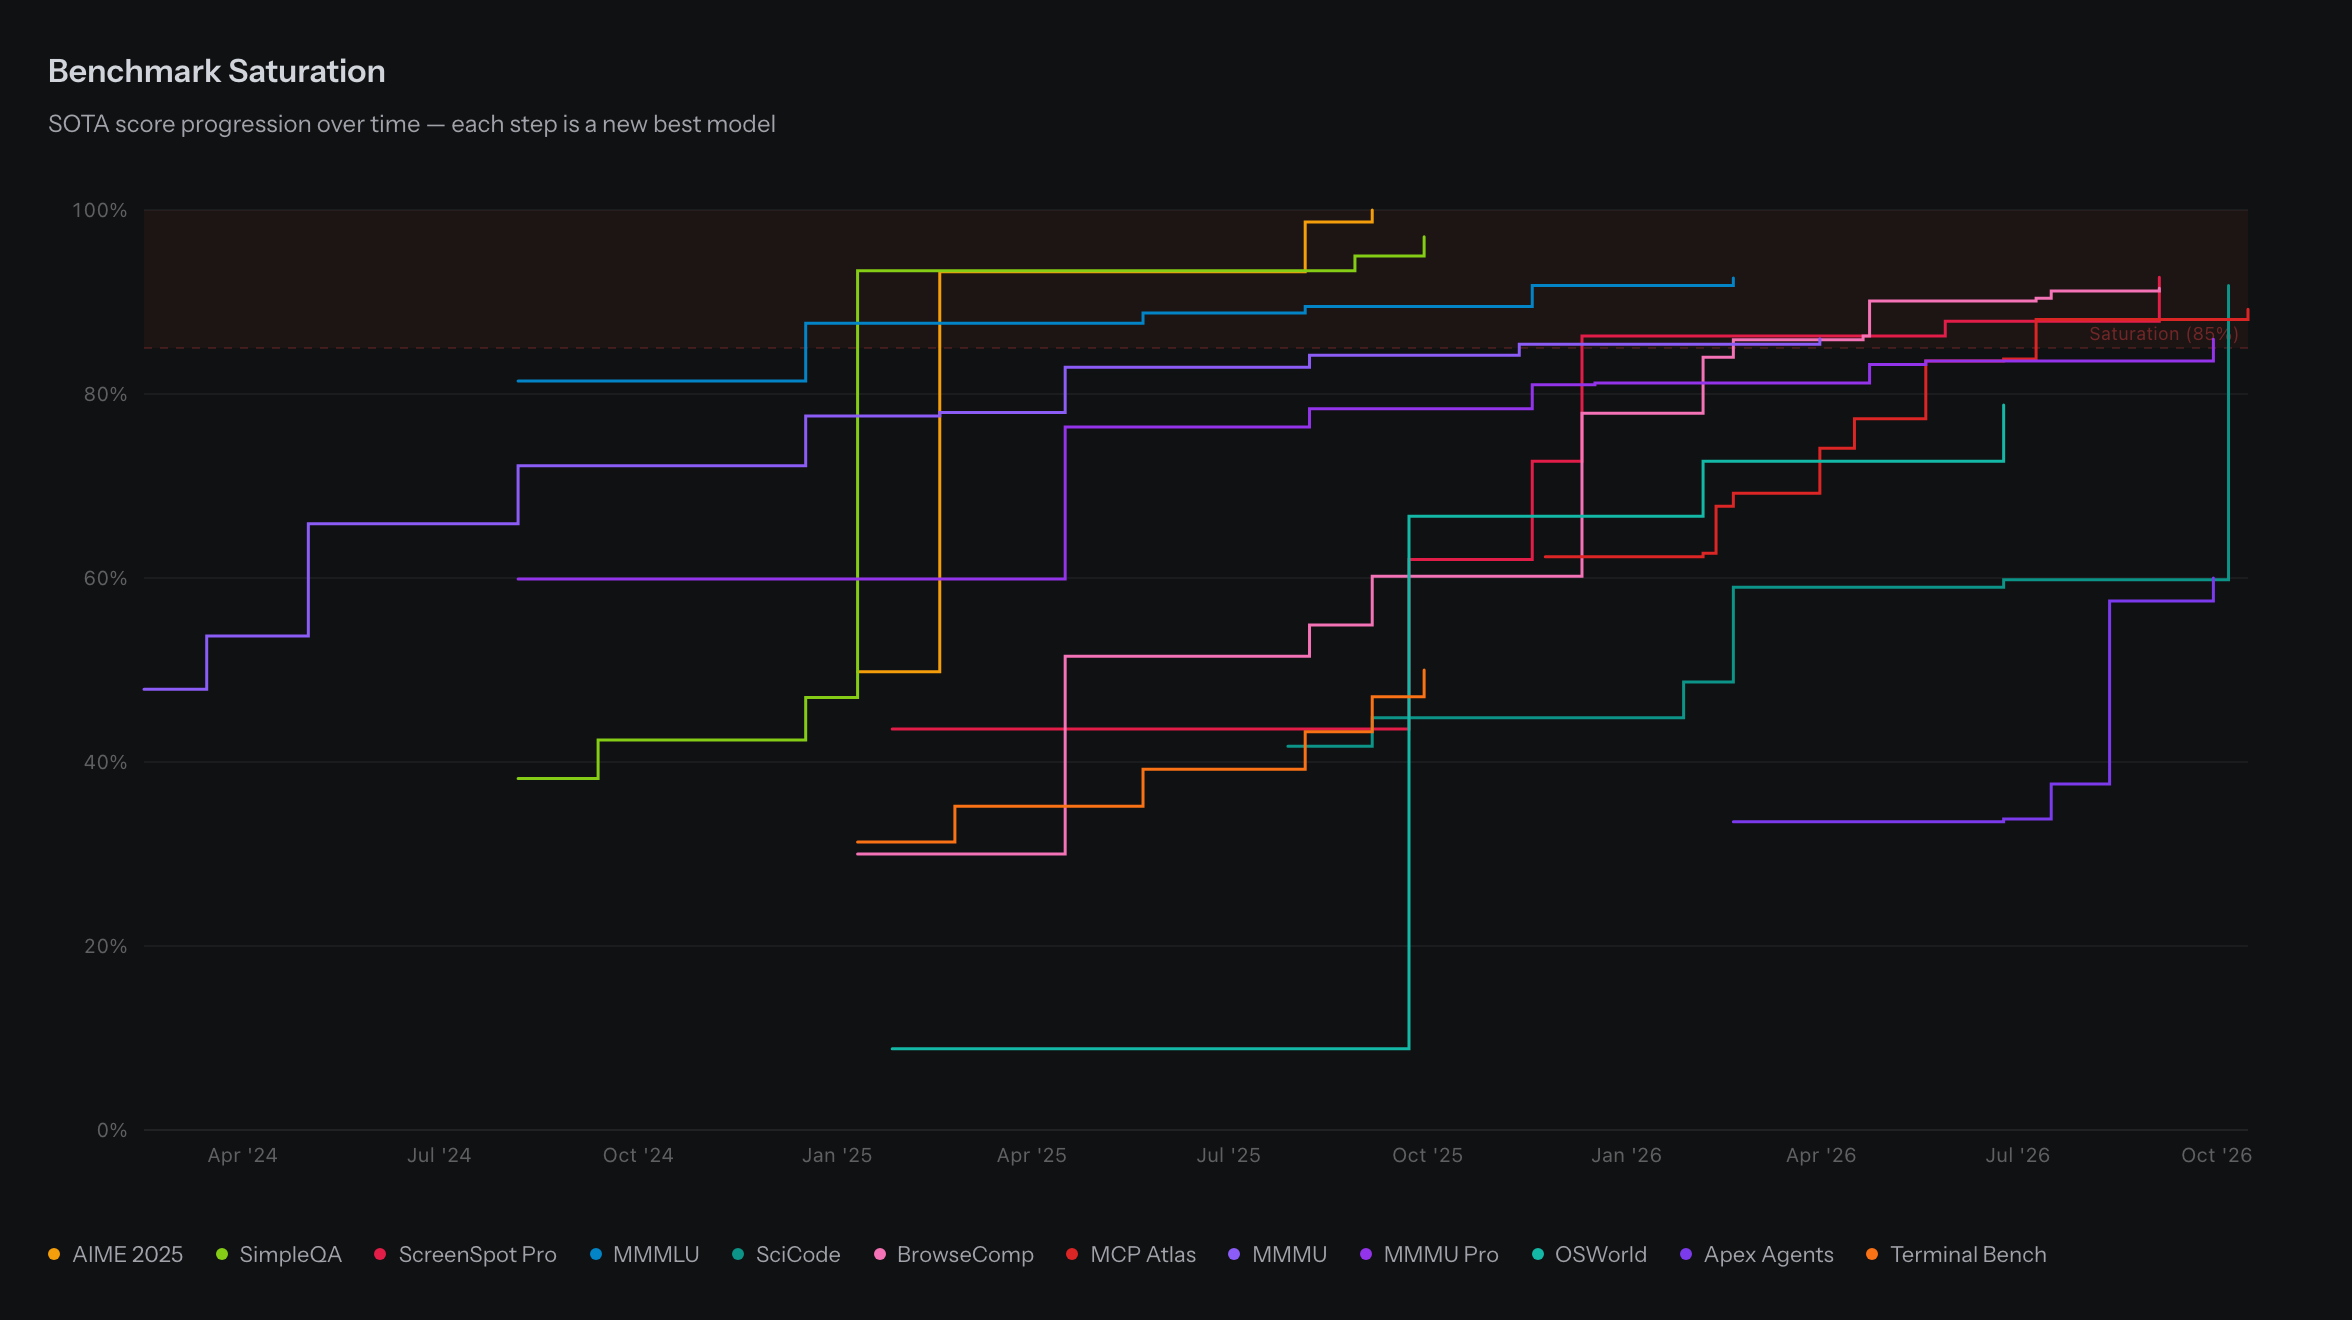
怎么看: 横轴是时间,纵轴是各基准的历史最高分;每次阶梯上升代表纪录刷新,85% 虚线是来源设置的饱和参考线。
图表显示: 部分基准的最好成绩已越过 85% 参考线,但不同任务到达高分区的时间不同;读图应同时关注尚未饱和的任务,以及旧任务还有多少区分度。
关键模型 / 数据点:
- 85%:来源图设定的饱和参考线。
- 2025 年 6 月提示值:SimpleQA 93.4%、AIME 2025 93.3%、MMMLU 88.8%。
- 同一历史位置:BrowseComp 51.5%、Terminal Bench 39.2%、OSWorld 8.8%。
解读边界: 图中展示的是各基准的历史最高值,不能代表全部模型;不同任务的分数不可直接作为难度的统一尺度。
证据依据
- 直接证据:图中标出 Saturation (85%) 参考线。
- 视觉推断:多条历史最好成绩曲线进入参考线以上区域,另有曲线仍明显低于参考线。
- 直接证据:本图悬浮提示 列出 2025 年 6 月各基准分数。
图 02|头部综合分差距
原始标题:The Convergence
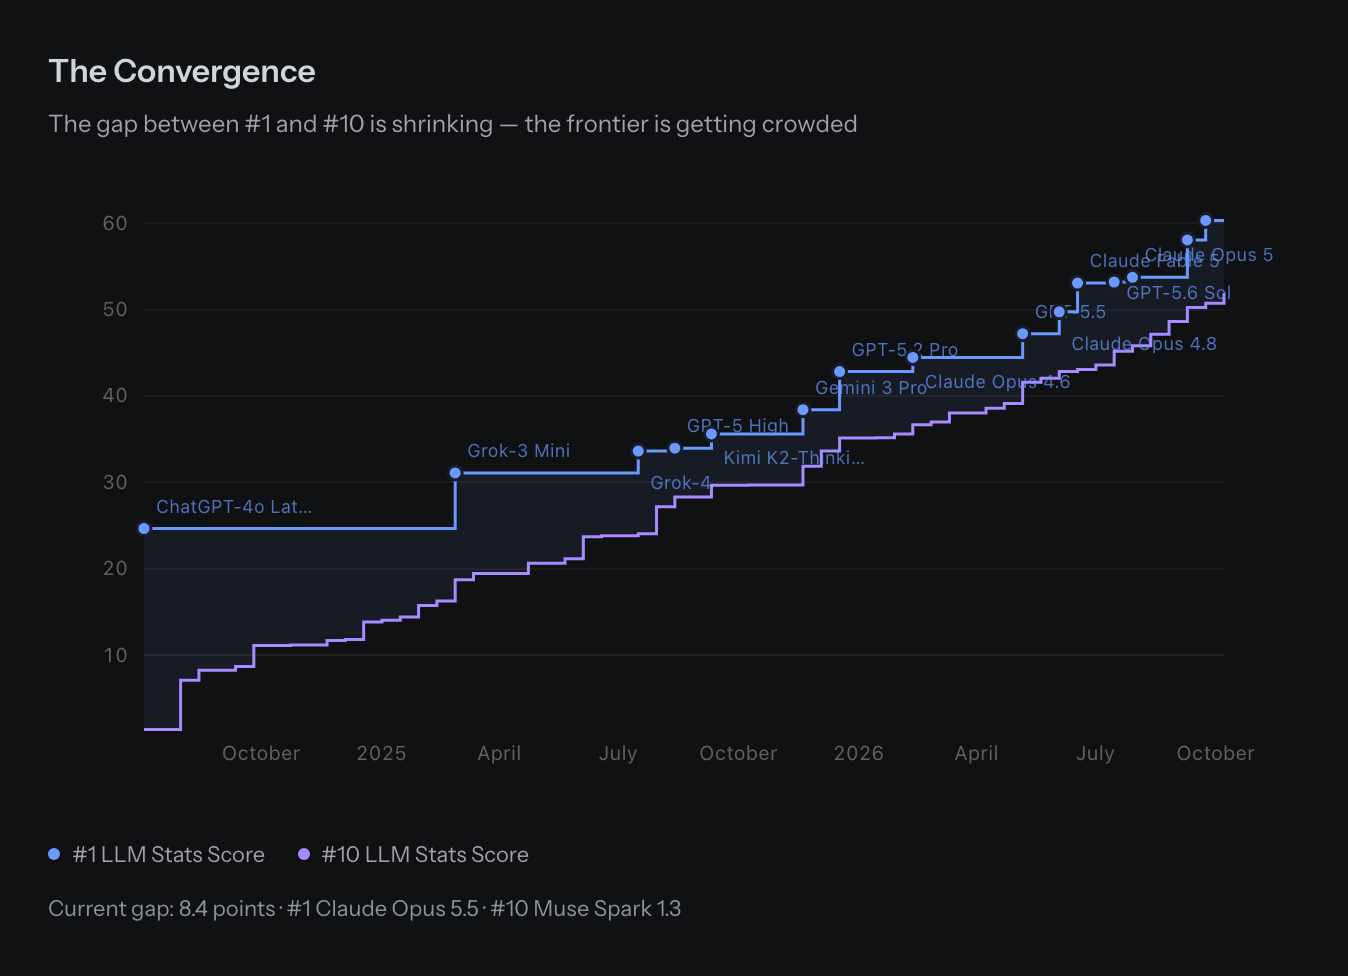
怎么看: 蓝线与紫线分别跟踪 LLM Stats Score 第 1 名和第 10 名;两线垂直距离表示头部差距。
图表显示: 前沿与第 10 名均持续上升,但领先模型发布时差距会重新拉开。Claude Opus 5.5 在 9 月首次登顶的采样点领先 9.6 分,图卡最近采样点为 8.4 分,体现后续模型追赶。
关键模型 / 数据点:
- Claude Opus 5.5:综合分 60.3,2026 年 9 月首次登顶采样点领先第 10 名 9.6 分。
- GPT-6 Astra:综合分 58.1,2026 年 9 月登顶采样点领先 7.8 分。
- 当前图卡:Claude Opus 5.5 与第 10 名 Muse Spark 1.3 相差 8.4 分。
解读边界: 源站每 14 天取一次排名快照:圆点对应榜首首次更替时点,Current gap 对应最后一个采样点,9.6 与 8.4 并非同一时点冲突;也不代表抓取当日逐日实时排名。
证据依据
- 直接证据:本图 悬浮提示 给出 Claude Opus 5.5 与 GPT-6 Astra 的综合分、日期和历史差距。
- 直接证据:图卡标注最新采样差距 8.4;公开前端代码以每 14 天快照计算,圆点只在榜首模型更替时产生。
图 03|实验室过去一年的综合进展
原始标题:Lab Progress
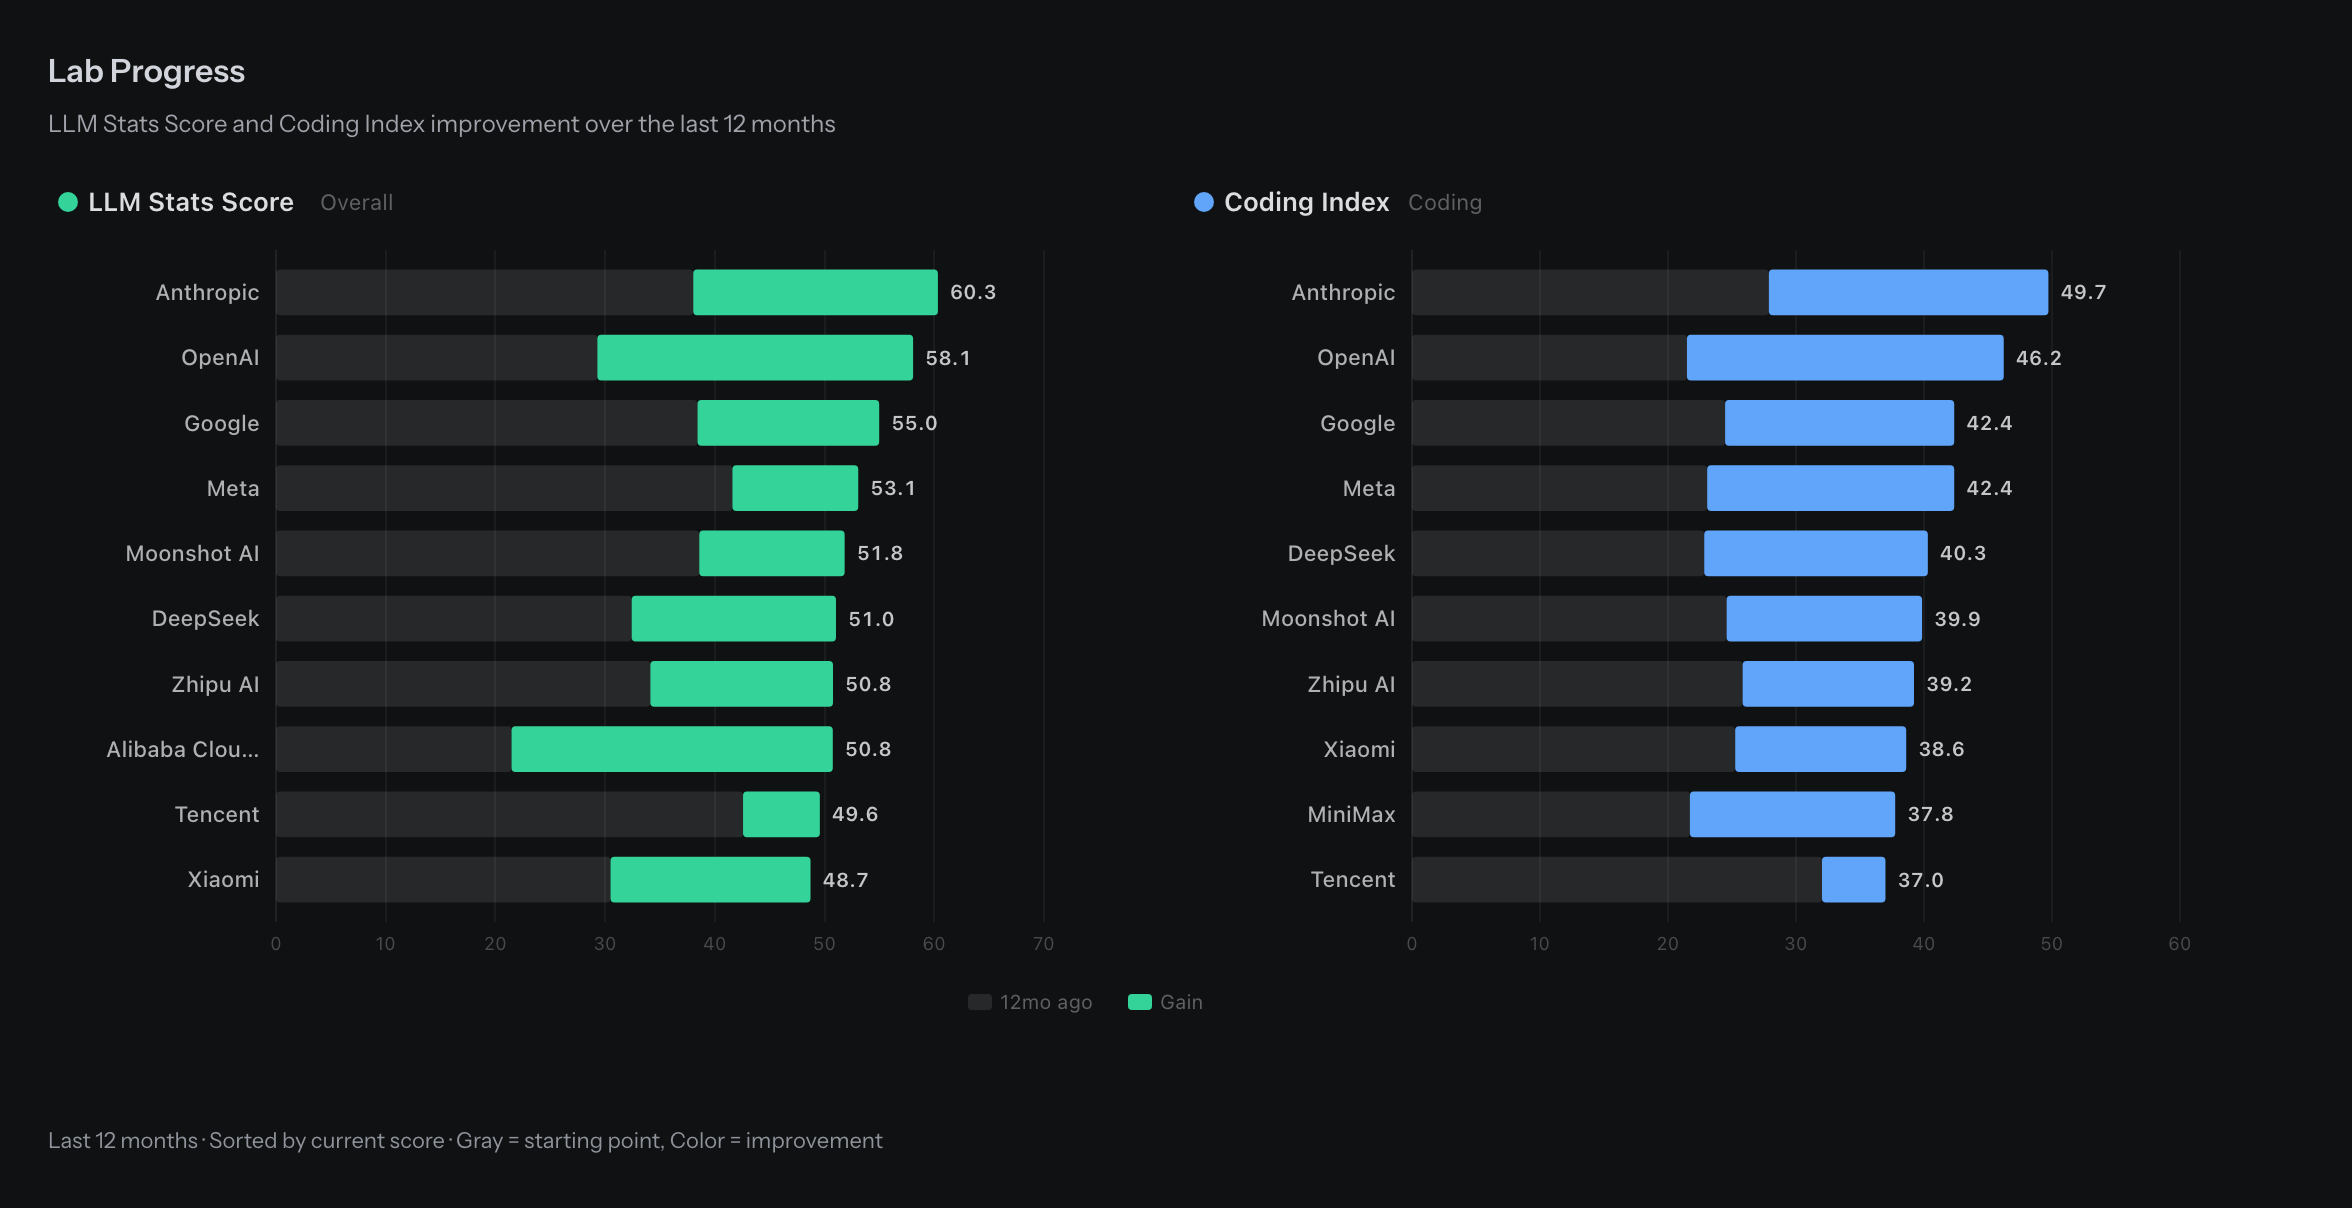
怎么看: 左栏是 LLM Stats Score,右栏是 Coding Index;灰色表示 12 个月前的起点,彩色表示本期口径下的增量,各栏按当前成绩排序。
图表显示: Anthropic 在两项指数均居首,OpenAI 随后;综合分榜与编程榜的后续组织次序不同,说明通用能力与编程能力需要分别看。
关键模型 / 数据点:
- Anthropic:综合分 38.0→60.3,Coding Index 27.9→49.7。
- OpenAI:综合分 29.3→58.1,Coding Index 21.5→46.2。
- Alibaba Cloud / Qwen Team:综合分 21.5→50.8,图内标注增加 29.3 分。
- Google:综合分 55.0;Google 与 Meta 的 Coding Index 均为 42.4。
解读边界: 每家组织只取最好成绩,不代表平均模型质量或投入产出;图内回溯增量也不等于与上期报告的同版分数差。
证据依据
- 直接证据:SVG 在两栏逐项标出组织名称与当前指数。
- 视觉推断:两栏组织的排序并不完全一致。
- 直接证据:本图 悬浮提示 分别给出两项指数的 12mo ago、Current 和 Gain;这里的变化均为本期图内回溯。
图 04|组织级综合分前沿
原始标题:Organization Progress
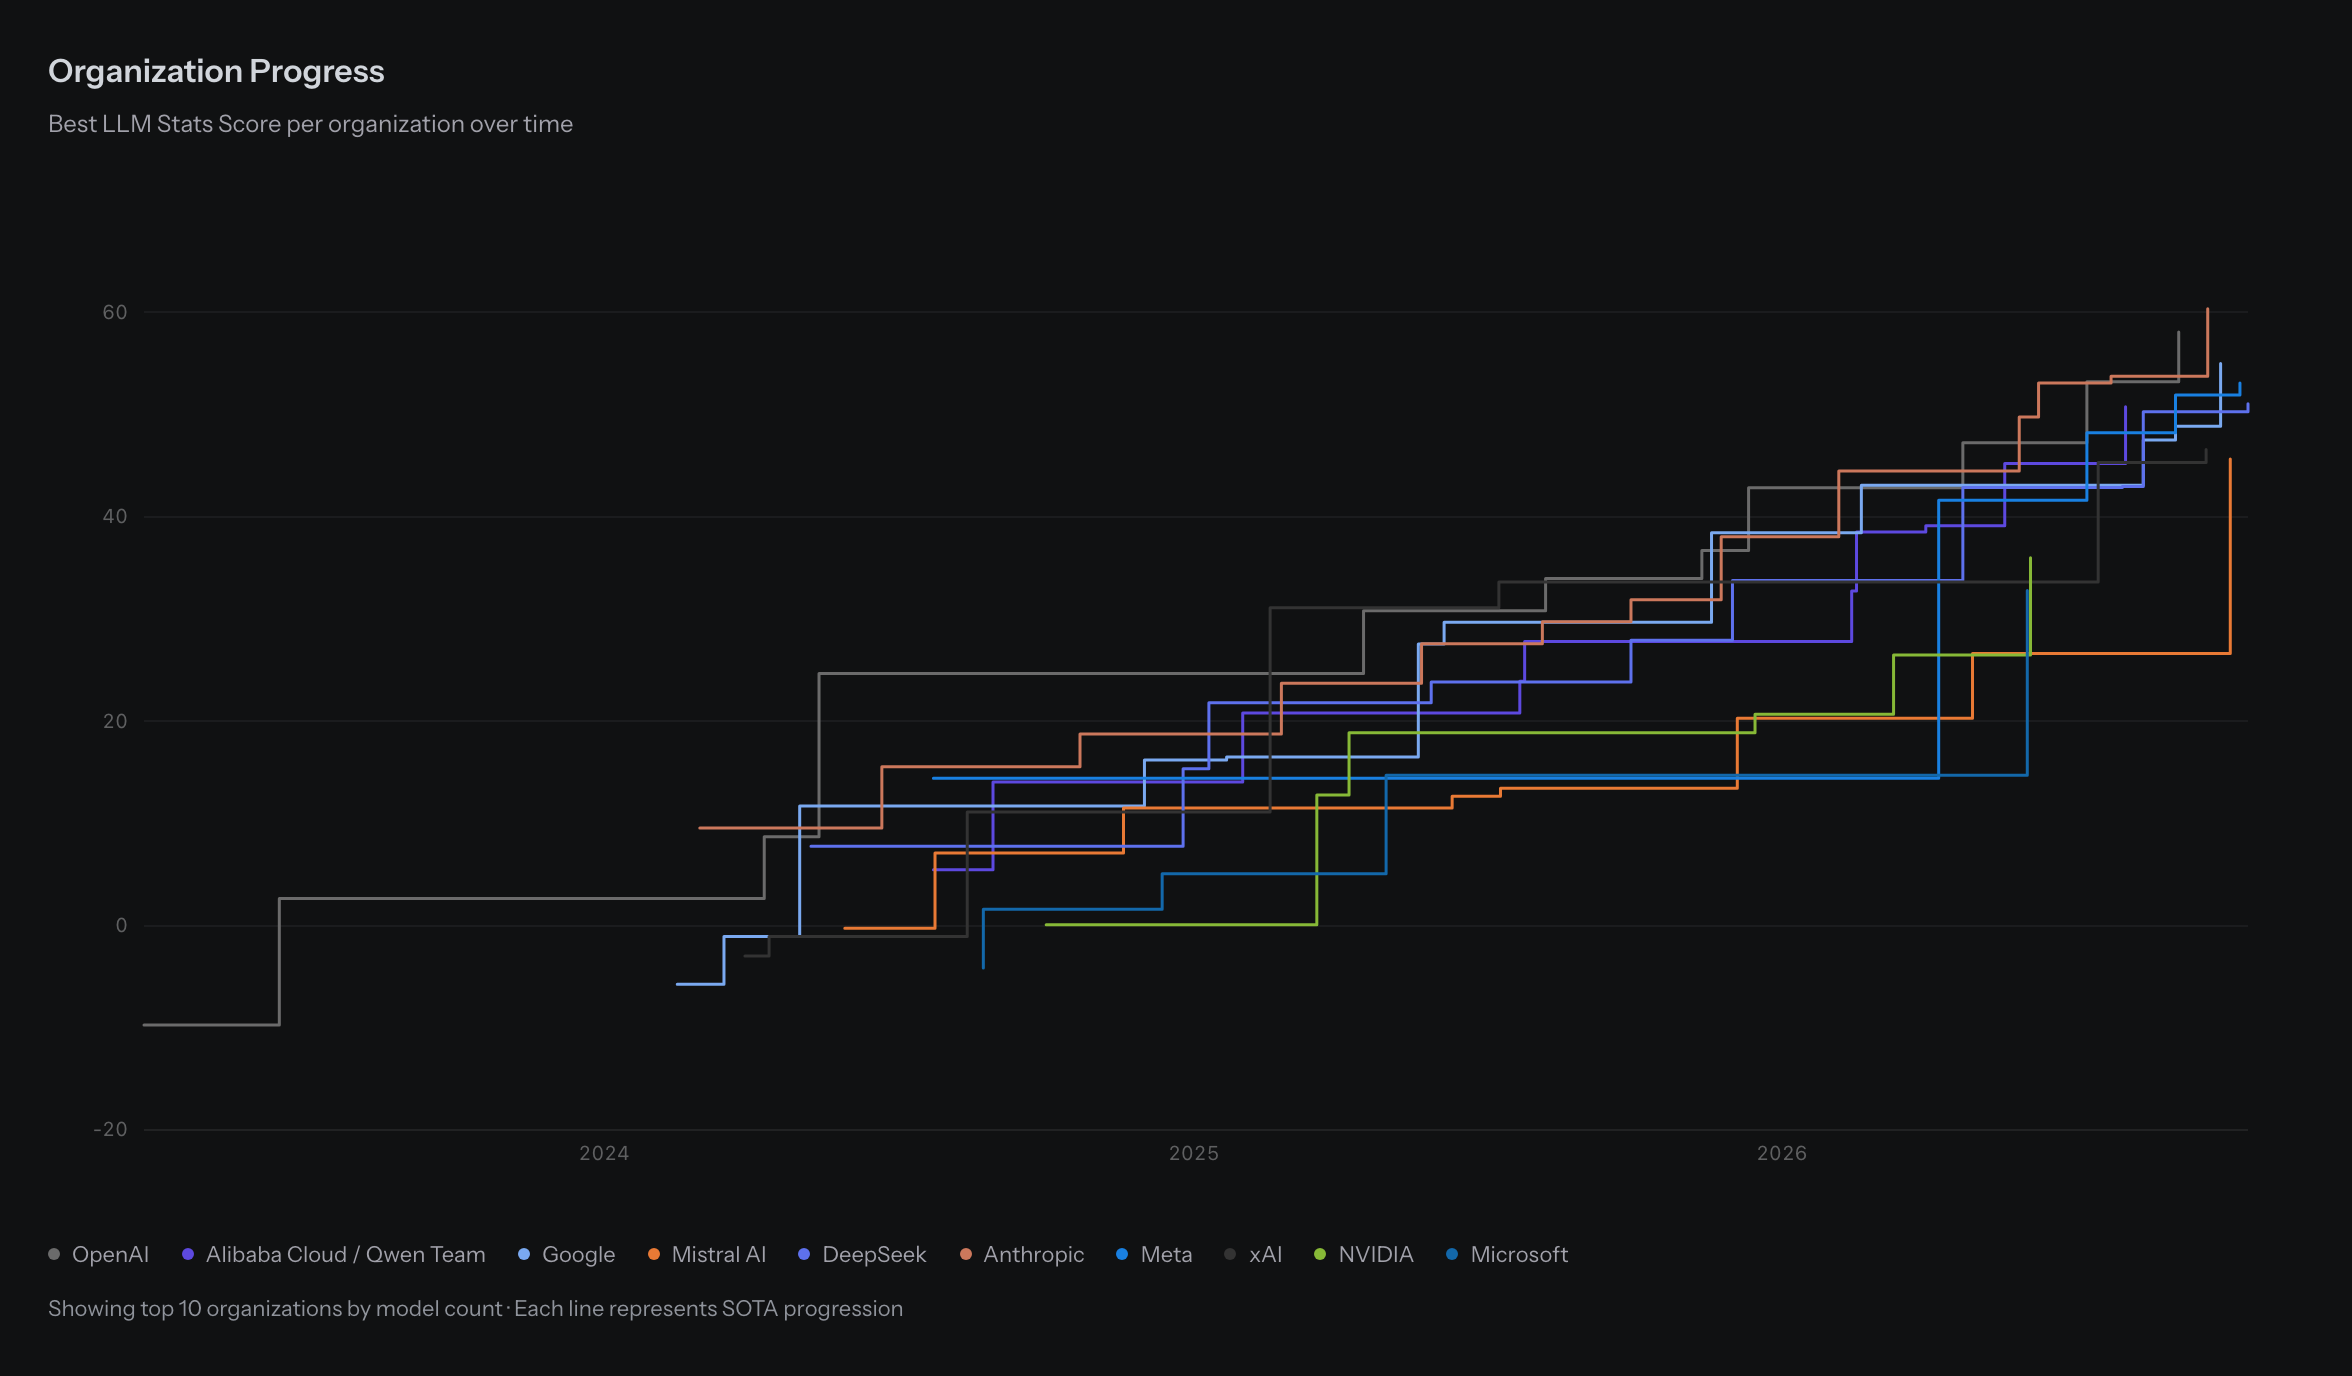
怎么看: 横轴为时间,纵轴为 LLM Stats Score;每条阶梯记录一家组织迄今最好的模型成绩。来源选择的是发布数量最多的 10 个组织。
图表显示: 多家组织在 2026 年进入更高综合分区间,但发布数量前十并不等于能力前十;这张图更适合观察不同组织刷新纪录的节奏。
关键模型 / 数据点:
- 10 个组织:按来源的模型发布数量筛选。
- 2025 年 4 月悬浮位置显示:OpenAI 30.8、xAI 30.1、Anthropic 23.7。
- 同一悬浮位置:Qwen 团队 20.8、Google 16.5、DeepSeek 15.3。
解读边界: 本图按发布量选组织,与 Lab Progress 的能力榜范围不同;悬浮值分别取各曲线邻近记录,日期标题不保证所有数值来自完全相同的一天。
证据依据
- 直接证据:图下注明 Showing top 10 organizations by model count。
- 视觉推断:多条组织曲线在 2026 年进入 40 分以上区域。
- 直接证据:严格限定本图的 悬浮提示 返回各组织历史综合分。
实验室与国家:中美主导供给,累计收录仍在补齐
本组结论: 页面总收录为 414 个,国家图排除 5 个国家字段缺失的模型后统计 409 个,其中美国 216 个、中国 145 个。中美仍是主要发布来源;历史月份会继续回补,累计收录变化需要与实际发布日期分开看。
图 05|中美前沿综合分
原始标题:US vs China Gap
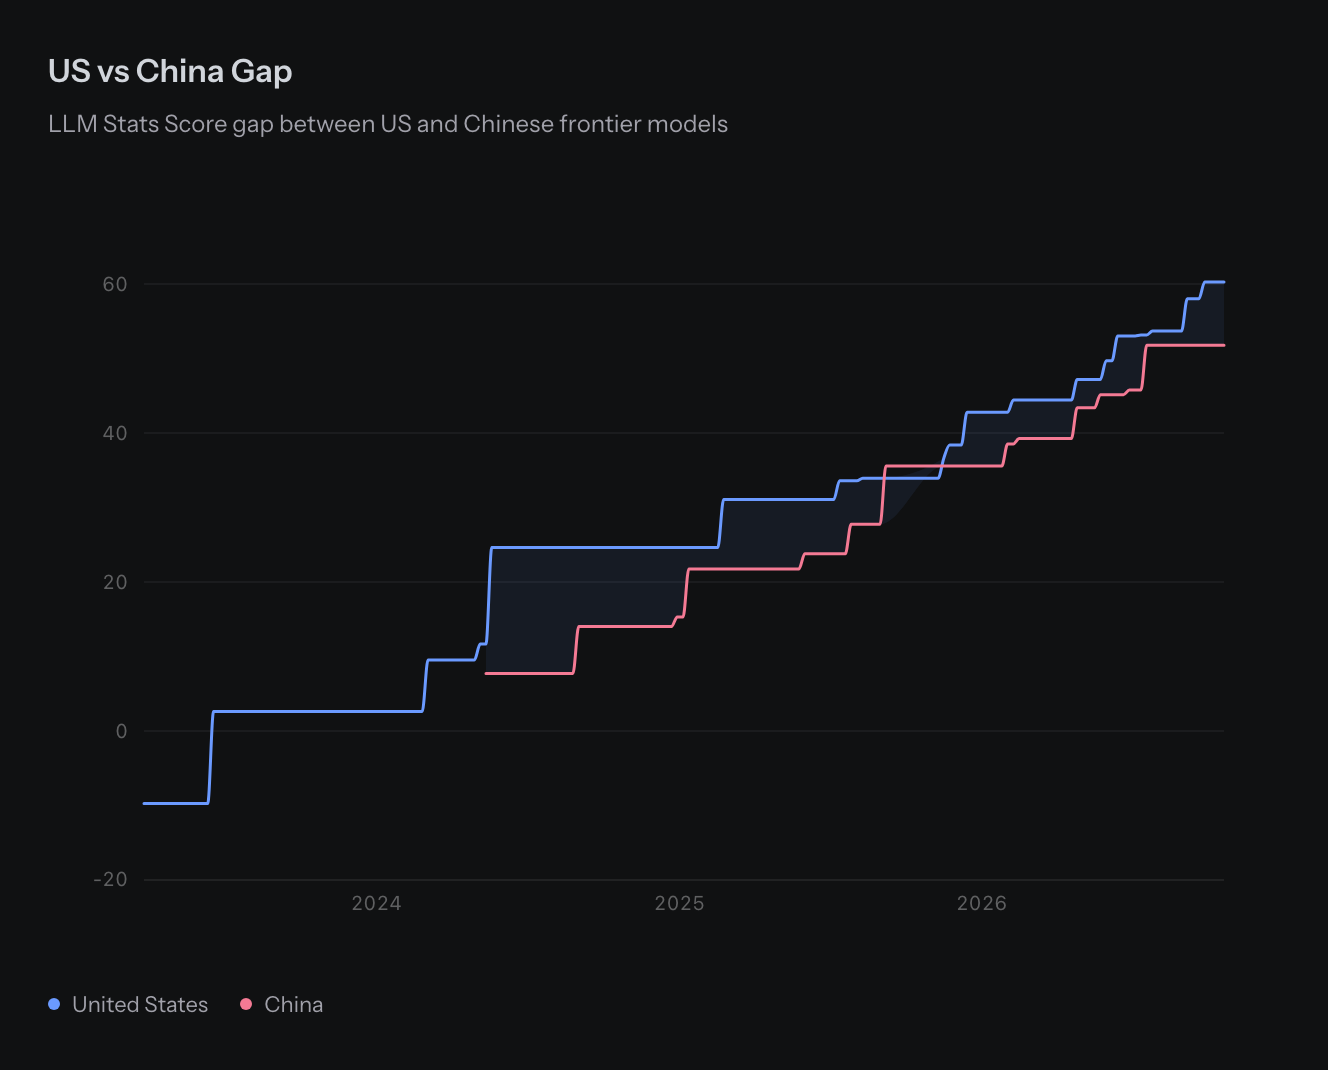
怎么看: 横轴为时间,纵轴为 LLM Stats Score;蓝线与粉线分别表示美国和中国模型的历史最佳值。
图表显示: 美国在图末仍领先,中国曾在中段接近或短暂越过美国前沿;随后美国再度拉开距离。两条曲线都在上升,但前沿差距并非单向缩小。
关键模型 / 数据点:
- 2025 年 1 月悬浮位置显示:美国 24.7,中国 15.3。
- 本图纵轴为 LLM Stats Score,比较两国各自最好模型。
解读边界: 本次未取得最新端点的精确提示值,当前领先方向来自图形;悬浮日期配合各曲线邻近记录,不宜据此计算精确日级追赶间隔。
证据依据
- 直接证据:本图 2025 年 1 月悬浮提示给出美国 24.7、中国 15.3。
- 视觉推断:完整图中美国末端高于中国,中段存在接近与交叉。
图 06|各国累计模型收录
原始标题:Cumulative AI Model Releases
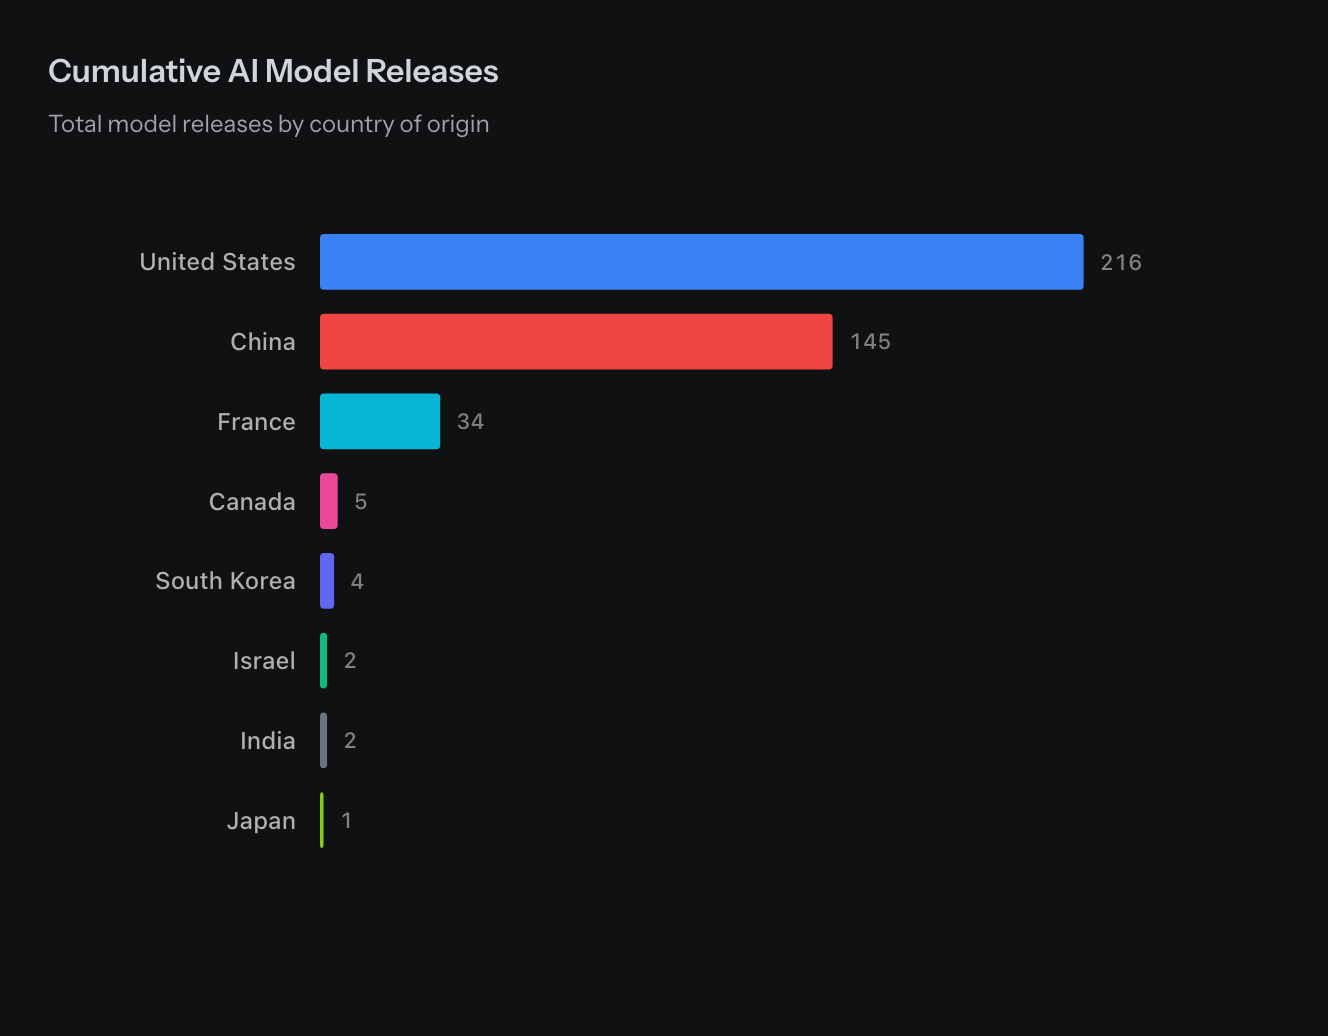
怎么看: 横向条形表示来源收录的各国模型累计发布数量,条形越长表示可见分组中的模型越多。
图表显示: 美国与中国合计 361 个,占国家图可见 409 个模型的约 88%。法国以 34 个居后,其他可见国家规模明显更小。
关键模型 / 数据点:
- 美国:216 个;中国:145 个。
- 法国:34 个;加拿大:5 个;韩国:4 个。
- 以色列、印度各 2 个,日本 1 个;国家标签合计 409 个。
解读边界: 国家图排除缺少 organization_country 的记录;本次公开数据中恰有 5 个此类模型,所以国家合计为 409,而热力图为 414。该分类按来源的组织归属,不能由模型名字自行补国籍。
证据依据
- 直接证据:SVG 与本图 悬浮提示 给出各国计数,标签合计 409。
- 直接证据:公开前端代码对国家字段为空的记录直接跳过;对同一 canonical API 快照按图表规则复算,热力图 414 个中有 5 个缺少国家字段。
图 07|月度模型发布热力图
原始标题:The Release Heatmap
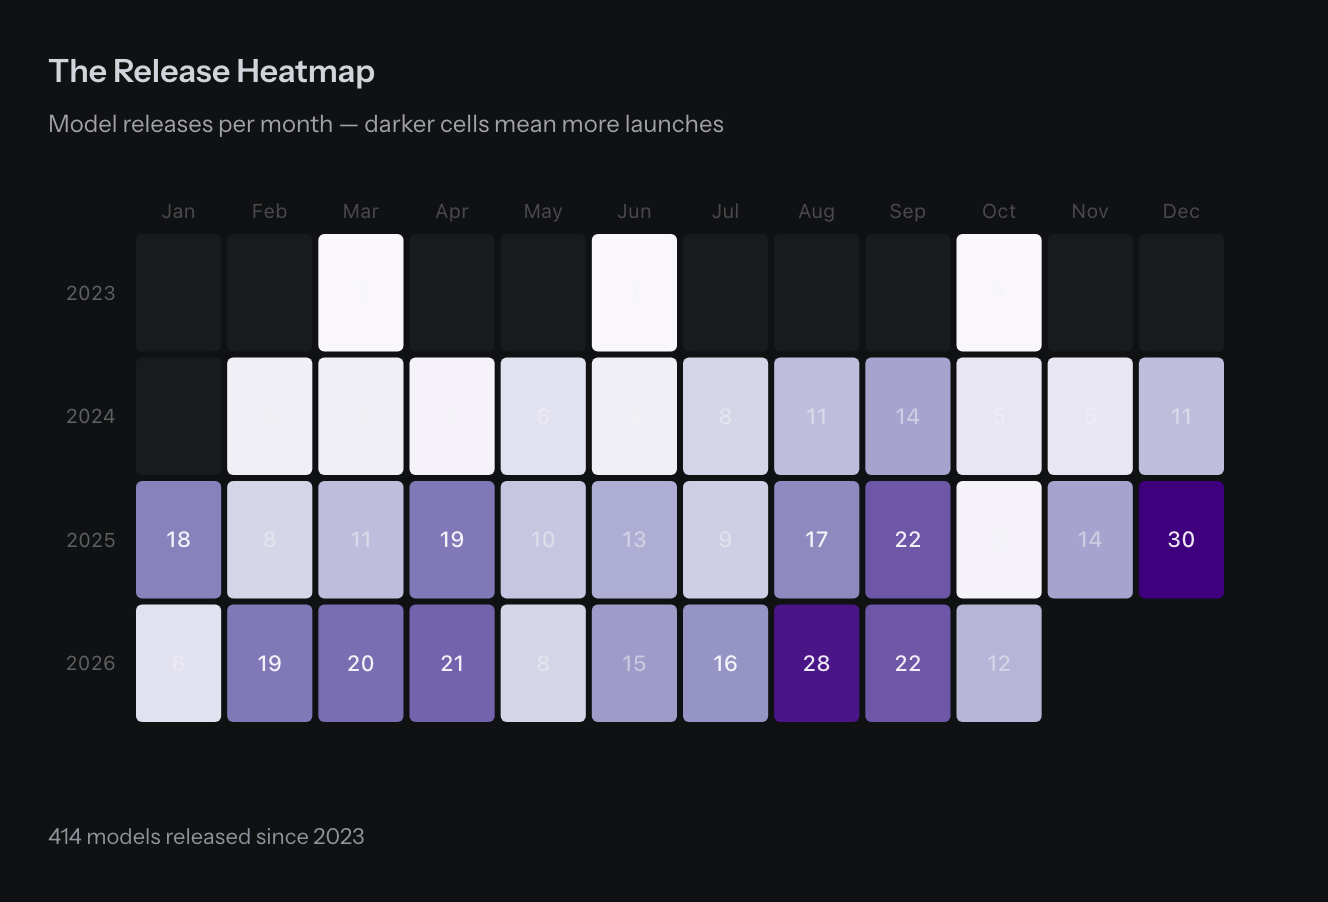
怎么看: 行表示年份,列表示月份;格子数字是当月收录的发布量,颜色越深表示数量越大。
图表显示: 2026 年 8 月以 28 个构成近期发布高点,9 月为 22 个,10 月截至抓取时为 12 个。历史月份会继续补录,累计收录变化不能全算作本月新发布。
关键模型 / 数据点:
- 来源总量:自 2023 年以来 414 个。
- 2026 年 7、8、9 月:16、28、22 个。
- 2026 年 10 月截至 10 月 20 日:12 个;2025 年 12 月为 30 个。
解读边界: 10 月与 2026 全年尚未结束;空白未来月份不代表零发布,历史数值也可能随来源补录而变化。
证据依据
- 直接证据:图卡标注 414 models released since 2023,热力格列出逐月数量。
- 直接证据:本图严格 悬浮提示 核对了 2026 年 7–9 月的 16、28、22 个;10 月 12 来自 SVG 明确标注。
图 08|国家发布份额的演化
原始标题:Model Releases by Country
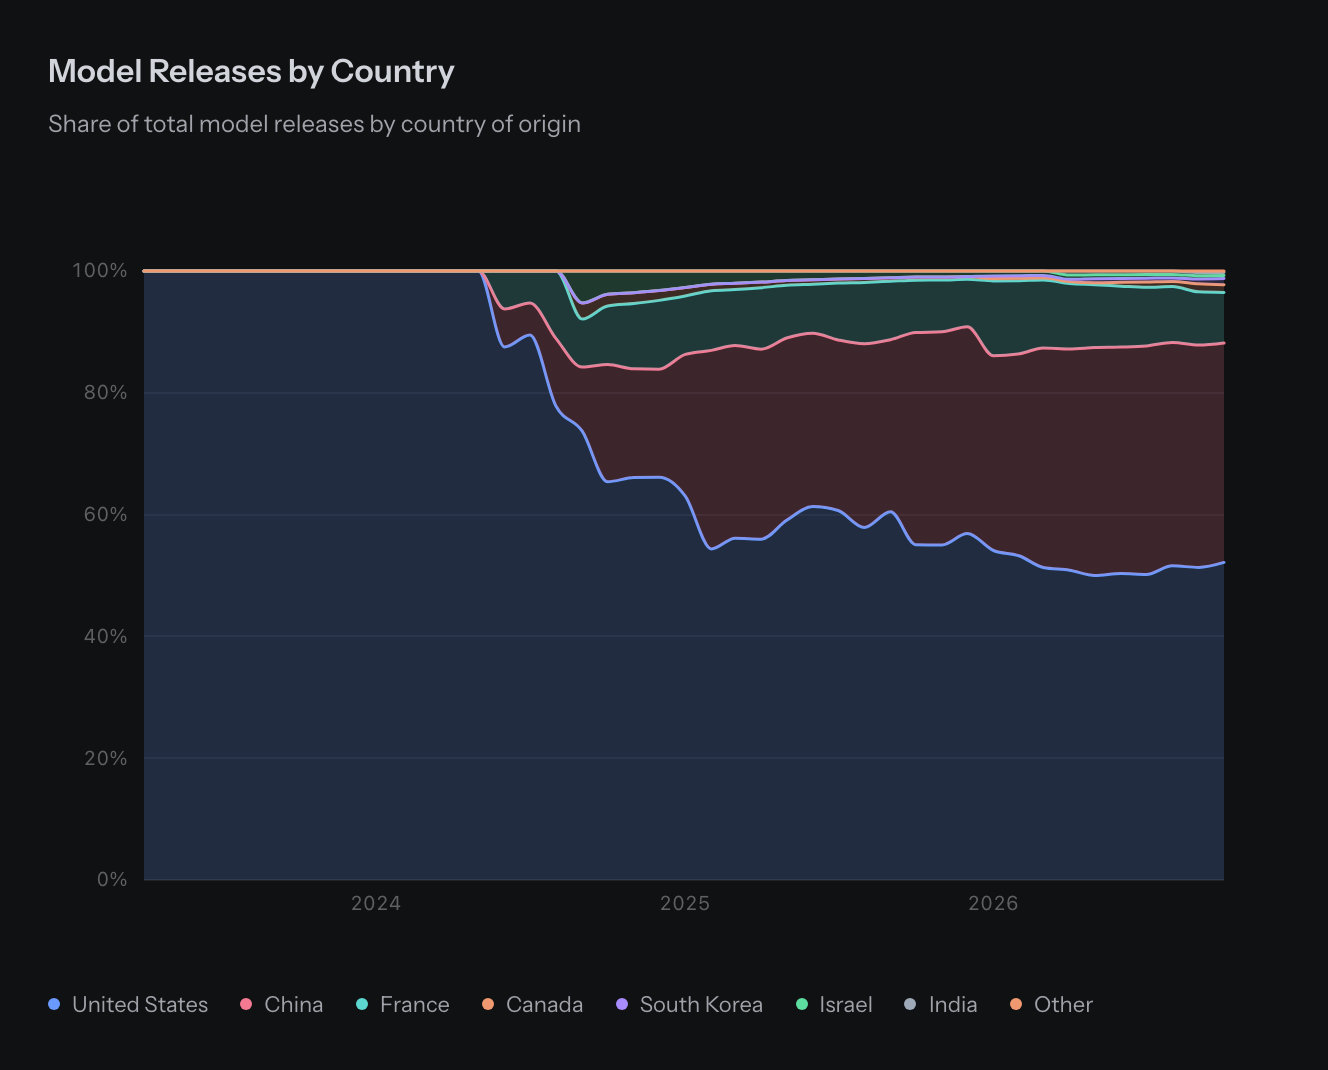
怎么看: 堆叠面积显示各国在累计收录模型中的份额;每一时点合计为 100%,面积宽度不表示当月发布量。
图表显示: 美国从早期几乎独占逐渐变为约一半,中国成为稳定的第二大来源。累计份额同时受早期收录基数和后续补录影响。
关键模型 / 数据点:
- 2023 年 4 月提示值:美国 100%。
- 2025 年 1 月悬浮位置:美国 63%、中国 23%、法国 10%。
- 同一悬浮位置:以色列 3%、加拿大 1%,其余显示为 0%。
解读边界: 累计份额不能代替当月发布份额;国家范围、未知归属与补录会影响分母,不与相邻总量图擅自拼接。
证据依据
- 直接证据:图题说明 Share of total model releases by country of origin。
- 视觉推断:后期美国区域约占一半,中国区域明显扩大。
- 直接证据:本图 悬浮提示 列出两个历史位置的各国累计份额。
图 09|主要实验室的累计发布轨迹
原始标题:Cumulative Releases by Lab
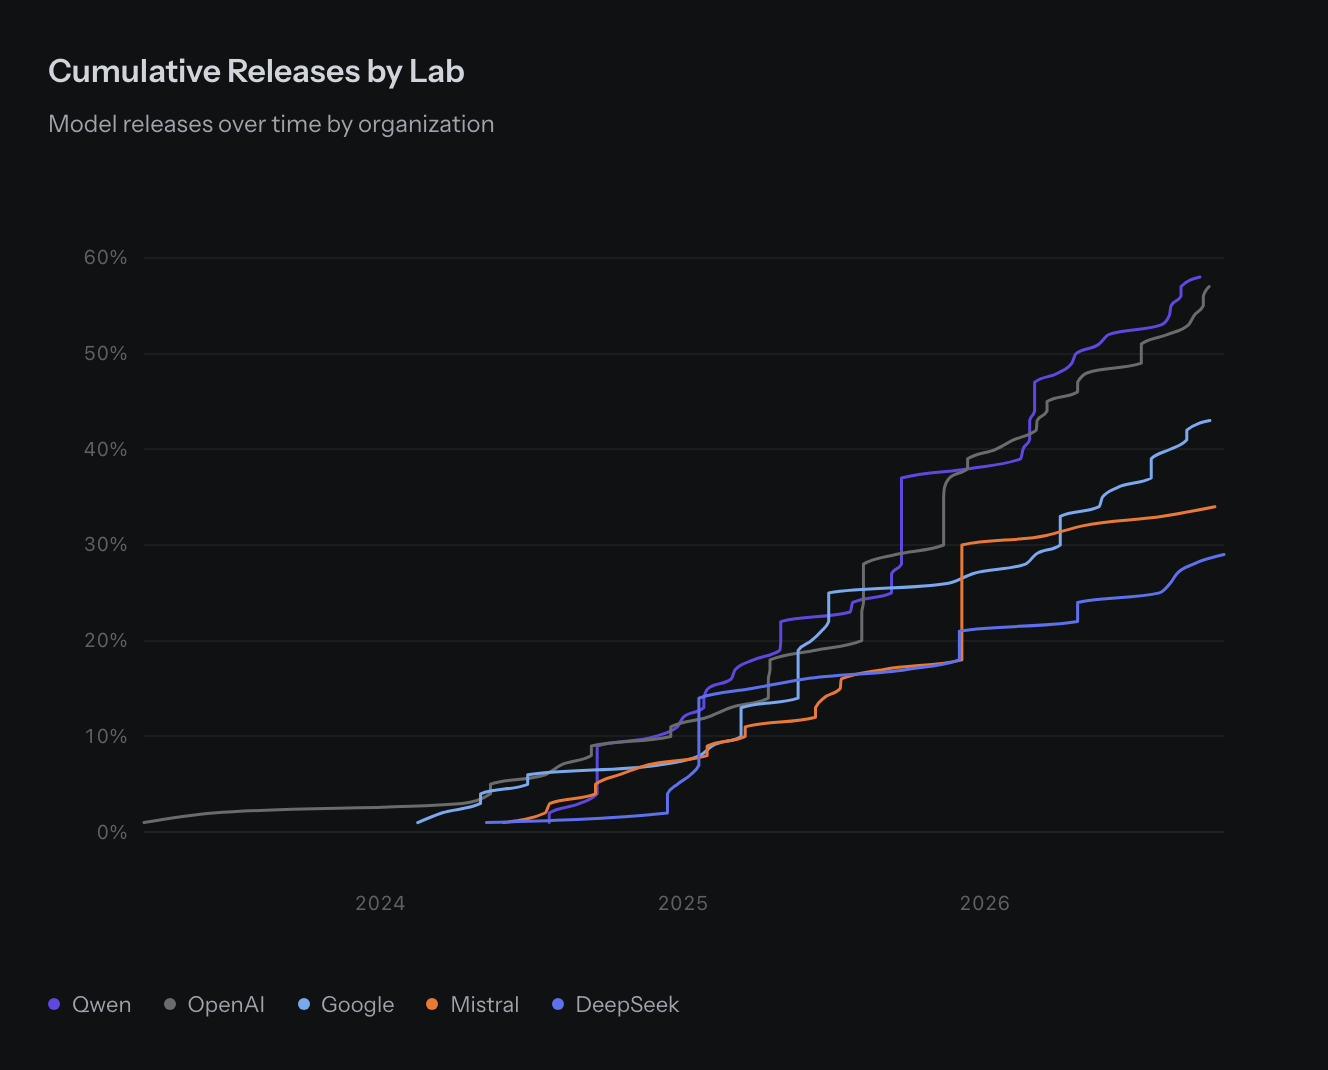
怎么看: 横轴为时间,五条线分别统计 Qwen、OpenAI、Google、Mistral 和 DeepSeek 的累计模型发布数量。源站纵轴误附百分号,底层数值仍是个数。
图表显示: 按该图公开代码和同一数据快照复算,Qwen 58 个、OpenAI 57 个,发布数量接近;Google、Mistral 与 DeepSeek 依次为 43、34、29 个。数量排序不能解释为能力排序。
关键模型 / 数据点:
- 按同图规则复算当前累计数:Qwen 58,OpenAI 57。
- Google 43,Mistral 34,DeepSeek 29。
- 图内 2025 年 1 月悬浮位置:Qwen 12、OpenAI 11、Google 8、Mistral 8、DeepSeek 5。
解读边界: 公开绘图代码逐模型累加计数,却沿用了通用折线图的百分比轴格式,属于显示单位错误;没有除以总量,不应将 58 读成 58% 的市场份额。
证据依据
- 直接证据:公开代码 CumulativeModelsPerLab 对每家组织执行 value: ++n,随后未指定 yFormat;通用 renderLineChart 默认把纵轴值附加百分号。
- 直接证据:对来源相同 canonical API 按组织及有效发布日期筛选并复算,前五为 58、57、43、34、29。
- 直接证据:本图 悬浮提示 提供历史计数,不含百分比。
开放模型:发布占比与能力前沿需要分开看
本组结论: 完整第三季度开放模型占 45%,第四季度目前占 42%;综合分图中闭源在末端仍领先。发布数量与能力前沿是两个维度,开放模型持续进步也不意味着前沿差距单调缩小。
图 10|开放与专有模型的发布占比
原始标题:Open vs Proprietary Releases
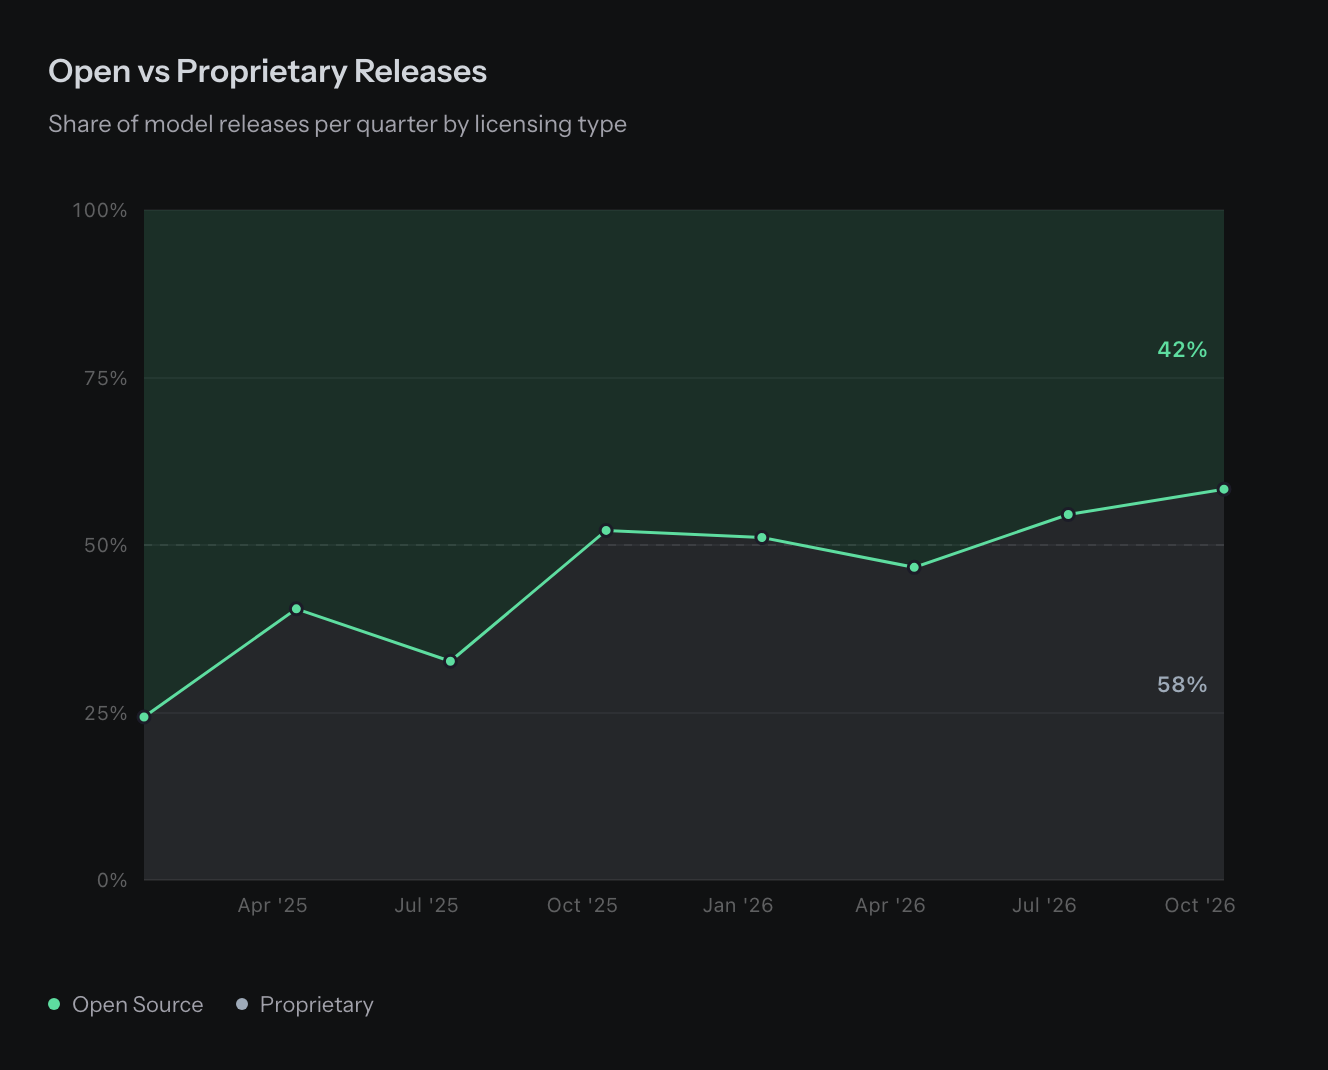
怎么看: 每个时点代表一个季度。上方绿色面积是开放模型,下方灰色面积是专有模型;两类合计 100%,边界线的纵坐标对应下方区域的份额。
图表显示: 本期完整第三季度共有 66 次发布,开放模型 30 个、占 45%;第四季度截至抓取时共有 12 次,开放 5 个、占 42%。目前两季均由专有模型略占多数,但第四季度样本尚小。
关键模型 / 数据点:
- 2026 年第二季度:45 次发布,开放 24 个(53%)、专有 21 个(47%)。
- 第三季度:66 次发布,开放 30 个(45%)、专有 36 个(55%)。
- 第四季度截至抓取时:12 次发布,开放 5 个(42%)、专有 7 个(58%)。
解读边界: 当前第四季度只覆盖截至 10 月 20 日的收录;Open Source 沿用来源分类,不保证每个模型都满足完整开源定义。
证据依据
- 直接证据:本图严格 悬浮提示 给出 2026 年各季度总数、分类数量与比例。
- 直接证据:图末上方绿色区域标注开放 42%,下方灰色区域标注专有 58%。
图 11|开放权重与闭源的综合分前沿
原始标题:The Closing Gap
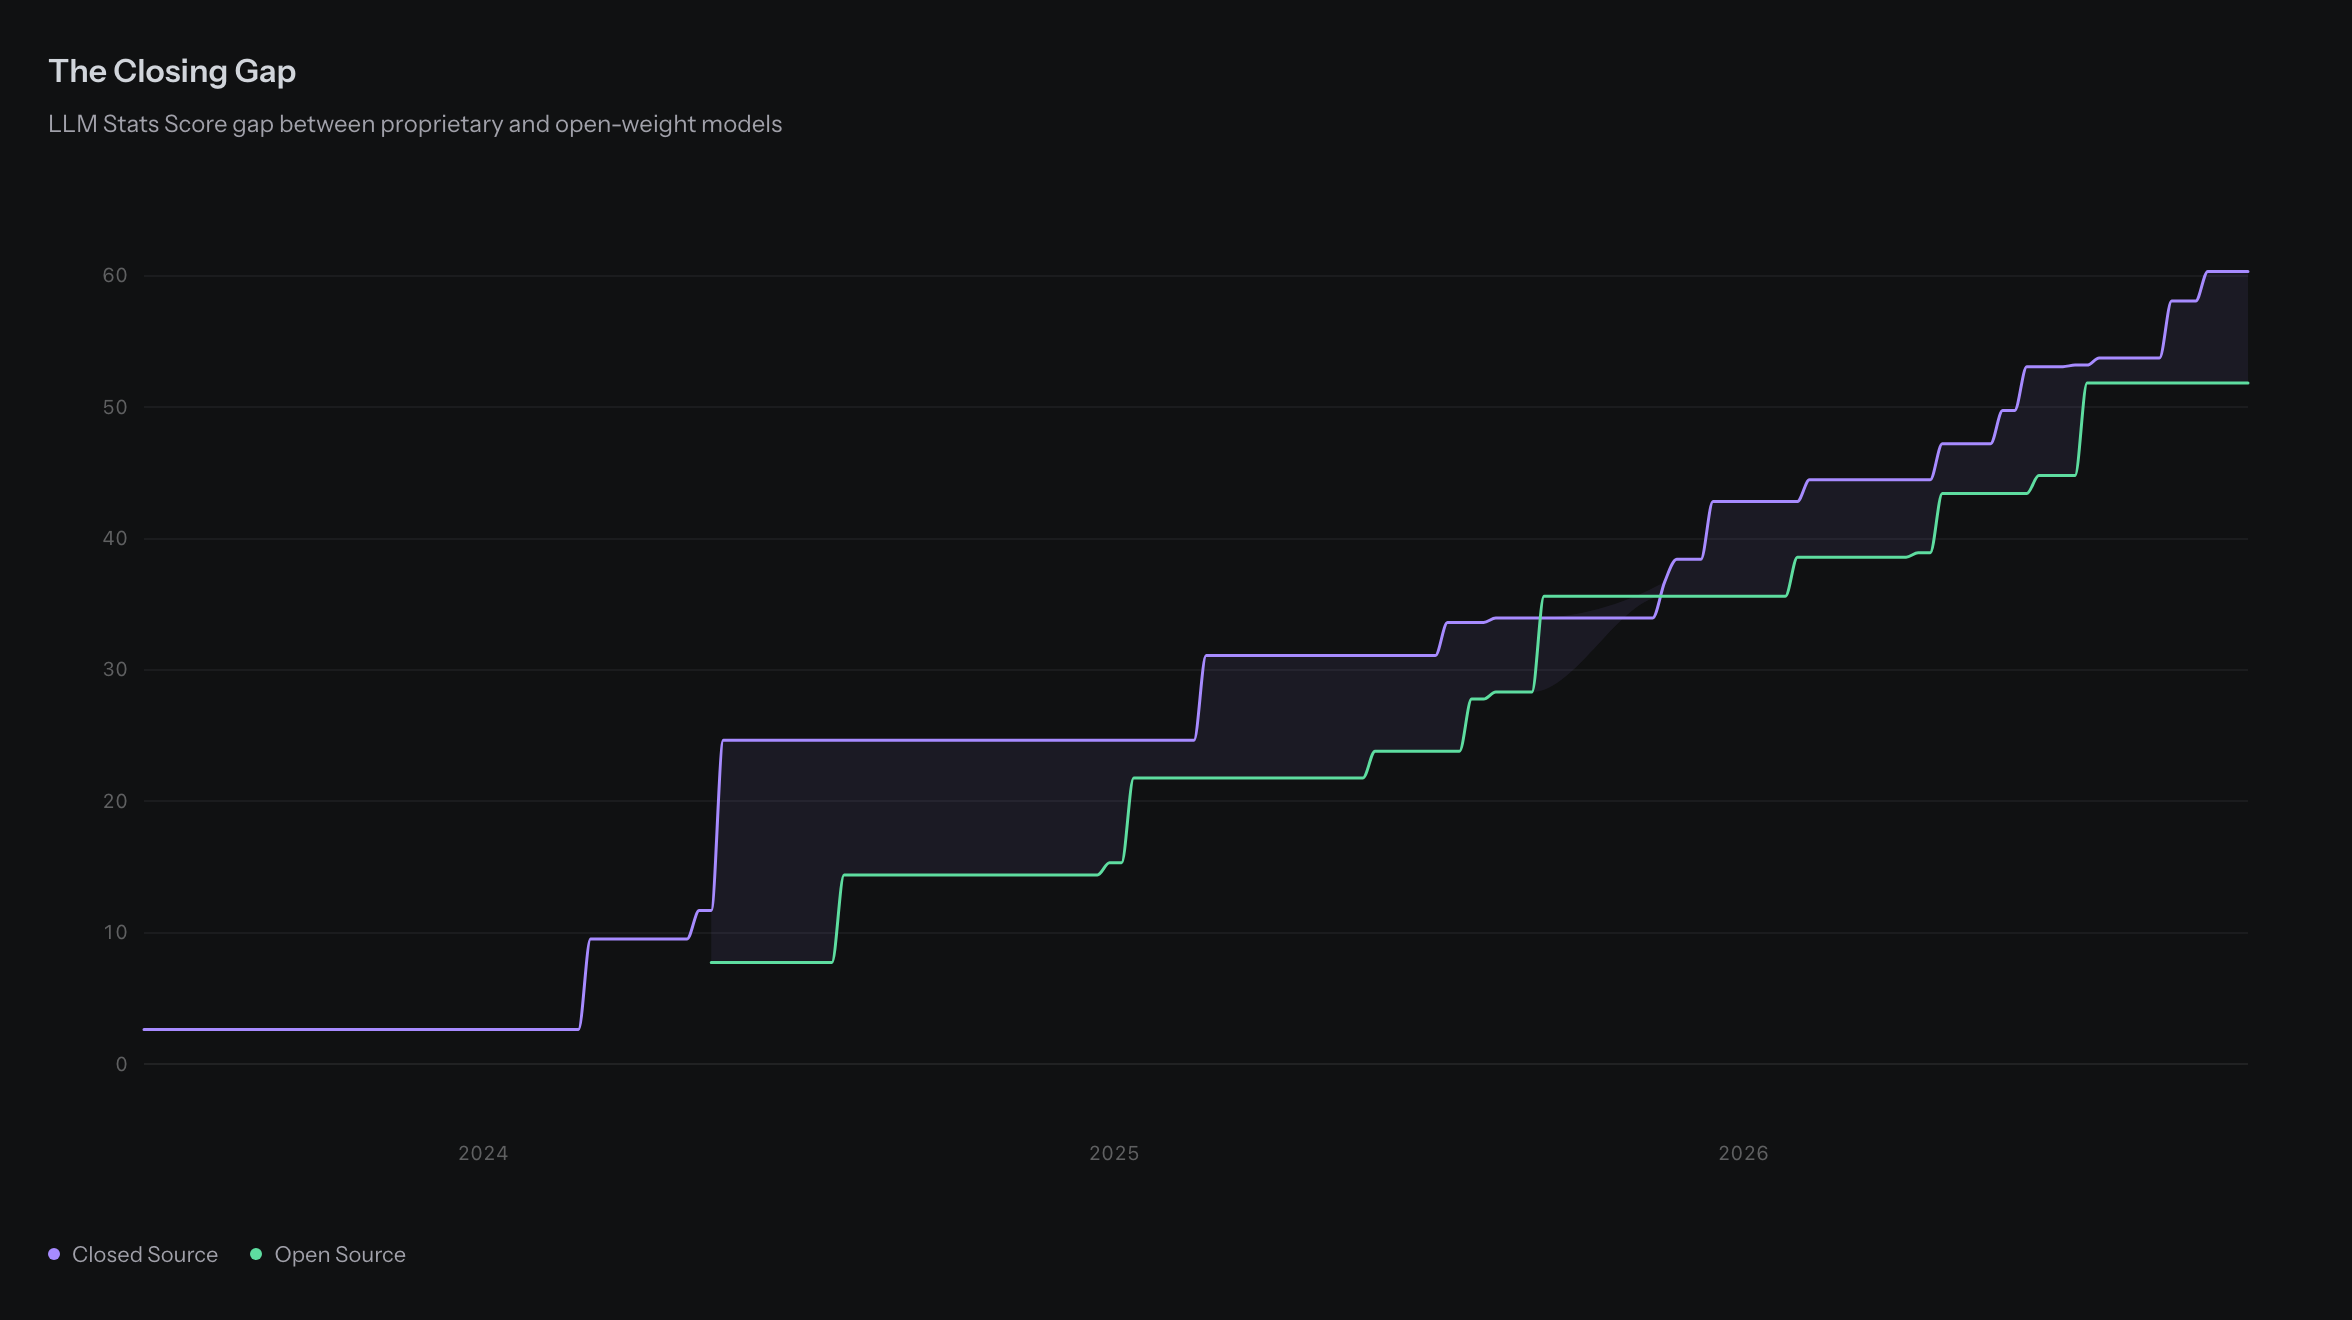
怎么看: 紫色与绿色阶梯分别记录闭源和开放权重模型的历史最高 LLM Stats Score;两线间距表示前沿差距。
图表显示: 开放权重曲线持续向上,但图末闭源再次抬升,开放曲线暂时持平。追赶过程包含阶段性接近和重新拉开,不能把图名理解为差距始终缩小。
关键模型 / 数据点:
- 2025 年 2 月悬浮位置显示:闭源 24.7、开放权重 21.8。
- 末端闭源仍高于开放权重;本次未取得最新端点的精确提示值。
解读边界: 比较的是两类最好模型,不能代表均值;历史悬浮值分别取曲线邻近记录,不构成精确日级差距,本期综合分也不能直接与 8 月快照求增长率。
证据依据
- 直接证据:图例区分 Closed Source 和 Open Source。
- 视觉推断:末端闭源阶梯继续上升,开放权重阶梯维持平台,垂直间距扩大。
- 直接证据:本图严格 悬浮提示 在 2025 年 2 月悬浮位置显示闭源 24.7、开放 21.8。
图 12|中美开放权重与闭源的四条前沿
原始标题:Open Weights Race: US vs China
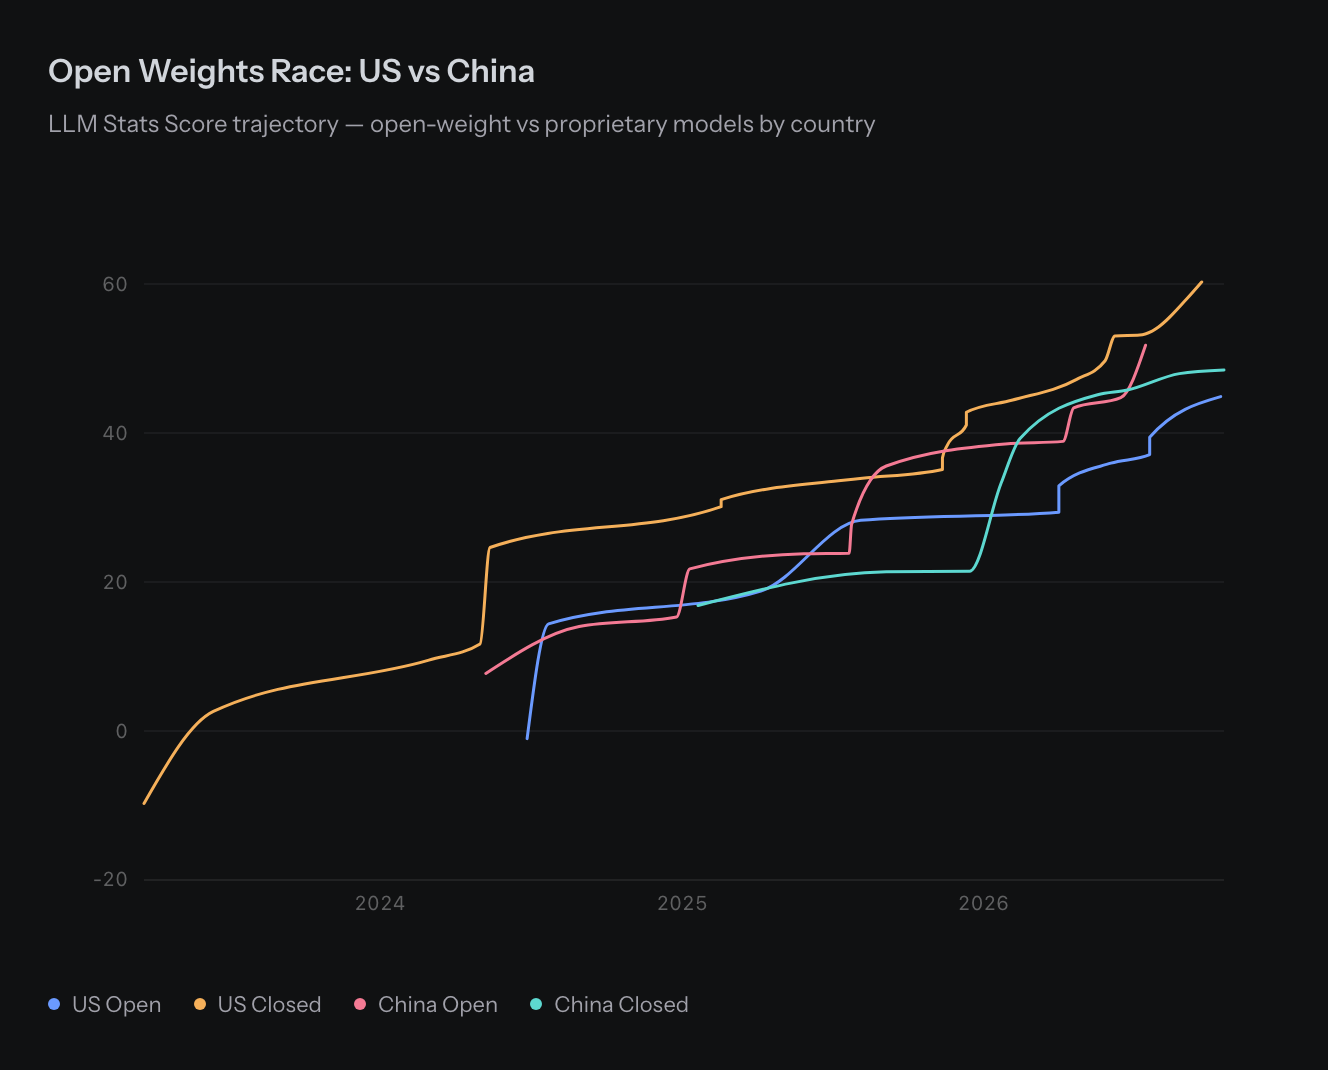
怎么看: 四条曲线分别表示美国开放、美国闭源、中国开放和中国闭源模型的综合分前沿,横轴为时间。
图表显示: 图末美国闭源最高,中国开放高于中国闭源与美国开放。国家归属与开放方式共同影响分布,仅用“中美”或“开放闭源”单一维度都会省略差异。
关键模型 / 数据点:
- 2025 年 4 月悬浮位置:美国闭源 30.1,中国开放 21.8。
- 同一悬浮位置:美国开放 18.9,中国闭源 16.9。
解读边界: 模型归属采用来源定义;平滑线不代表两次发布间能力持续改善,悬浮日期也可能配合各曲线的邻近记录,不能用来计算精确日级差距。
证据依据
- 直接证据:图例列出四类国家与开放状态组合。
- 视觉推断:末端美国闭源处于最高位置,中国开放位于另外两类之上。
- 直接证据:本图严格 悬浮提示 在 2025 年 4 月悬浮位置列出四条轨迹的数值。
模型形态:多模态普及,MoE 集中于开放高分区
本组结论: 第四季度目前 12 个模型中有 11 个支持视觉或多模态;开放权重样本的高分区则以 MoE 为主。这分别描述功能覆盖与架构分布,不能据此证明某种架构或标签单独带来了分数提升。
图 13|新模型的多模态覆盖
原始标题:The Multimodal Shift
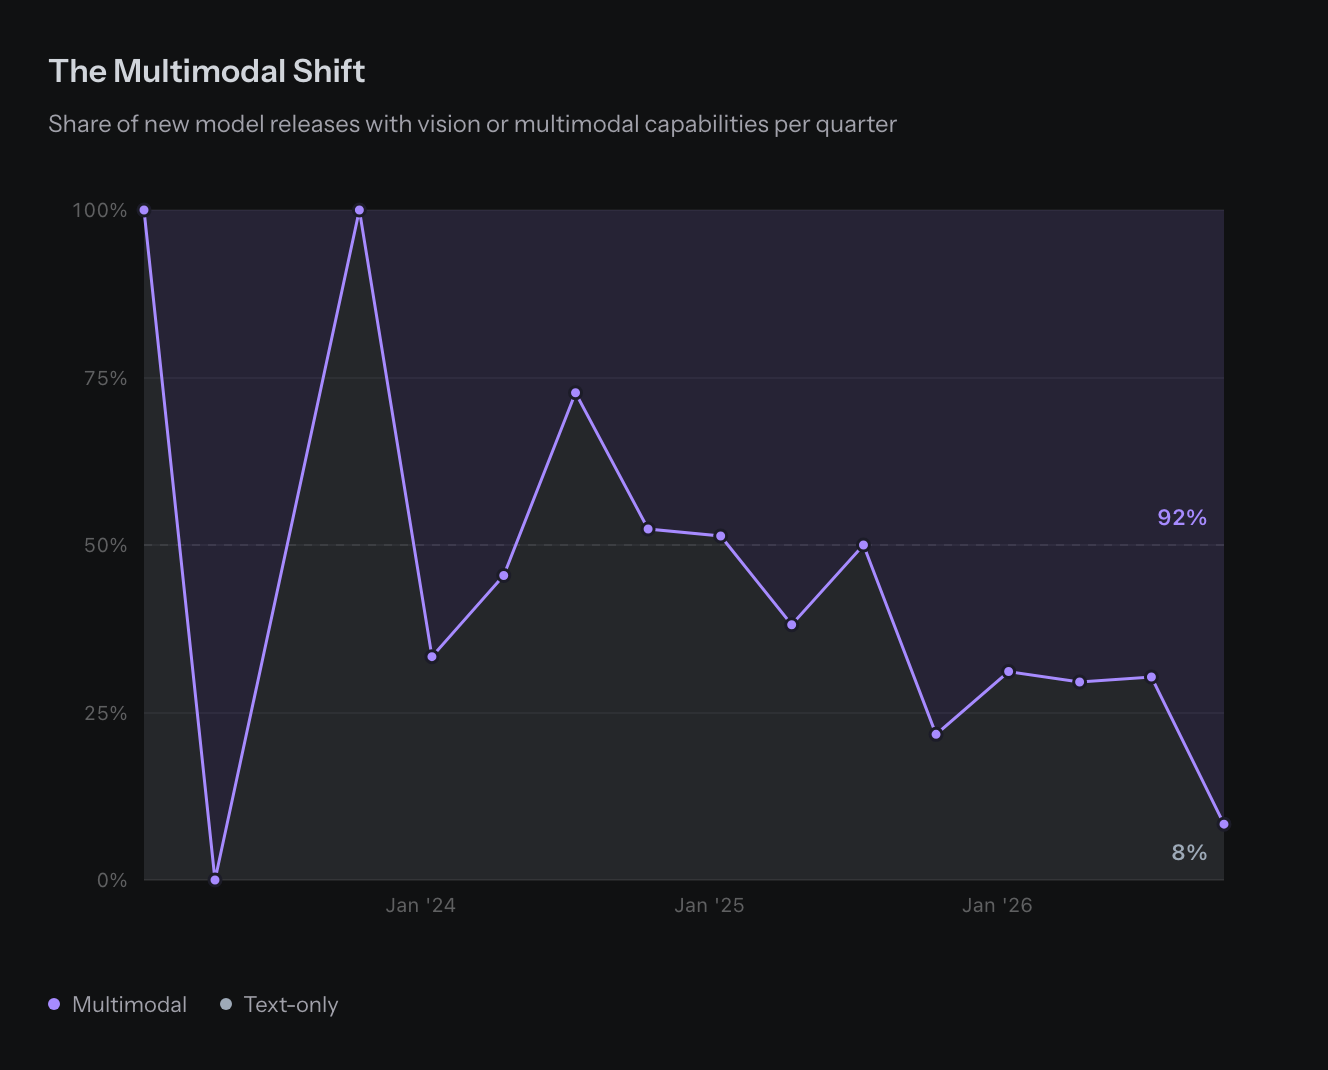
怎么看: 横轴按季度排列,上方紫色面积表示多模态,下方灰色表示纯文本;边界线越低表示多模态面积越大。
图表显示: 2026 年第三季度的多模态模型为 46/66,约占 70%;第四季度目前为 11/12,约占 92%。近期新模型普遍支持视觉或多模态,但更高占比不等于相关任务质量同步提高。
关键模型 / 数据点:
- 2025 年第四季度:多模态 36/46,78%。
- 2026 年第三季度:多模态 46/66,70%。
- 2026 年第四季度截至抓取时:多模态 11/12,92%;纯文本 1/12,8%。
解读边界: 第四季度只覆盖截至抓取日期的发布;多模态标签可能只表示支持某类输入,不等于各种图像、音频和视频能力都已具备。
证据依据
- 直接证据:本图严格 悬浮提示 提供季度总模型数、多模态数量及占比。
- 直接证据:图末紫色区域标注 92%,对应多模态,上方面积越大则其占比越高。
图 14|开放模型中的 MoE 采用
原始标题:MoE Adoption Over Time
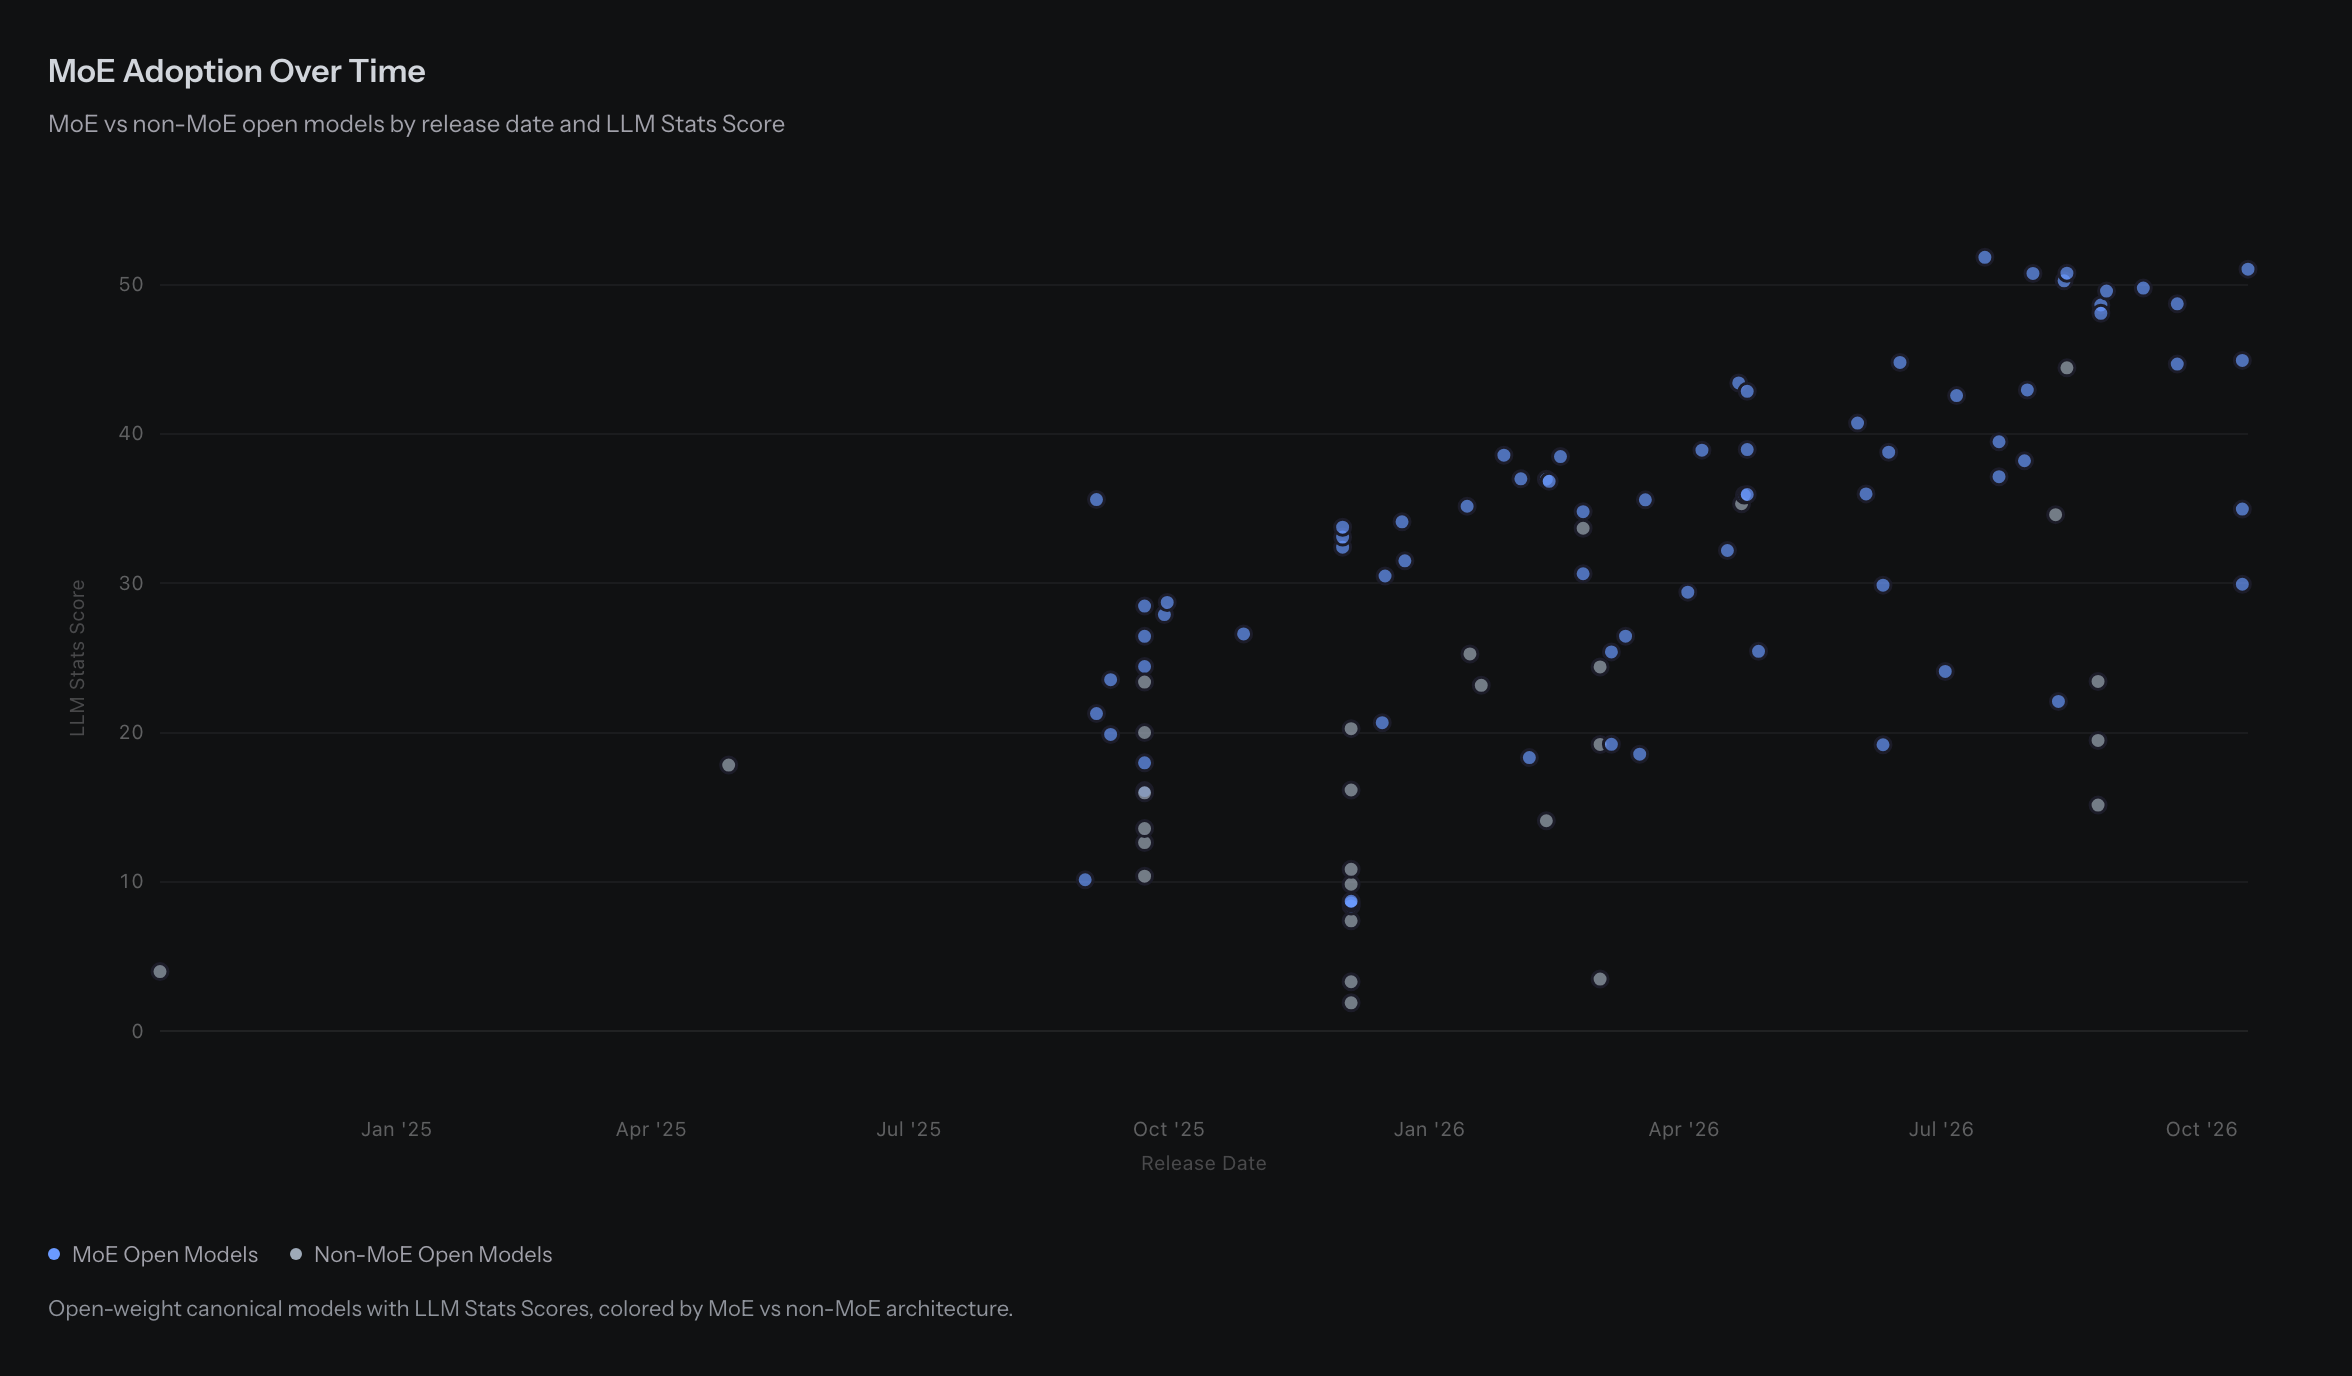
怎么看: 横轴为发布日期,纵轴为 LLM Stats Score;蓝点为 MoE,灰点为非 MoE。样本限于有综合分的开放权重 canonical 模型。
图表显示: 高分区的可见点主要为 MoE,但同为 MoE 的模型也横跨很宽的分数范围。架构标签与高分同时出现,不能单独证明 MoE 导致能力优势。
关键模型 / 数据点:
- Kimi K3:2026-07-16 发布,综合分 51.8。
- Qwen3.8 Max:2026-08-02 发布,50.8;GLM-5.3:08-14 发布,50.8。
- DeepSeek-V4.1-Flash:2026-09-10 发布,49.8。
- DeepSeek-V4.1-Flash-1017:2026-10-17 发布,51.0。
解读边界: 这不是全体模型的架构普查;缺少评分或架构标签的模型可能被排除,总参数量与单次激活计算量也需另行区分。
证据依据
- 直接证据:图下注明开放权重 canonical 模型及 MoE/non-MoE 分类。
- 视觉推断:可见高分区以蓝色 MoE 点为主,同类点仍存在明显纵向分散。
- 直接证据:本图严格 悬浮提示 给出上述模型名称、发布日期和综合分。
价格与价值
本组结论: 固定能力门槛的最低 API 价格继续沿历史曲线下降,但模型之间的价格效率差异仍大。综合能力、编程与人类偏好给出不同前沿;选型应先确定目标与价格口径,再比较候选,不能只看最高分或最低报价。
图 15|各国模型 API 价格分布
原始标题:Price by Country
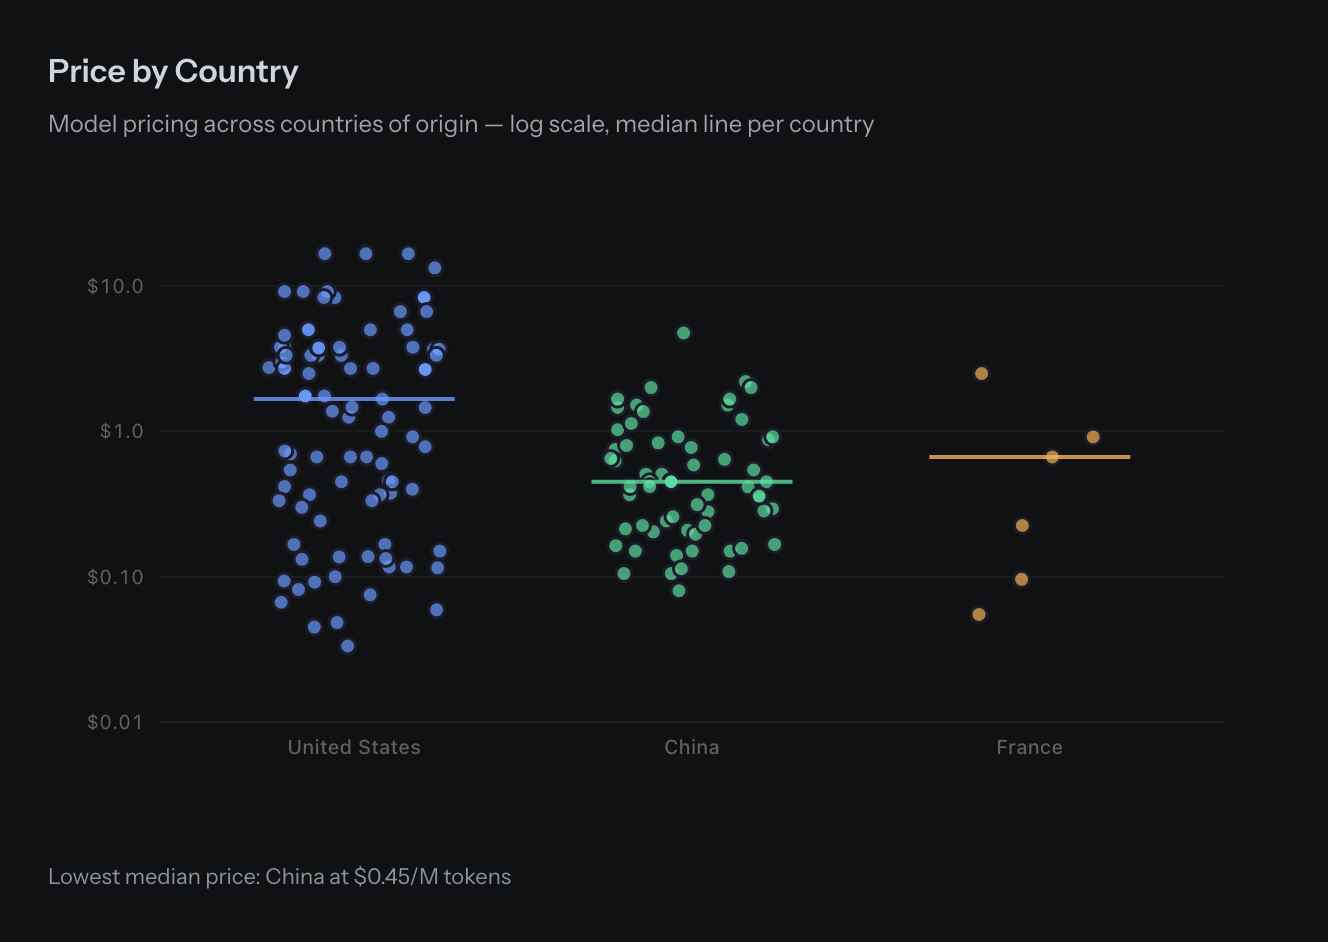
怎么看: 横轴按模型所属组织的国家分组,纵轴是每百万 token 的价格,采用对数刻度;每个点代表模型,横线表示组内中位数。
图表显示: 中国样本的价格中位数最低,美国样本的定价跨度更宽。这个差异说明当前可购买模型的组合不同,并不能推出同等能力模型的国别溢价。
关键模型 / 数据点:
- 中国:价格中位数为每百万 token 0.45 美元。
- DeepSeek-V4-Flash-0731:每百万 token 0.08 美元,综合分 43.0。
- Kimi K3:每百万 token 4.8 美元,综合分 51.8。
- Claude Sonnet 5.5:每百万 token 3.3 美元,综合分 58.3。
解读边界: 图中只纳入价格、综合分与国家信息齐全的模型,并要求每国至少 3 个样本;价格不是部署成本,也未控制能力和发布日期。
证据依据
- 直接证据:图卡标注 Lowest median price: China at $0.45/M tokens。
- 视觉推断:美国点云覆盖的价格范围宽于中国与法国,三个国家的样本数量明显不均衡。
- 直接证据:从本图的悬浮提示核对上述模型、时点及数值。
图 16|达到不同能力门槛的单位得分价格
原始标题:The Price of Intelligence
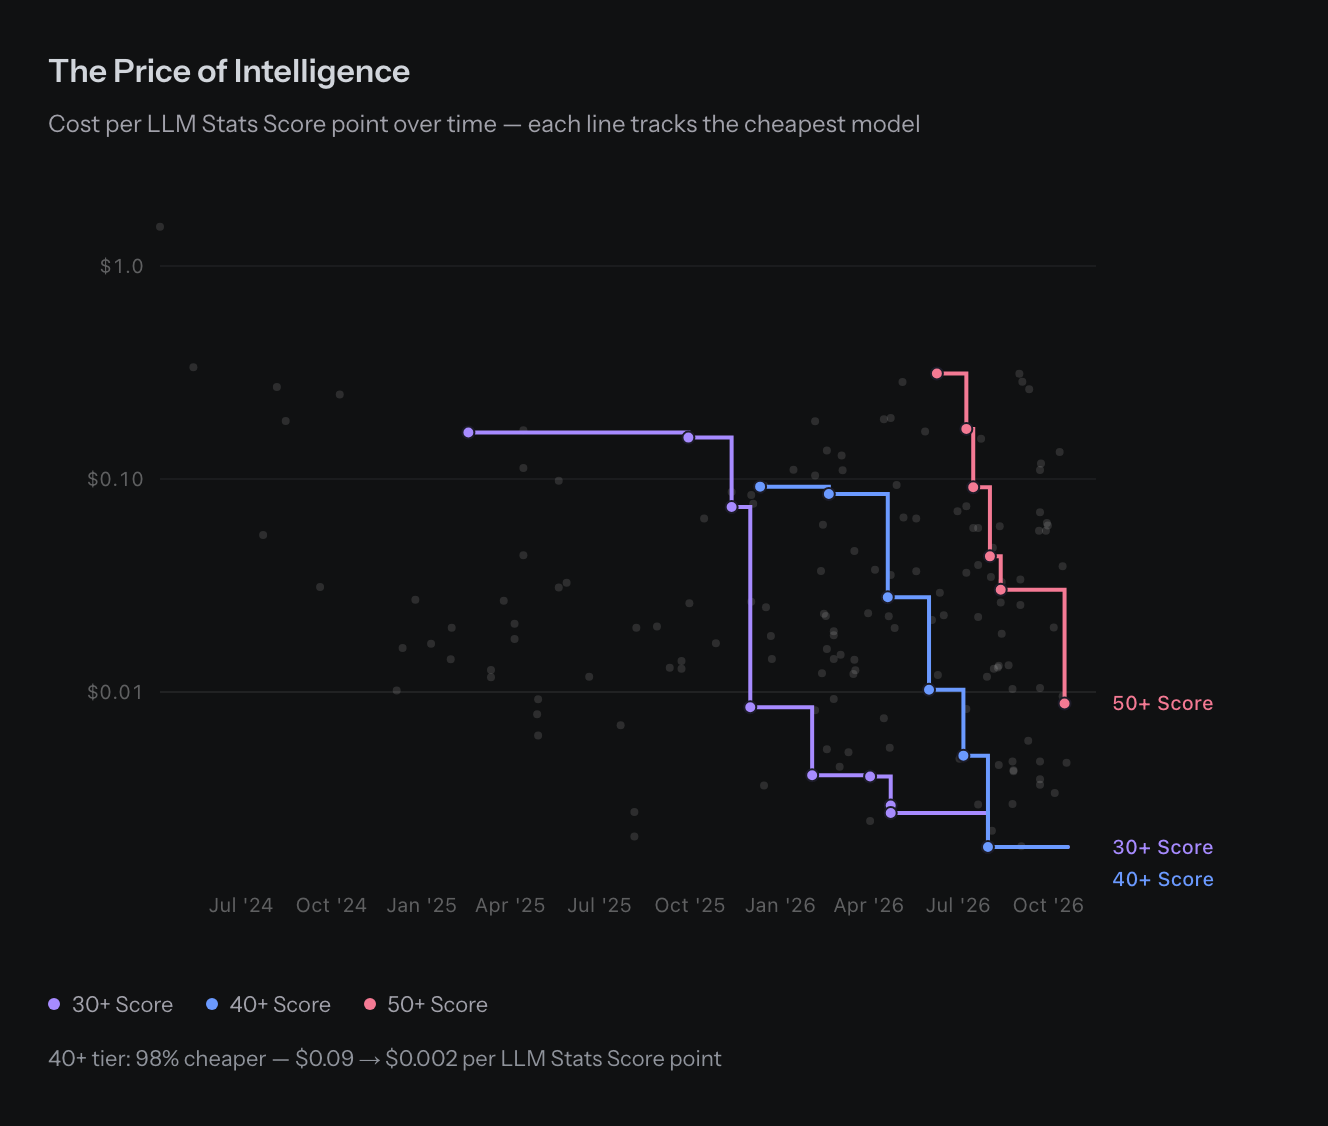
怎么看: 横轴是模型发布日期,纵轴是混合 API 价格除以 LLM Stats Score,使用对数刻度;阶梯线分别跟踪达到 30、40、50 分门槛的历史最低比值。
图表显示: 本期口径回溯的各条能力门槛曲线都向下移动,40 分门槛的单位得分价格已降至约 0.002 美元。50 分门槛仍有更高价格,但也出现明显下降。
关键模型 / 数据点:
- 40+ 分门槛:最低单位得分价格由约 0.09 降至 0.002 美元,图卡标注下降 98%。
- DeepSeek-V4-Flash-0731:综合分 43.0,单位得分价格 0.002 美元。
- DeepSeek-V4.1-Flash-1017:综合分 51.0,单位得分价格 0.009 美元。
解读边界: 这是按本期评分重建的历史最低值,不能作为 8 月至 10 月的降价幅度;价格按输入与输出 5∶1 混合,不代表完成一次任务的总费用。
证据依据
- 直接证据:图卡标注 40+ tier: 98% cheaper — $0.09 → $0.002 per LLM Stats Score point。
- 视觉推断:30、40、50 分门槛的最低比值阶梯线均下降。
- 直接证据:从本图的悬浮提示核对上述模型、时点及数值。
图 17|40 分以上模型的最低 API 价格
原始标题:Cheapest 40+ LLM Stats Score Model
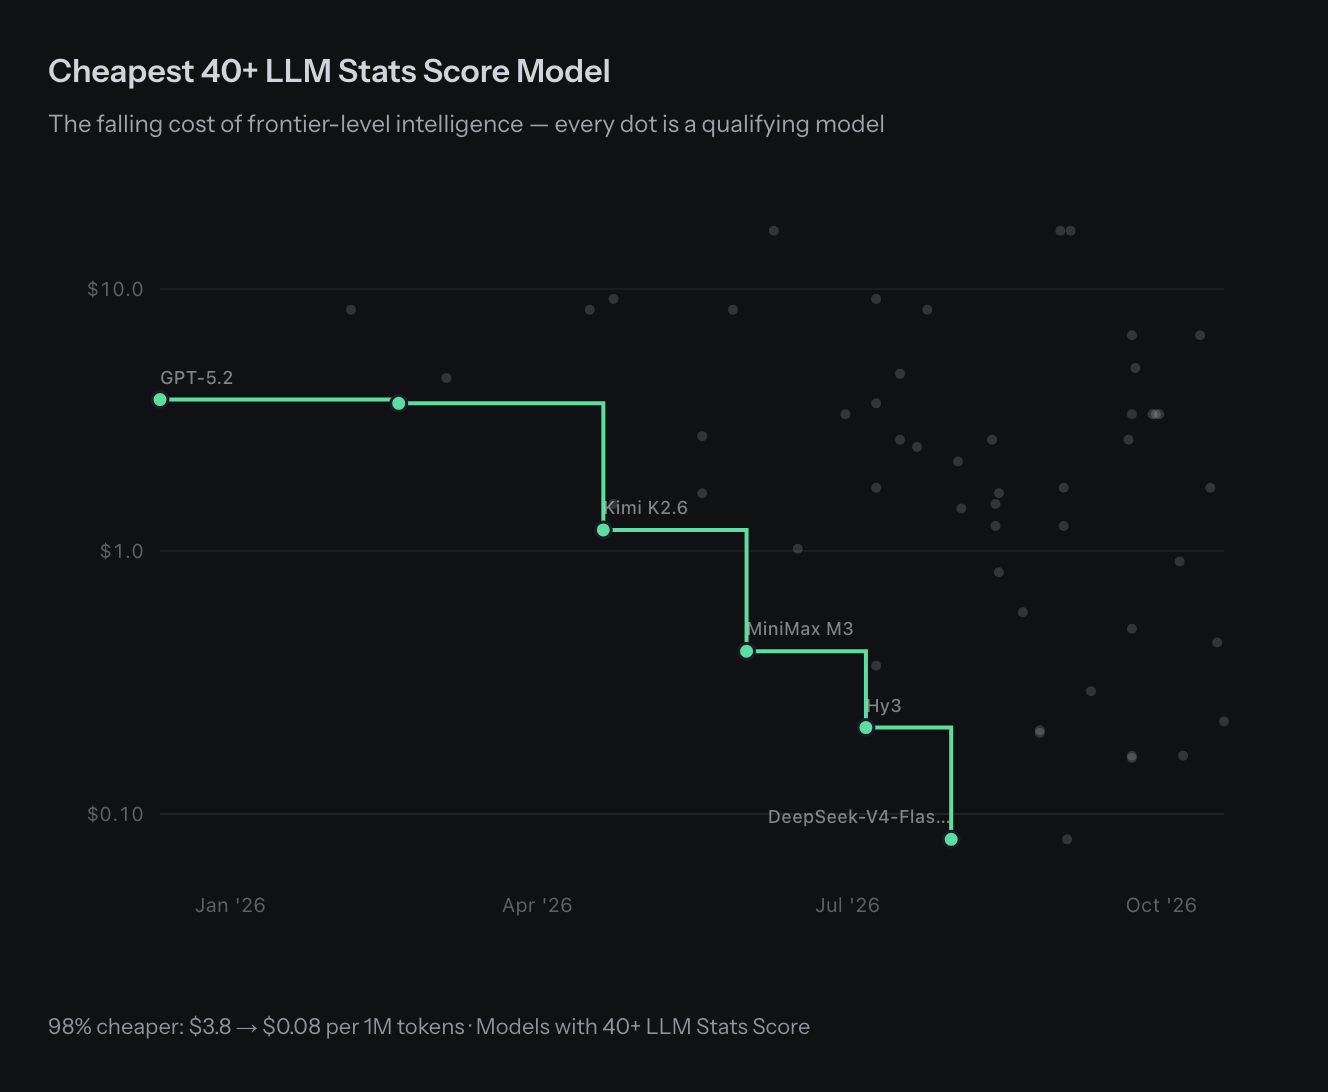
怎么看: 横轴为发布日期,纵轴为每百万 token 的混合 API 价格,采用对数刻度;灰点是达到 40 分的模型,绿色阶梯线连接历次最低价。
图表显示: 达到 40 分这一固定门槛的最低标价显著下降,低价前沿先后由不同模型刷新。门槛成本下降并不意味着全部高能力模型都进入相同价位。
关键模型 / 数据点:
- GPT-5.2:综合分 41.1,每百万 token 3.8 美元。
- Kimi K2.6:综合分 43.4,每百万 token 1.2 美元。
- DeepSeek-V4-Flash-0731:综合分 43.0,每百万 token 0.08 美元;图卡标注较起点下降约 98%。
解读边界: 40 分是当前 LLM Stats Score 的门槛,并非答题正确率或固定不变的“前沿能力”;历史曲线不是跨报告月度环比。
证据依据
- 直接证据:图卡标注 98% cheaper: $3.8 → $0.08 per 1M tokens。
- 直接证据:阶梯线依次标出 GPT-5.2、Kimi K2.6、MiniMax M3、Hy3 和 DeepSeek-V4-Flas… 等模型。
- 直接证据:从本图的悬浮提示核对上述模型、时点及数值。
图 18|编程能力上限与季度平均价格
原始标题:Capability vs Price
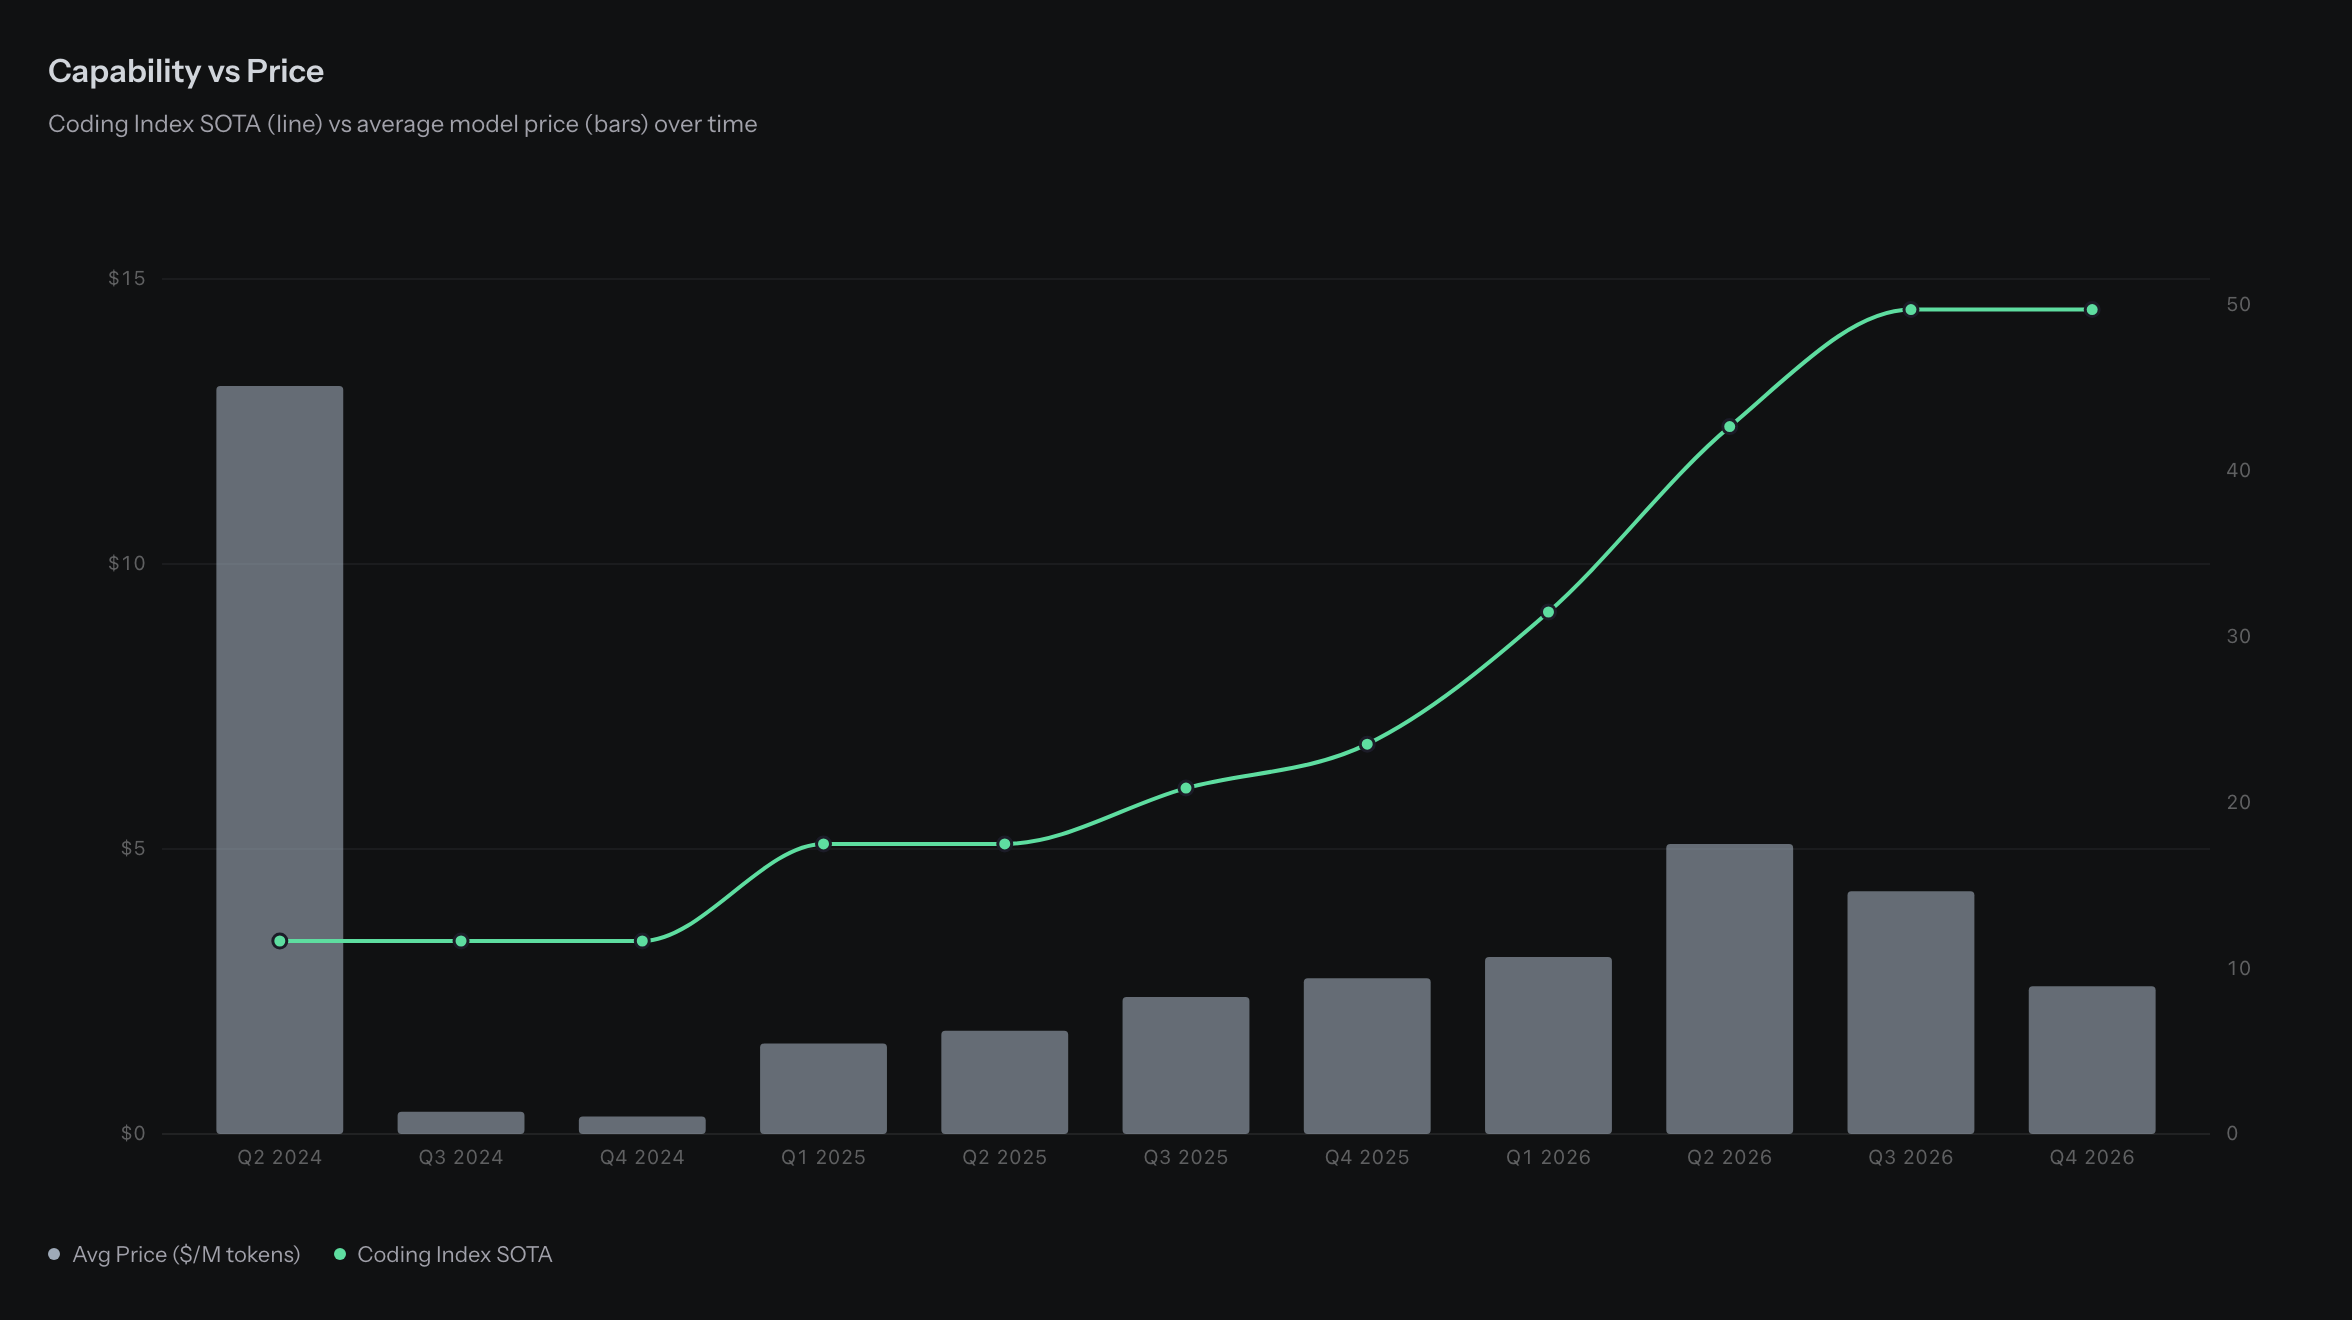
怎么看: 横轴按季度排列;灰柱对应左轴的模型平均价格,绿线对应右轴的 Coding Index 历史最佳值。两组数据使用不同刻度,需分别读取。
图表显示: 编程能力上限持续抬升,而季度平均价格上下波动,二者没有同步上涨。2026 年第三季度到第四季度的可见部分,最佳编程指数持平而平均价格回落。
关键模型 / 数据点:
- 2026 年第二季度:Claude Fable 5 将最佳 Coding Index 推至 42.7,当季均价为每百万 token 5.1 美元。
- 2026 年第三季度:Claude Opus 5.5 的最佳 Coding Index 为 49.7,当季均价 4.3 美元。
- 2026 年第四季度截至抓取日:最佳 Coding Index 仍为 49.7,当季均价为 2.6 美元。
解读边界: 第四季度截至 10 月 20 日,样本尚不完整;季度均价受当季模型组合影响,不能解释成同一批模型统一降价。
证据依据
- 视觉推断:绿线总体上升,并在 2026 年第三、第四季度形成平台;柱高未同步单调上升。
- 直接证据:从本图的悬浮提示核对上述模型、时点及数值。
图 19|综合能力与 API 价格的分散关系
原始标题:Performance vs Price
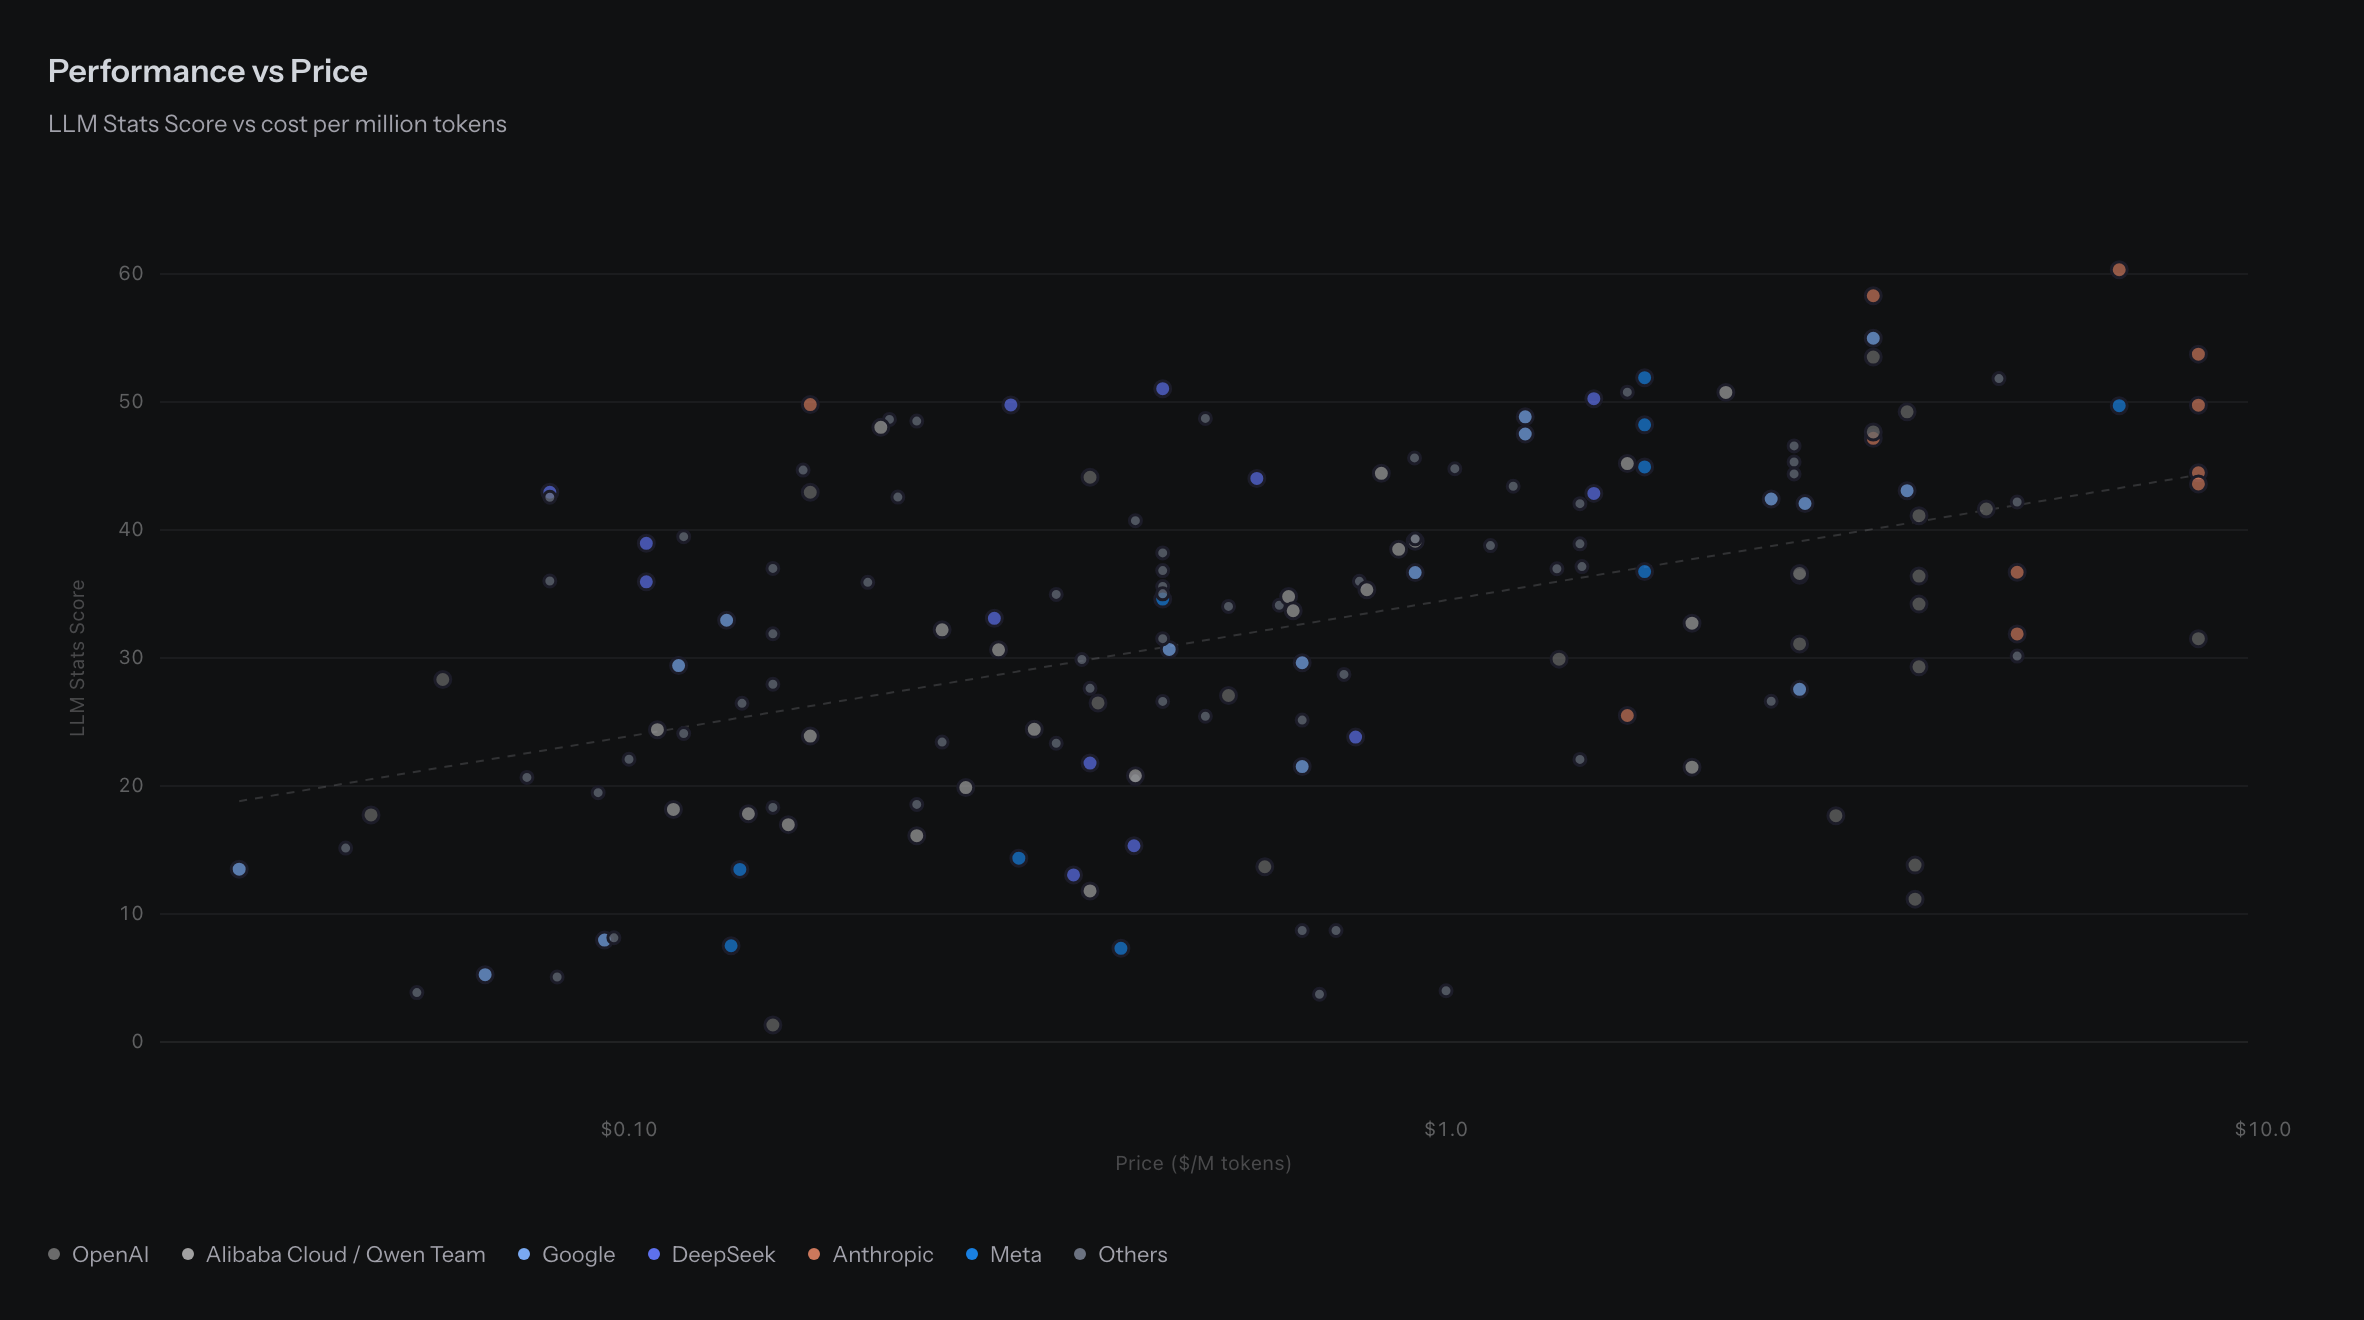
怎么看: 横轴为混合 API 价格,采用对数刻度;纵轴为 LLM Stats Score,颜色区分主要组织,虚线展示样本整体趋势。左上方模型在这两个维度上更有吸引力。
图表显示: 价格较高的模型整体倾向于获得更高分,但同价位的能力差异很大。低价区域也有高分模型,选择时应比较具体候选的能力与报价。
关键模型 / 数据点:
- Claude Haiku 5.5:每百万 token 0.17 美元,综合分 49.8。
- DeepSeek-V4.1-Flash-1017:每百万 token 0.45 美元,综合分 51.0。
- Claude Opus 5.5:每百万 token 6.7 美元,综合分 60.3。
解读边界: 本图截去价格最高约 5% 的样本;混合价格按输入与输出 5∶1 计算,不能直接套用图 22 的价格坐标,更不能据相关性断言涨价带来能力提升。
证据依据
- 视觉推断:虚线向右上方倾斜,但同一价格带的分数分布跨度明显。
- 直接证据:本期页面绘图逻辑以价格第 95 百分位作为显示上限。
- 直接证据:从本图的悬浮提示核对上述模型、时点及数值。
图 20|不同参数档位的归一化能力价格
原始标题:Cost Efficiency by Tier
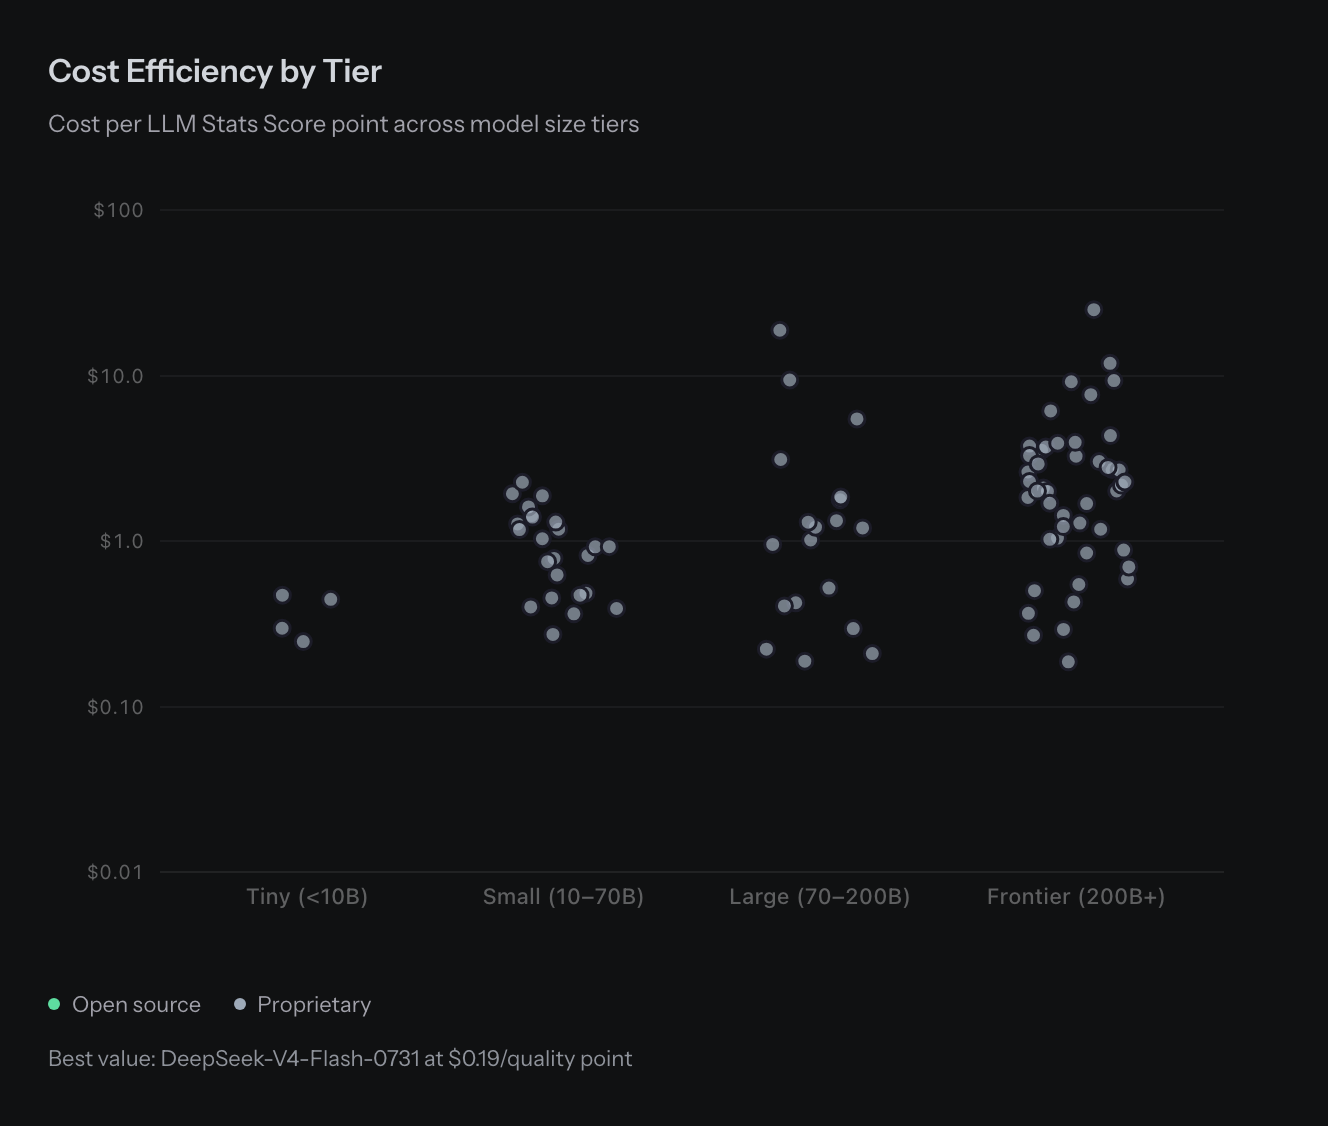
怎么看: 横轴按总参数量分为四档,纵轴是价格与能力的比值并采用对数刻度;图例尝试区分开放与专有模型,数值越低表示该口径下越划算。
图表显示: 总参数量更大的模型并不必然有更好的价格效率;各档内部都有明显差异。来源将 DeepSeek-V4-Flash-0731 标为最佳值,但这张图的单位与图 16 并不一致。
关键模型 / 数据点:
- DeepSeek-V4-Flash-0731:综合分 43.0,图示归一化能力价格为 0.19 美元。
- Gemma 4 31B:综合分 33.0,图示归一化能力价格为 0.40 美元。
- Kimi K3:综合分 51.8,图示归一化能力价格为 9.2 美元。
解读边界: 本图实际计算为价格 ÷ Score × 100,标题却称“每得分点价格”,比图 16 的定义多 100 倍;所有点又均显示灰色,因此只比较图示比值,不据颜色判断开放与专有模型。
证据依据
- 直接证据:图卡标注 Best value: DeepSeek-V4-Flash-0731 at $0.19/quality point。
- 直接证据:本期绘图实现为 costPerPoint:a/r*100,图 16 则直接以混合价格除以 Score。
- 视觉推断:同一参数档位中散点跨越多个价格效率水平。
- 直接证据:从本图的悬浮提示核对上述模型、时点及数值。
- 直接证据:本期 API 未提供 open_source 字段,绘图却以 open_source===true 区分开放模型,导致散点全灰。
图 21|按发布季度观察模型价格效率
原始标题:Value Evolution
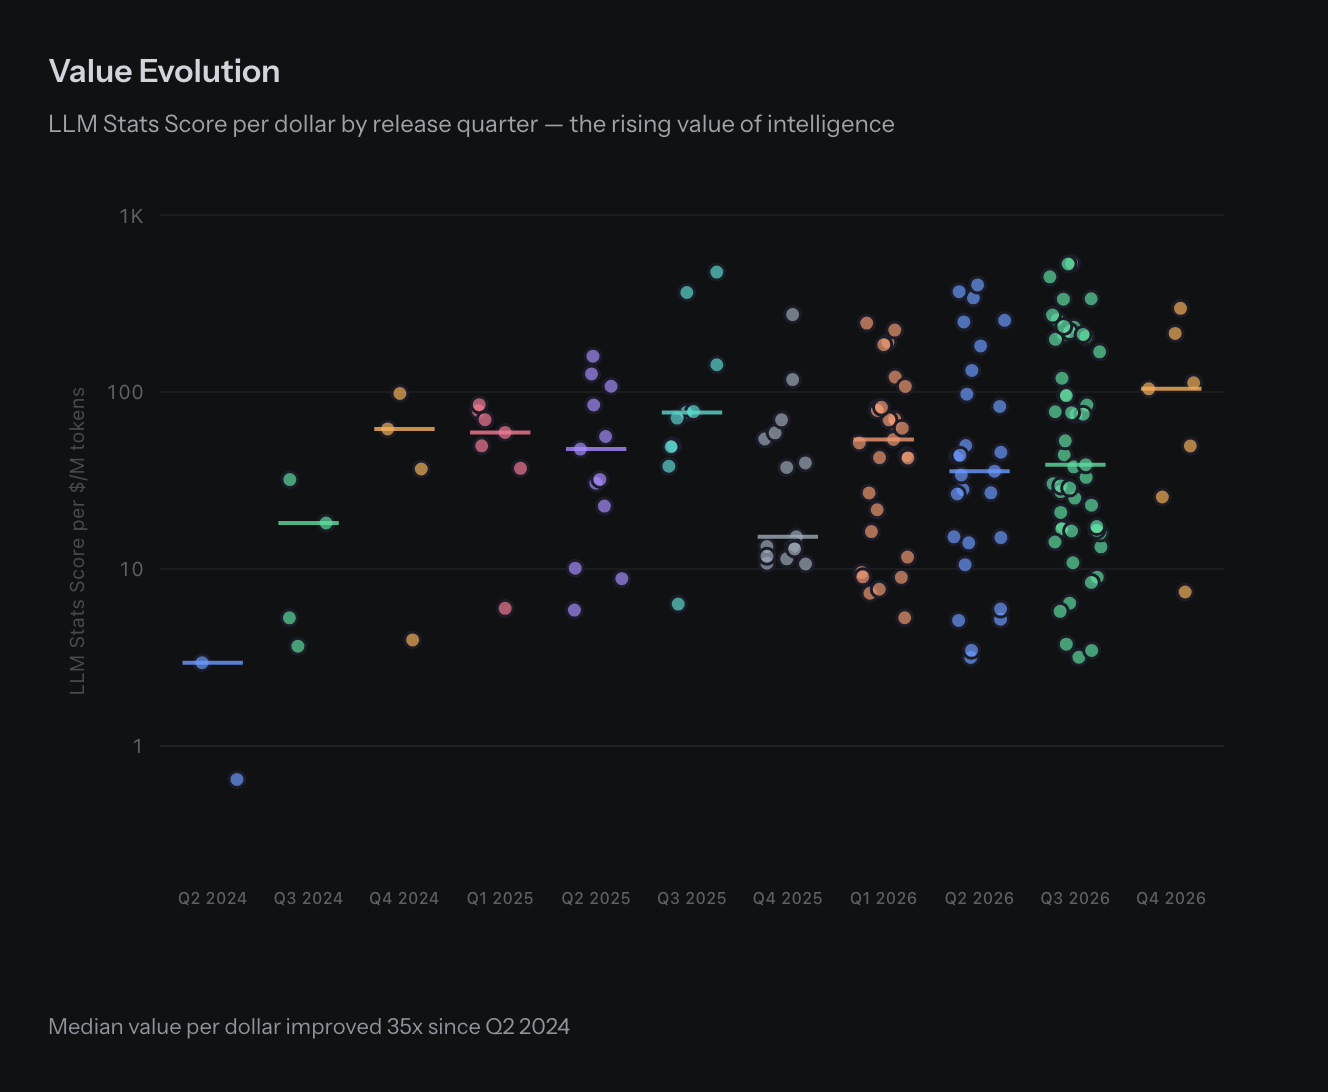
怎么看: 横轴是发布季度,纵轴是 LLM Stats Score 除以每百万 token 价格,单位为分/(美元/百万 token),采用对数刻度;散点是模型,横线是当季中位数,越高表示该比值越好。
图表显示: 本期回溯显示,新模型的能力价格比中位数较最早季度明显提高,但中间季度有反复,最新模型内部也相差很大。整体进步不等于每个新发布模型都更划算。
关键模型 / 数据点:
- 图卡标注:相较 2024 年第二季度,最新季度的能力价格比中位数提高 35 倍。
- Claude Haiku 5.5:能力价格比 298.8,综合分 49.8,图示价格 0.17 美元/百万 token。
- DeepSeek-V4.1-Flash-1017:能力价格比 113.4,综合分 51.0,图示价格 0.45 美元/百万 token。
解读边界: 35 倍是当前评分与价格口径下的历史季度比较,不是本月增幅;2026 年第四季度尚未结束,且该图优先采用数据源的 blended_price 字段。
证据依据
- 直接证据:图卡标注 Median value per dollar improved 35x since Q2 2024。
- 视觉推断:各季中位数并非单调上升,同一季度的散点覆盖宽广范围。
- 直接证据:从本图的悬浮提示核对上述模型及指标;概括性总量另见图卡。
图 22|综合能力与价格的帕累托前沿
原始标题:LLM Stats Score vs Price ($/1M tokens)
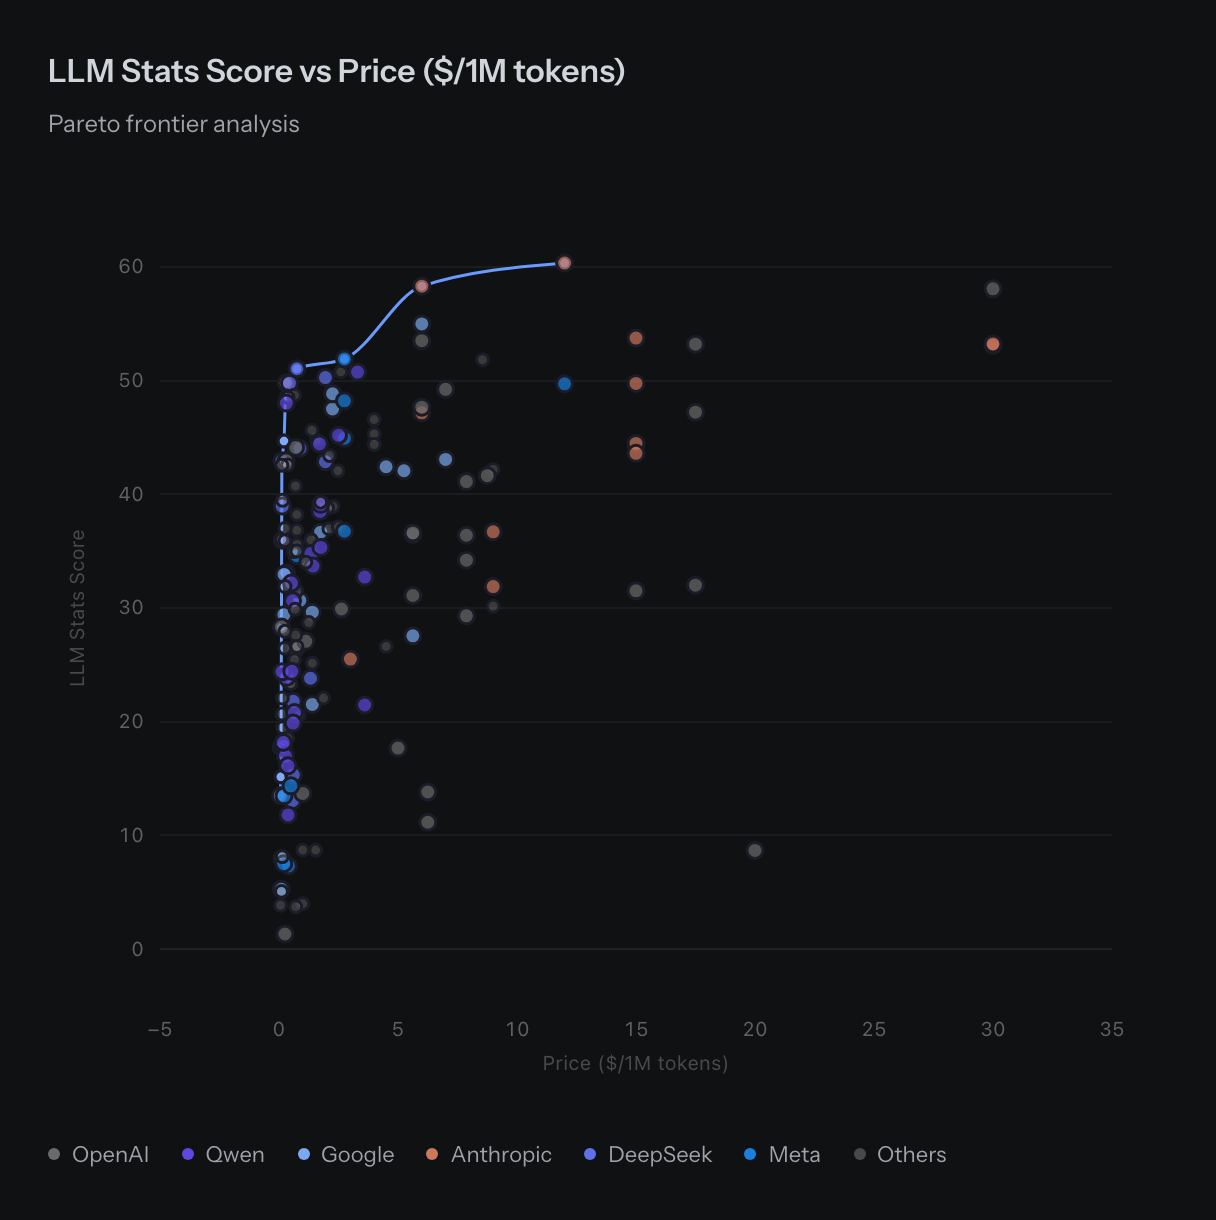
怎么看: 横轴为线性刻度的每百万 token 价格(输入、输出按 1∶1 混合),纵轴为 LLM Stats Score;蓝线连接无法同时被更低价格与更高得分超越的模型。
图表显示: 大部分模型集中在低价端,少数模型构成能力与价格的最优取舍边界。靠近最强能力上限时,继续提高得分需要接受明显更高的标价。
关键模型 / 数据点:
- DeepSeek-V4.1-Flash-1017:每百万 token 0.75 美元,综合分 51.0。
- Claude Sonnet 5.5:每百万 token 6 美元,综合分 58.3。
- Claude Opus 5.5:每百万 token 12 美元,综合分 60.3。
解读边界: 这条前沿只评价综合分与本图价格,未考虑速度、上下文和工具使用;价格按输入与输出 1∶1 混合,与图 19 的 5∶1 不同。
证据依据
- 视觉推断:蓝色前沿在低价端较陡,进入高分区后逐渐平缓;大量高价点位于前沿之下。
- 直接证据:本期前沿图价格实现为 (input_price + output_price) / 2。
- 直接证据:从本图的悬浮提示核对上述模型及指标;概括性总量另见图卡。
图 23|编程能力与价格的帕累托前沿
原始标题:Coding Index vs Price ($/1M tokens)
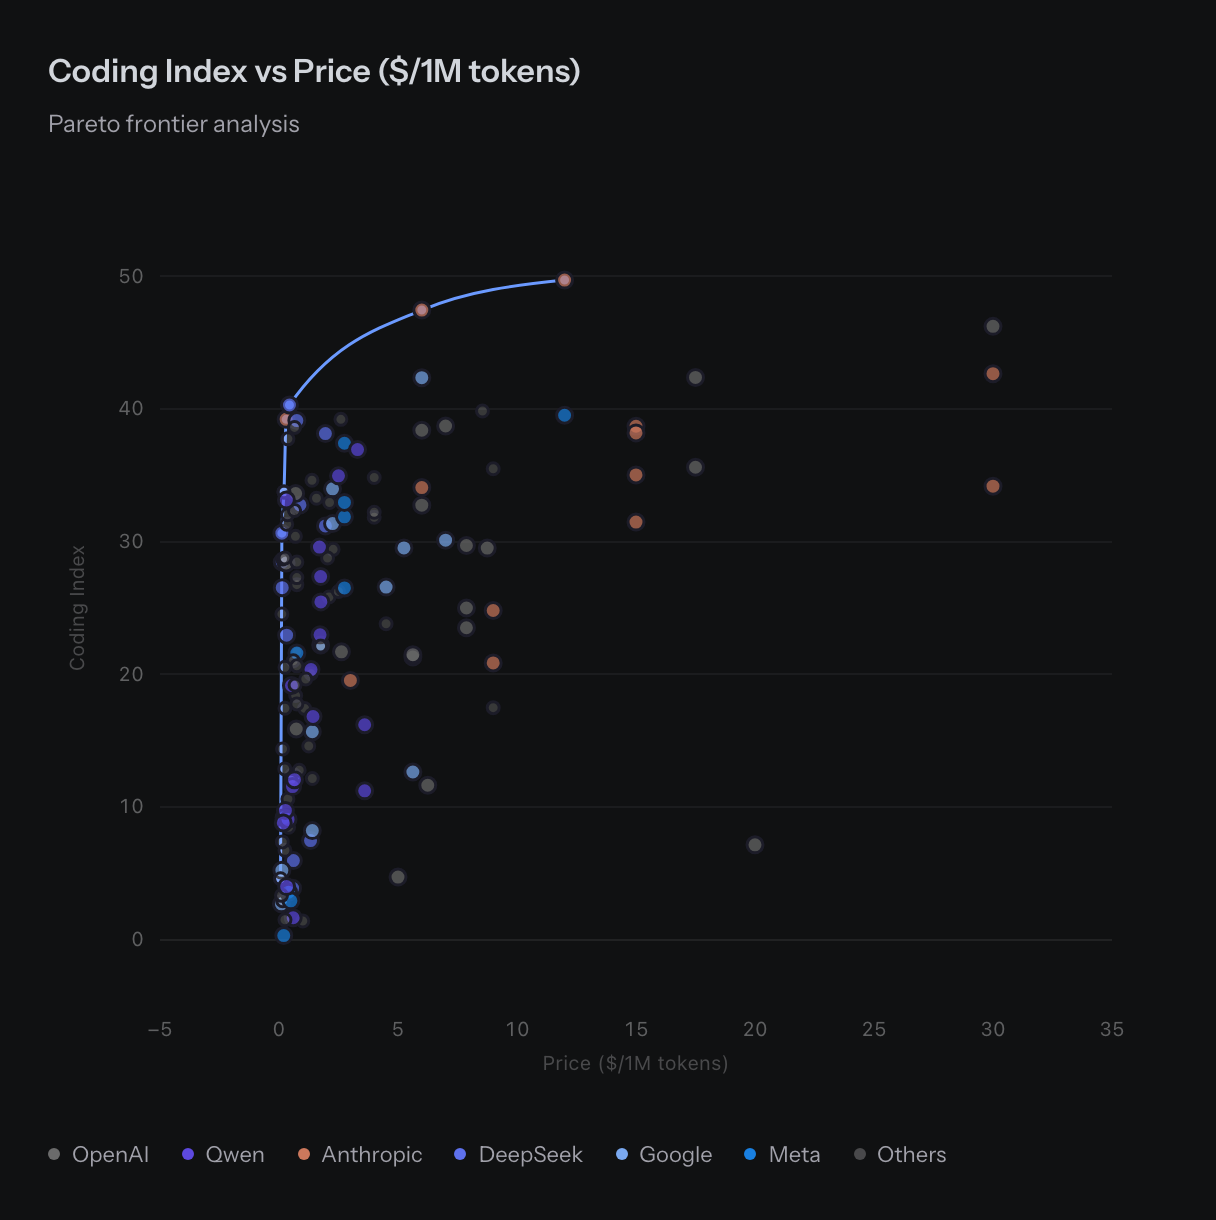
怎么看: 横轴为输入、输出按 1∶1 混合的线性价格,纵轴为 Coding Index,蓝线表示价格与编程指数的帕累托前沿。向左上移动意味着更低价格与更高编程指数。
图表显示: 编程任务也存在明显的价格效率边界,最高报价并不自动带来最强编程能力。达到较高指数后,继续逼近最强模型的边际价格变大。
关键模型 / 数据点:
- DeepSeek-V4.1-Flash:每百万 token 0.44 美元,Coding Index 40.3。
- Claude Sonnet 5.5:每百万 token 6 美元,Coding Index 47.5。
- Claude Opus 5.5:每百万 token 12 美元,Coding Index 49.7。
解读边界: Coding Index 是综合指数而非测试通过率;前沿仅针对当前样本和价格,实际开发任务仍需检验成功率、输出长度和重试次数。
证据依据
- 视觉推断:多个高价模型落在前沿下方;前沿在较高指数处趋于平缓。
- 直接证据:本期前沿图价格实现为 (input_price + output_price) / 2。
- 直接证据:从本图的悬浮提示核对上述模型及指标;概括性总量另见图卡。
图 24|人类偏好评分与价格的帕累托前沿
原始标题:Arena Rating vs Price ($/1M tokens)
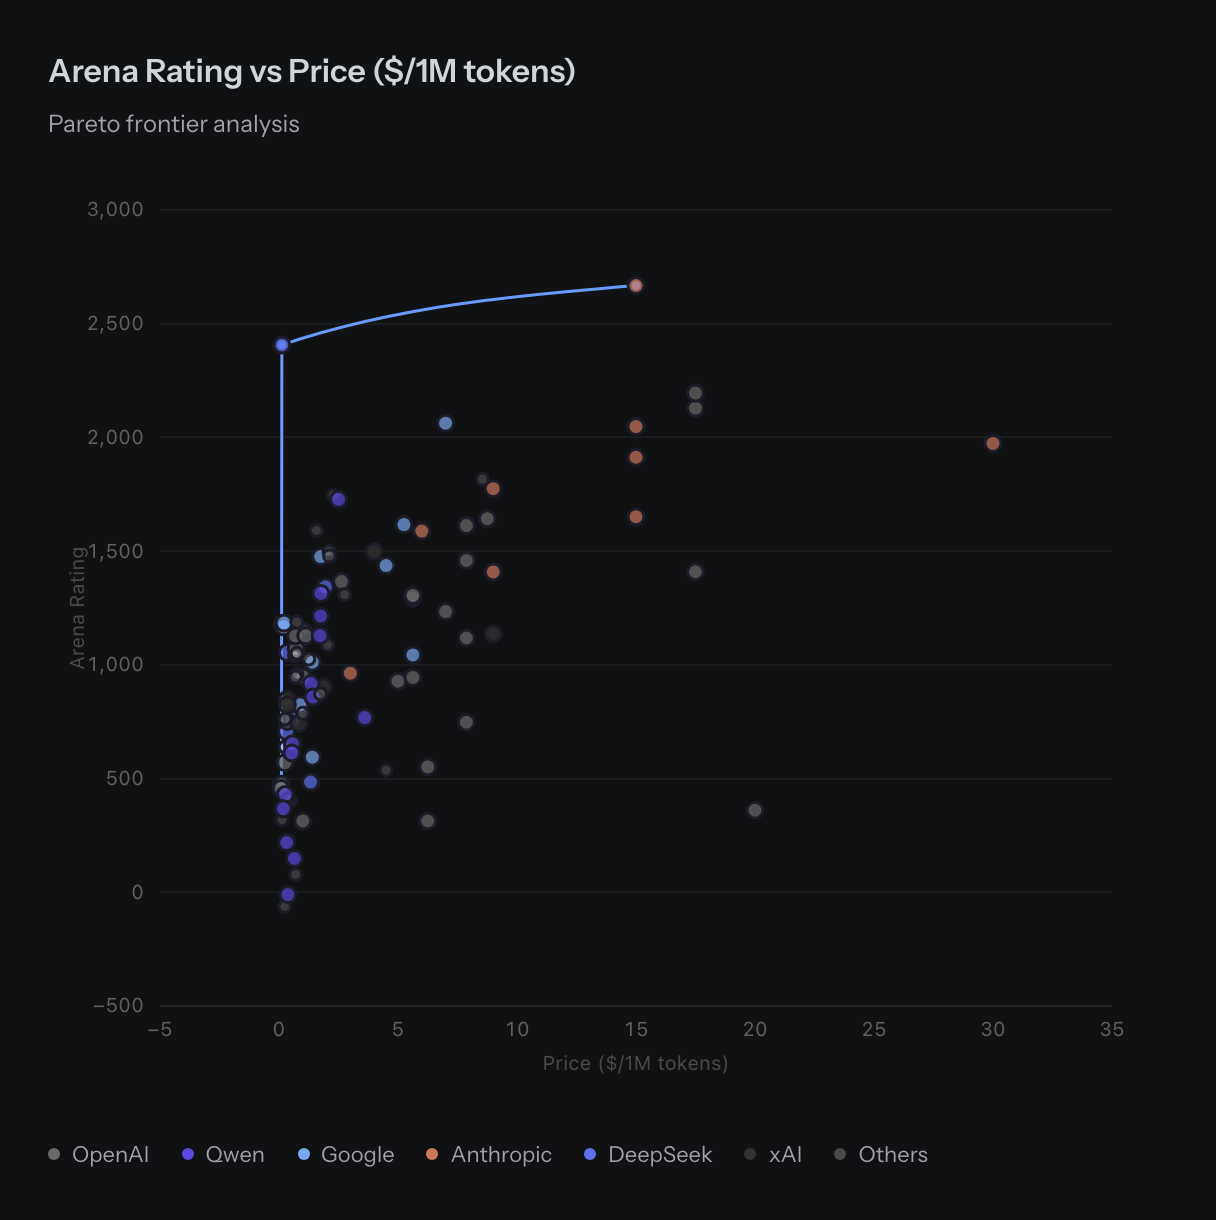
怎么看: 横轴为输入、输出按 1∶1 混合的线性 API 价格,纵轴为 Arena Rating;蓝线连接价格与人类偏好评分的非劣模型,颜色按组织分组。
图表显示: 人类偏好评分与高价并不一一对应,低价端也存在突出模型。该前沿的形状与综合分、编程指数不同,说明“最值得买”取决于评价目标。
关键模型 / 数据点:
- DeepSeek-V4-Flash-0731:每百万 token 0.12 美元,Arena Rating 2407。
- Claude Opus 5:每百万 token 15 美元,Arena Rating 2668。
- Claude Fable 5:每百万 token 30 美元,Arena Rating 1974。
解读边界: Arena Rating 是来源汇总的人类偏好指标,不是百分比;不能把数值直接当作任意 Arena 榜单同一时期、同一赛道的原始 Elo 分。
证据依据
- 视觉推断:图中低价高评分点与高价领先点共同构成前沿,大量更昂贵模型位于其下方。
- 直接证据:本期前沿图价格实现为 (input_price + output_price) / 2。
- 直接证据:从本图的悬浮提示核对上述模型及指标;概括性总量另见图卡。
效率与规模
本组结论: 达到既定能力所需的最小总参数量在缩小,MoE 在有架构与报价的样本中占据较强的价格能力前沿。但参数与训练 token 都不是能力的充分解释,训练数据规模与得分的拟合关系尤其弱;规模指标不能替代具体能力和运行成本评估。
图 25|MoE 与稠密模型的能力价格分布
原始标题:Performance vs Price, Colored by MoE
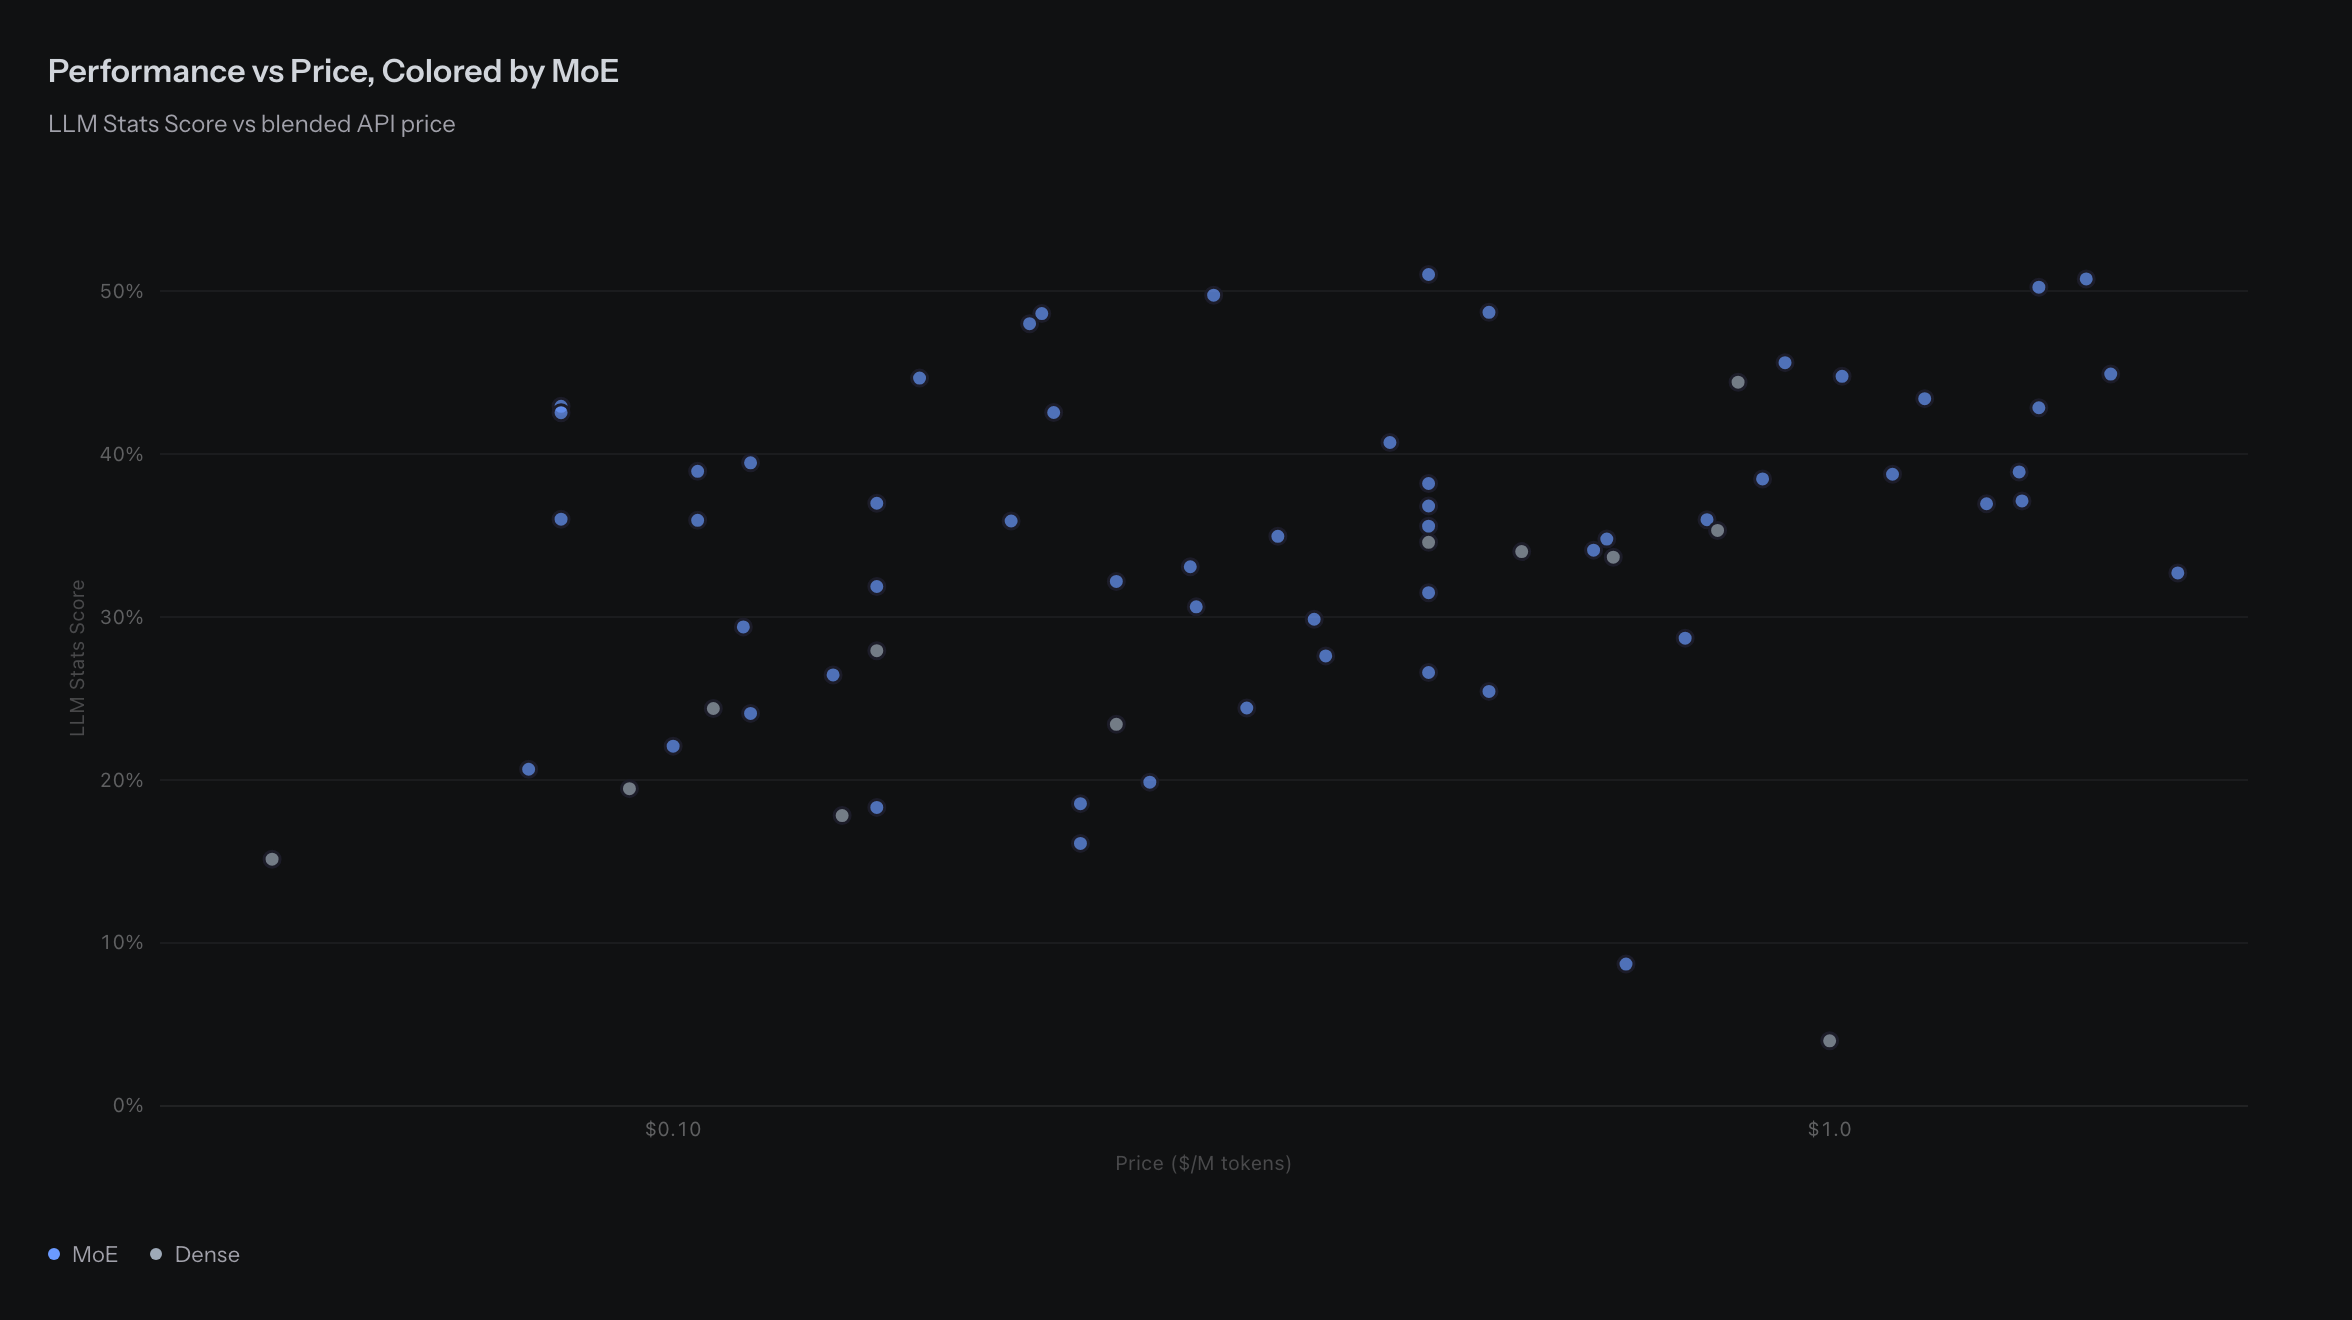
怎么看: 横轴为按输入与输出 5∶1 混合的 API 价格,使用对数刻度;纵轴为 LLM Stats Score,蓝点是 MoE,灰点是稠密模型。
图表显示: 本图可见样本中,MoE 覆盖更多高分、低价组合,稠密模型则分布在较低分区域。但两种架构的样本数量不均衡,不能把全部差异归因于架构。
关键模型 / 数据点:
- DeepSeek-V4.1-Flash-1017(MoE):每百万 token 0.45 美元,综合分 51.0。
- Qwen3.8 Flash(MoE):每百万 token 0.20 美元,综合分 48.0。
- Qwen3.8-27B(稠密):每百万 token 0.83 美元,综合分 44.4。
解读边界: 纵轴错误添加了百分号,正文按综合分解读;本图剔除价格最高约 5% 的样本,且只保留具有架构与定价信息的模型。
证据依据
- 直接证据:SVG 纵轴显示 0%–50%,轴名却是 LLM Stats Score;图例为 MoE 与 Dense。
- 视觉推断:高分区域主要由蓝色 MoE 点组成。
- 直接证据:从本图的悬浮提示核对上述模型及指标;概括性总量另见图卡。
图 26|达到能力门槛的最低混合价格
原始标题:Minimum Cost to Reach Capability
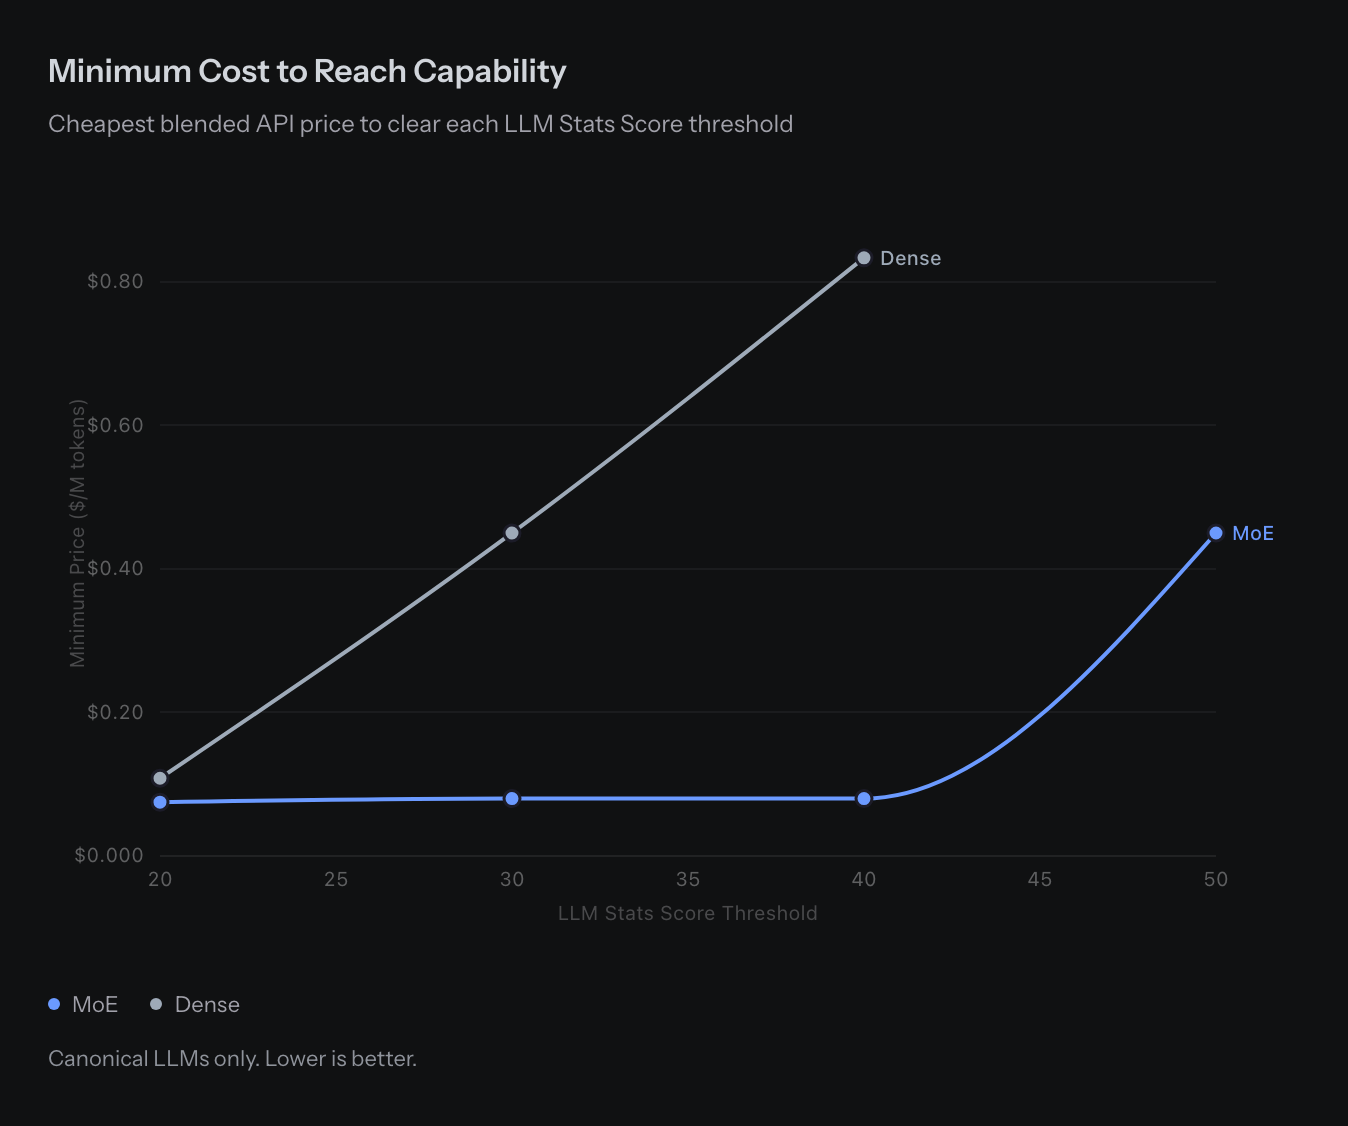
怎么看: 横轴是 LLM Stats Score 门槛,纵轴是达到门槛的最低 API 价格;蓝色与灰色分别是 MoE 和稠密模型,越低越好。
图表显示: 在这组有架构与报价的模型中,MoE 达到多个能力门槛的最低报价更低。稠密曲线到 40 分结束,应理解为当前筛选样本缺少更高门槛的合格点。
关键模型 / 数据点:
- 40+ 分门槛:MoE 最低为 DeepSeek-V4-Flash-0731,0.08 美元/百万 token。
- 40+ 分门槛:稠密模型最低为 Qwen3.8-27B,0.83 美元/百万 token。
- 50+ 分门槛:MoE 最低为 DeepSeek-V4.1-Flash-1017,0.45 美元/百万 token。
解读边界: 图注限定为 canonical LLM 样本,价格采用输入与输出 5∶1;曲线缺点不代表稠密架构理论上无法达到该能力。
证据依据
- 直接证据:图卡说明 Cheapest blended API price to clear each LLM Stats Score threshold,Canonical LLMs only。
- 视觉推断:MoE 曲线在共同门槛处低于 Dense,后者在 40 分处结束。
- 直接证据:从本图的悬浮提示核对上述模型及指标;概括性总量另见图卡。
图 27|达到能力门槛所需的最小总参数量
原始标题:The Efficiency Curve
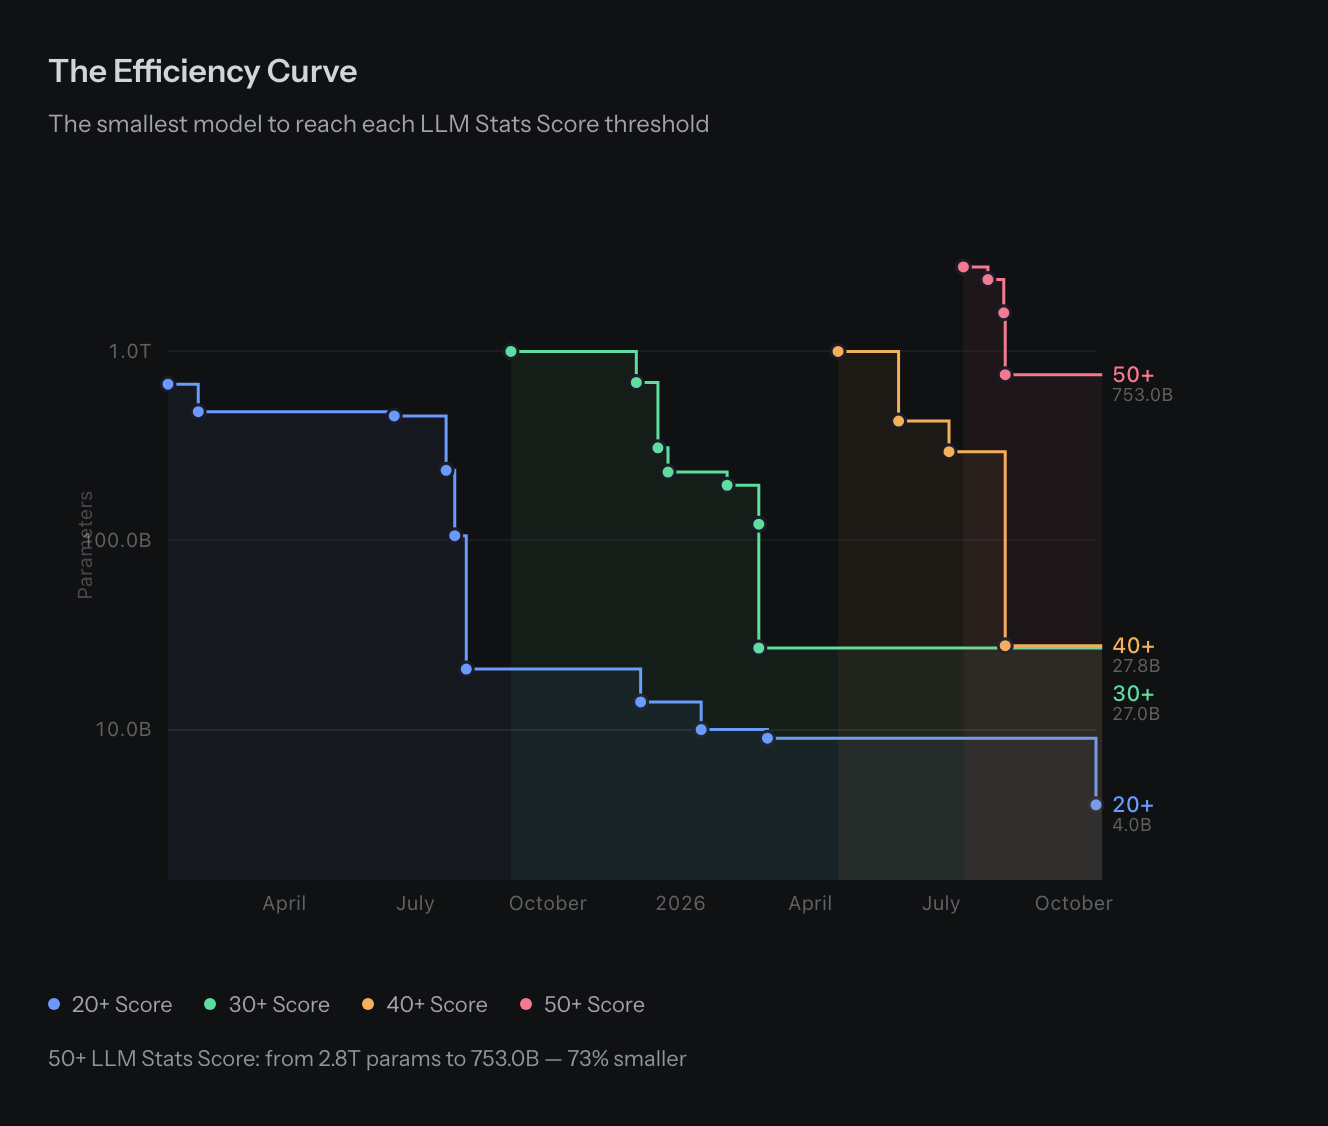
怎么看: 横轴为发布日期,纵轴为对数刻度的总参数量;四条阶梯线分别跟踪达到 20、30、40、50 分门槛的最小模型。
图表显示: 达到固定综合分门槛所需的最小模型在缩小,但 40 分与 50 分之间仍存在显著规模差距。本期视图中,较高能力门槛并未被同样小的模型覆盖。
关键模型 / 数据点:
- 20+ 分门槛:图示最小总参数量为 4.0B;30+ 分门槛为 27.0B。
- 40+ 分门槛:图示最小总参数量为 27.8B。
- 50+ 分门槛:从 Kimi K3 的 2.8T 降至 GLM-5.3 的 753.0B,图卡标注缩小 73%。
解读边界: 参数量是总参数而非每次推理的激活参数;历史纪录按本期 Score 口径计算,73% 不能当作两次报告之间的效率增幅。
证据依据
- 直接证据:曲线终点标注 20+ 4.0B、30+ 27.0B、40+ 27.8B、50+ 753.0B。
- 直接证据:图卡标注 50+ LLM Stats Score: from 2.8T params to 753.0B — 73% smaller。
- 直接证据:从本图的悬浮提示核对上述模型及指标;概括性总量另见图卡。
图 28|不同参数档位的综合能力分布
原始标题:LLM Stats Score by Tier
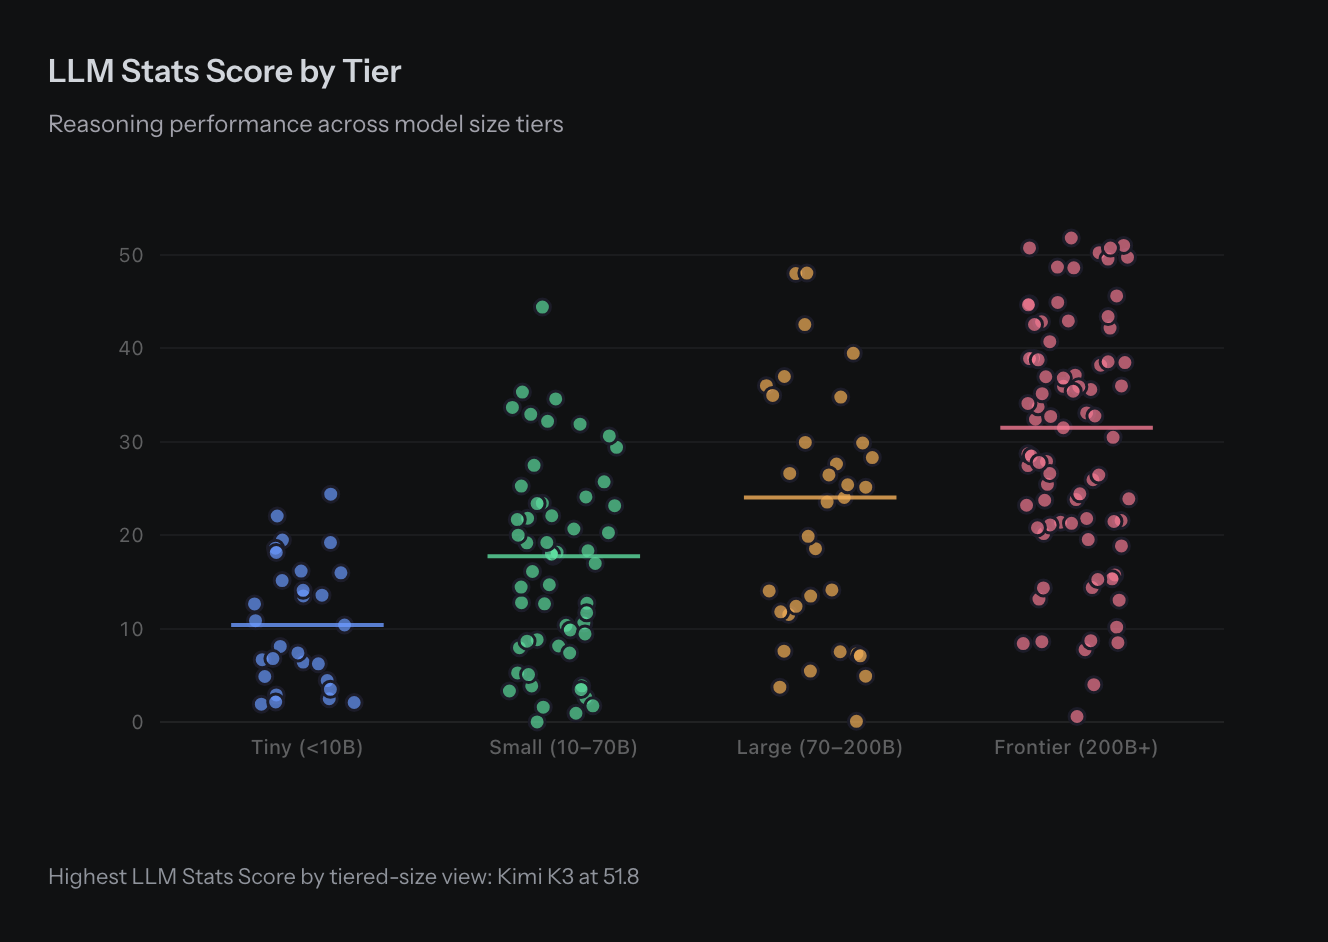
怎么看: 横轴将总参数量分成四档,纵轴为 LLM Stats Score;散点表示模型,横线表示各档中位数。
图表显示: 参数档位越大,中位数整体越高,但各档范围大量重叠。小模型中的强者可以超过不少更大模型,而最高分仍来自最大的参数档位。
关键模型 / 数据点:
- Qwen3.5-9B:总参数 9.0B,综合分 24.4。
- Qwen3.8-27B:总参数 27.8B,综合分 44.4。
- Qwen3.8 Flash:总参数 125.0B,综合分 48.0。
- Kimi K3:总参数 2800.0B,该参数分档视图中的最高分为 51.8。
解读边界: 仅纳入披露参数且有评分的模型,不能与全量榜单直接比较最高分;总参数量不等同于激活参数或部署成本。
证据依据
- 直接证据:图卡标注 Highest LLM Stats Score by tiered-size view: Kimi K3 at 51.8。
- 视觉推断:四档中位线随档位上移,但分布有明显重叠。
- 直接证据:从本图的悬浮提示核对上述模型及指标;概括性总量另见图卡。
图 29|已披露训练数据规模的增长
原始标题:The Training Data Race
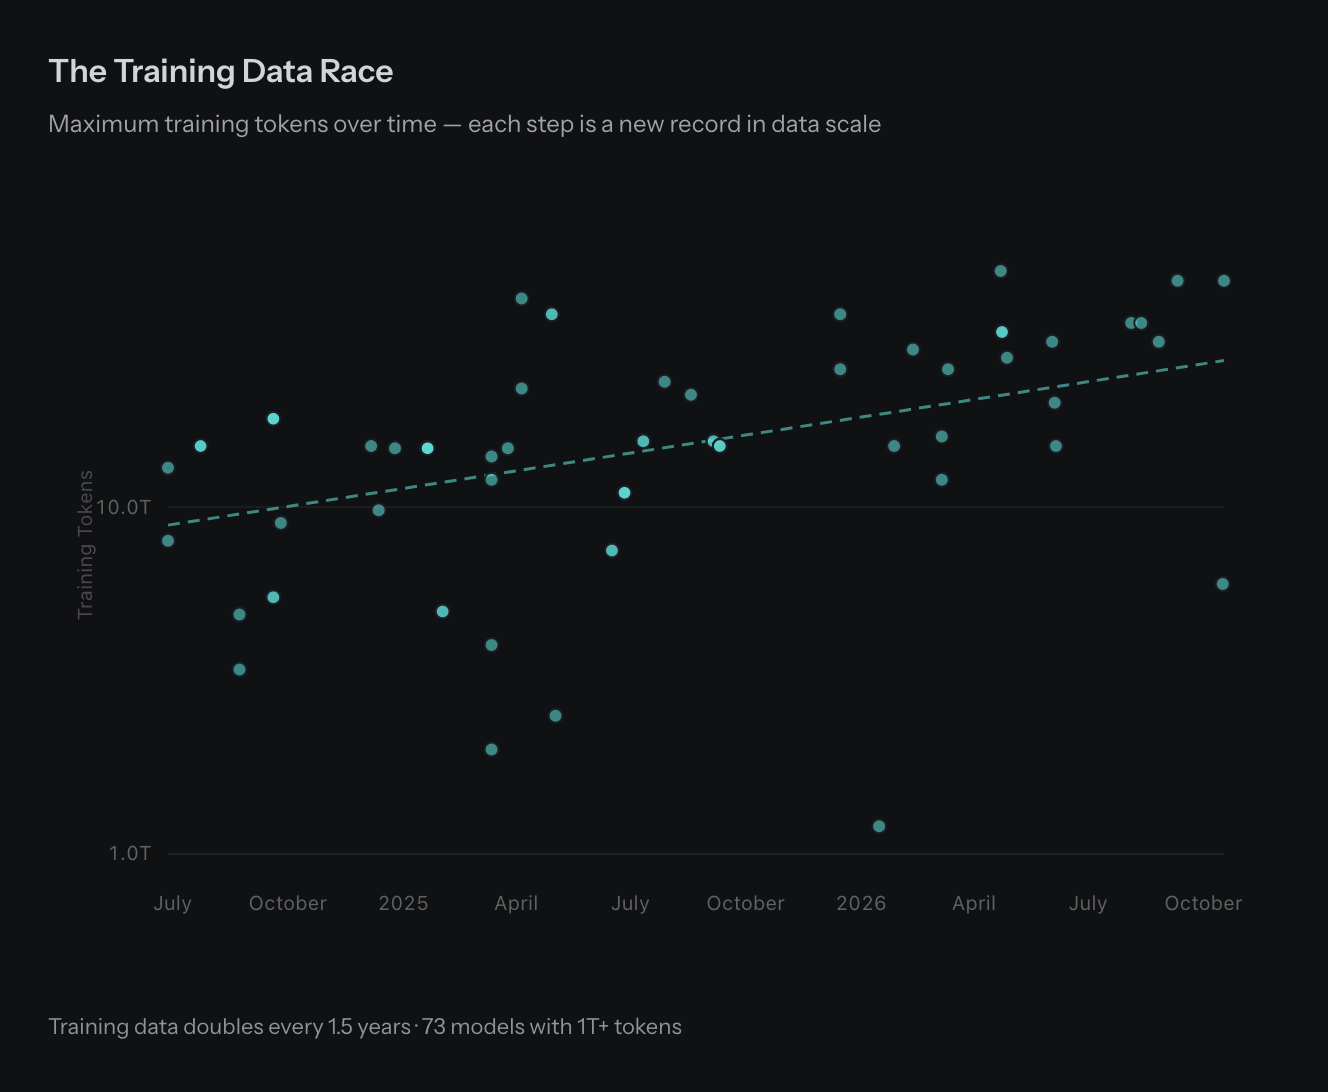
怎么看: 横轴为发布日期,纵轴为训练 token 数量并采用对数刻度;实际图形是模型散点与拟合趋势虚线。
图表显示: 已披露样本的训练数据规模总体扩大,但同一时期差异很大。越来越大的训练集是一条可见趋势,却不能独自说明模型质量提升。
关键模型 / 数据点:
- 图卡摘要:73 个模型披露了至少 1T 训练 token,拟合规模约每 1.5 年翻倍。
- Llama 3.1 8B Instruct:2024 年 7 月发布,训练数据 15.0T token。
- DeepSeek-V4.1-Flash-1017:2026 年 10 月发布,训练数据 45.0T token。
解读边界: 副标题写“最大值、每一步刷新纪录”,实际图形却是散点与拟合线,不能按历史最大值阶梯解读;披露样本也不代表全行业。
证据依据
- 直接证据:图卡标注 Training data doubles every 1.5 years · 73 models with 1T+ tokens。
- 直接证据:PNG 中是离散点与虚线,而非副标题所称的阶梯纪录线。
- 直接证据:从本图的悬浮提示核对上述模型及指标;概括性总量另见图卡。
图 30|训练数据量与综合能力的弱相关
原始标题:The Data Appetite
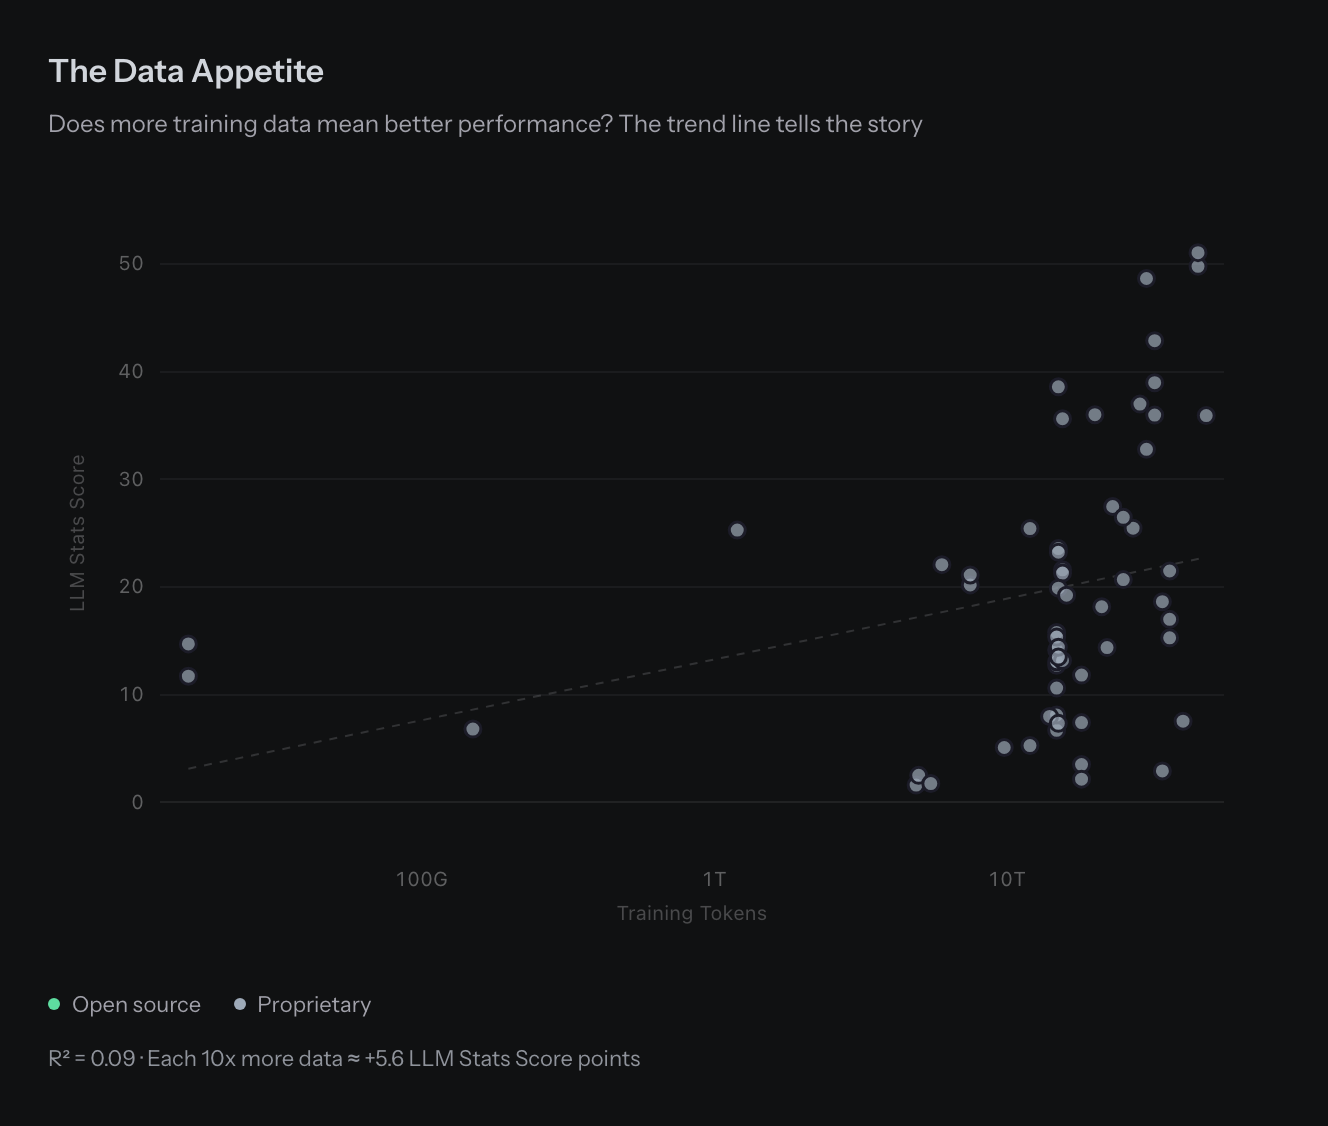
怎么看: 横轴是对数刻度的训练 token 数,纵轴是 LLM Stats Score;虚线为样本拟合趋势,图例尝试区分开放与专有模型。
图表显示: 更多训练数据与更高综合分只有较弱的统计关系。拟合解释度仅 0.09,同样数据规模下分数仍可相差很大,不能只用训练 token 数挑选模型。
关键模型 / 数据点:
- 拟合决定系数 R² = 0.09;训练 token 数增加 10 倍,对应拟合分数约增加 5.6 分。
- GLM-5.3-Flash:训练数据 30.0T token,综合分 48.6。
- DeepSeek-V4.1-Flash-1017:训练数据 45.0T token,综合分 51.0。
解读边界: 这是披露样本的相关性,不能推出增加数据必然提高得分;图中开闭源颜色未可靠区分,悬浮提示 又误添百分号,正文统一按综合分解读。
证据依据
- 直接证据:图卡标注 R² = 0.09 · Each 10x more data ≈ +5.6 LLM Stats Score points。
- 视觉推断:点云在相近训练数据规模处仍存在较大纵向离散。
- 直接证据:从本图的悬浮提示核对上述模型及指标;概括性总量另见图卡。
- 直接证据:悬浮提示 以百分号显示综合分;本期 API 未提供 open_source 字段,绘图以该字段判定开放模型,导致散点全灰。
图 31|总参数量与综合能力的效率前沿
原始标题:Efficiency Frontier
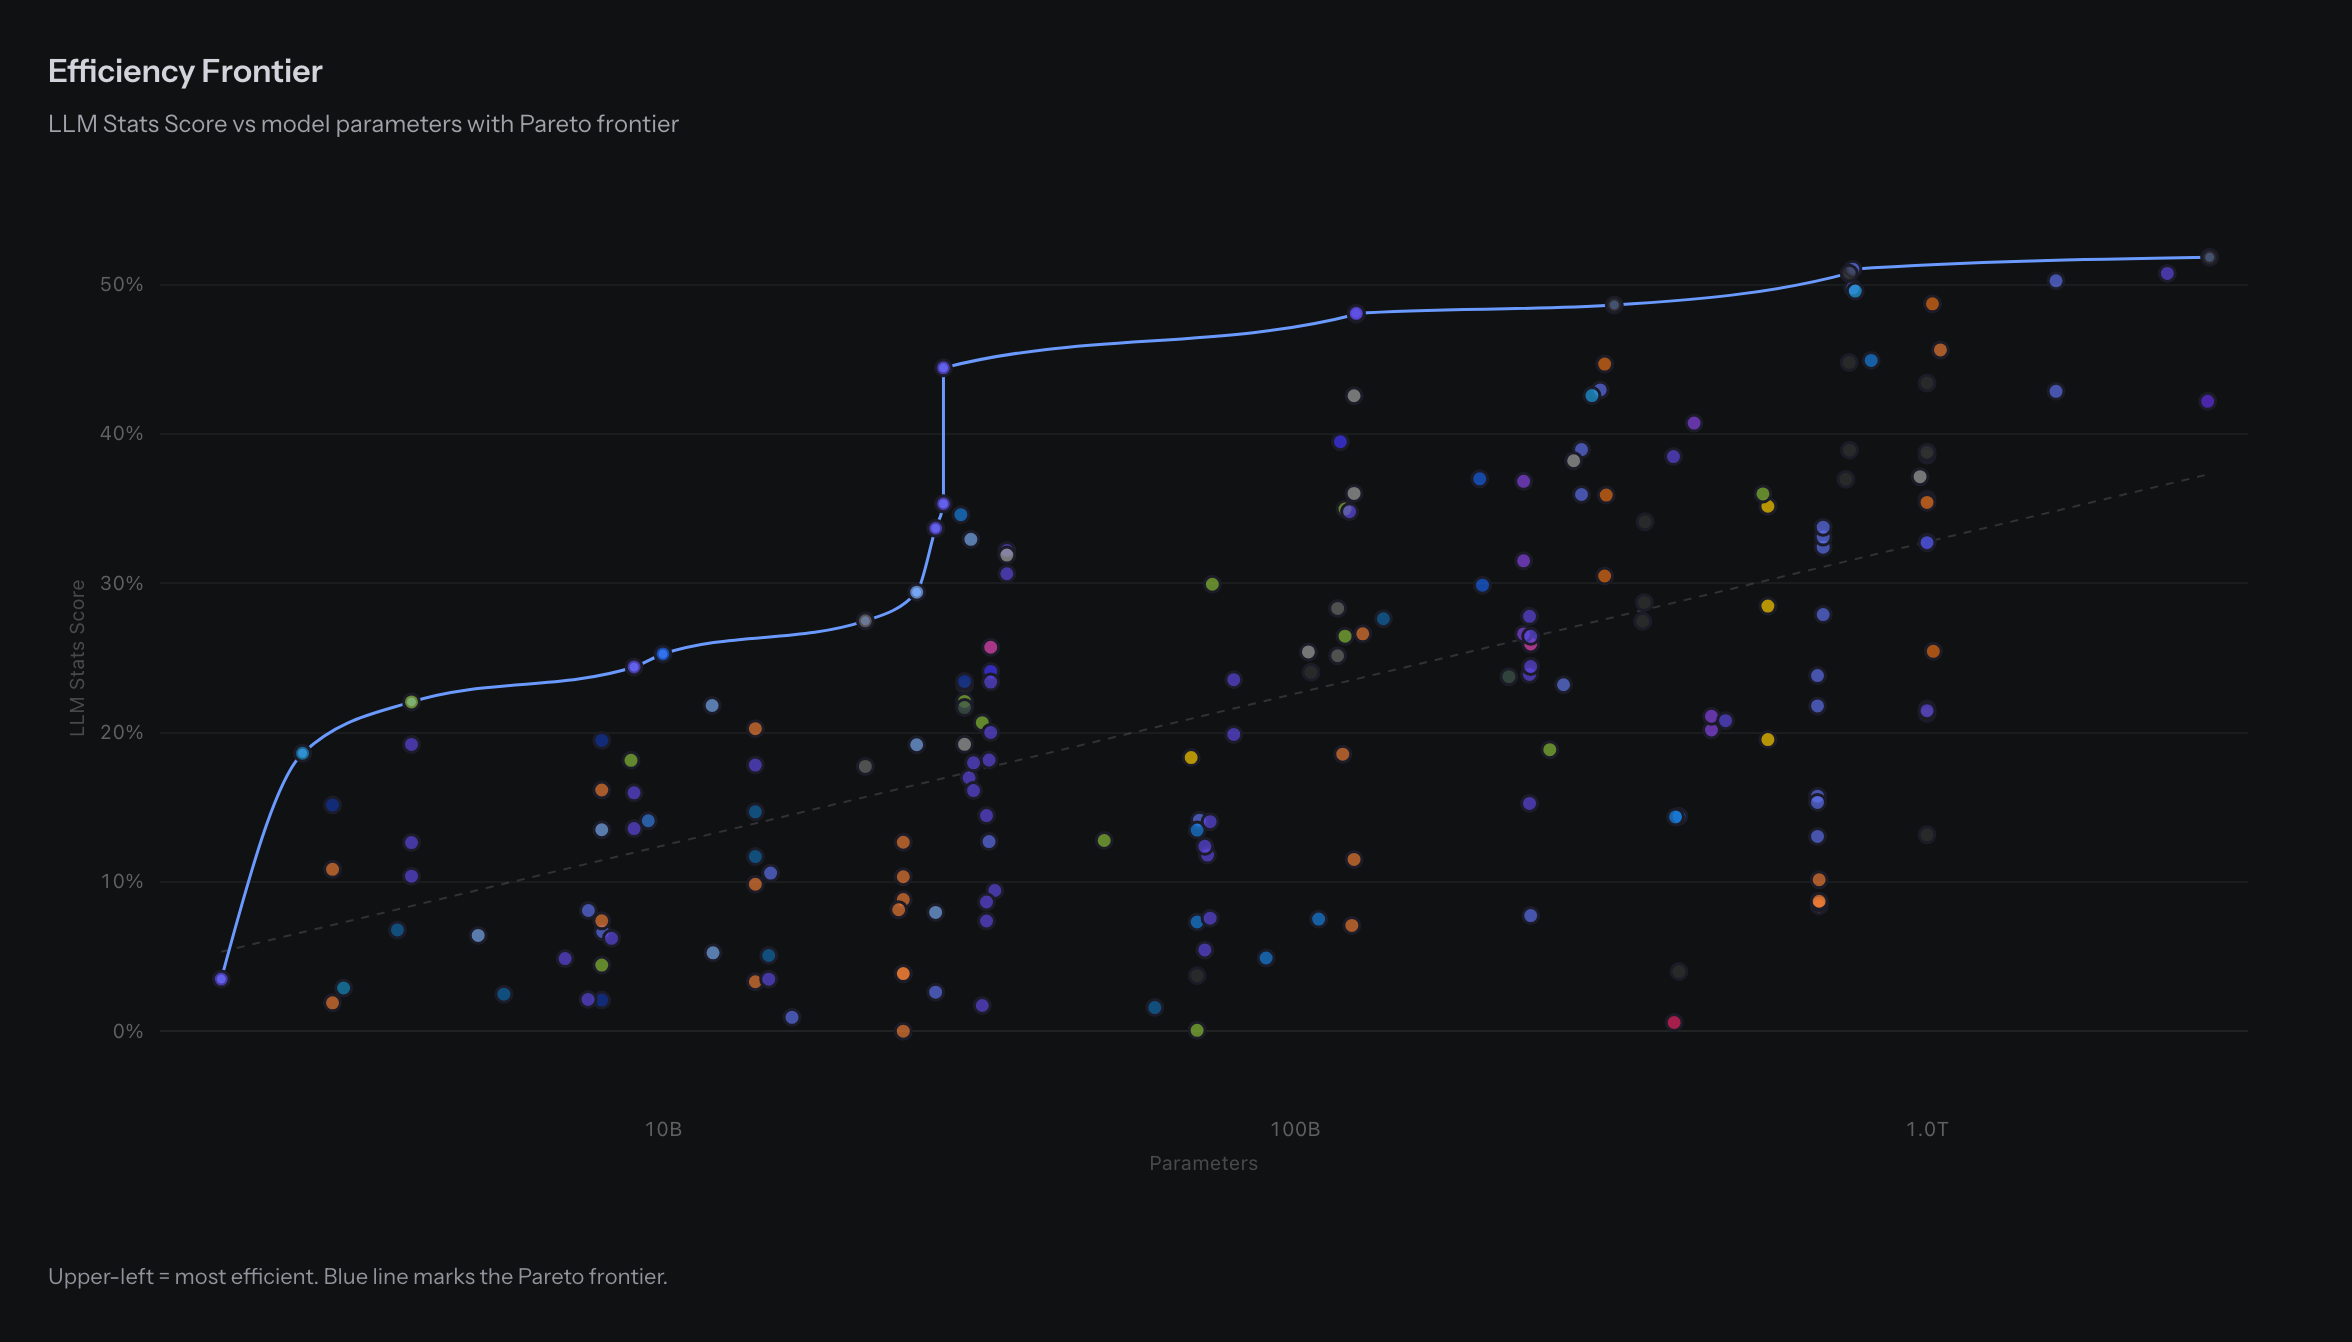
怎么看: 横轴为对数刻度的总参数量,纵轴为 LLM Stats Score;蓝线连接在较小规模下取得较高分的非劣模型,左上方更有参数效率。
图表显示: 参数相近的模型表现仍可显著不同,约 28B 的两个 Qwen 模型分别达到 35.3 与 44.4 分。继续增大到数百 B 甚至数 T 后,最高分仍在提升,但得分增幅并不与总参数量成比例。
关键模型 / 数据点:
- Qwen3.6-27B:图中总参数约 28B,综合分 35.3。
- Qwen3.8-27B:图中总参数约 28B,综合分 44.4。
- GLM-5.3:总参数 753B,综合分 50.8。
- Kimi K3:总参数 2.8T,综合分 51.8。
解读边界: 纵轴百分号是来源格式错误,Score 应按分值读取;总参数量不是激活计算量,该前沿不能直接用作显存、延迟或推理费用排名。
证据依据
- 直接证据:轴名为 LLM Stats Score,但刻度错误显示百分号。
- 视觉推断:点云随参数量增大整体抬升,几十 B 参数处蓝色前沿有明显纵向跃升。
- 直接证据:从本图的悬浮提示核对上述模型及指标;概括性总量另见图卡。
图 32|MoE 与稠密模型的能力价格前沿
原始标题:Reasoning vs Price
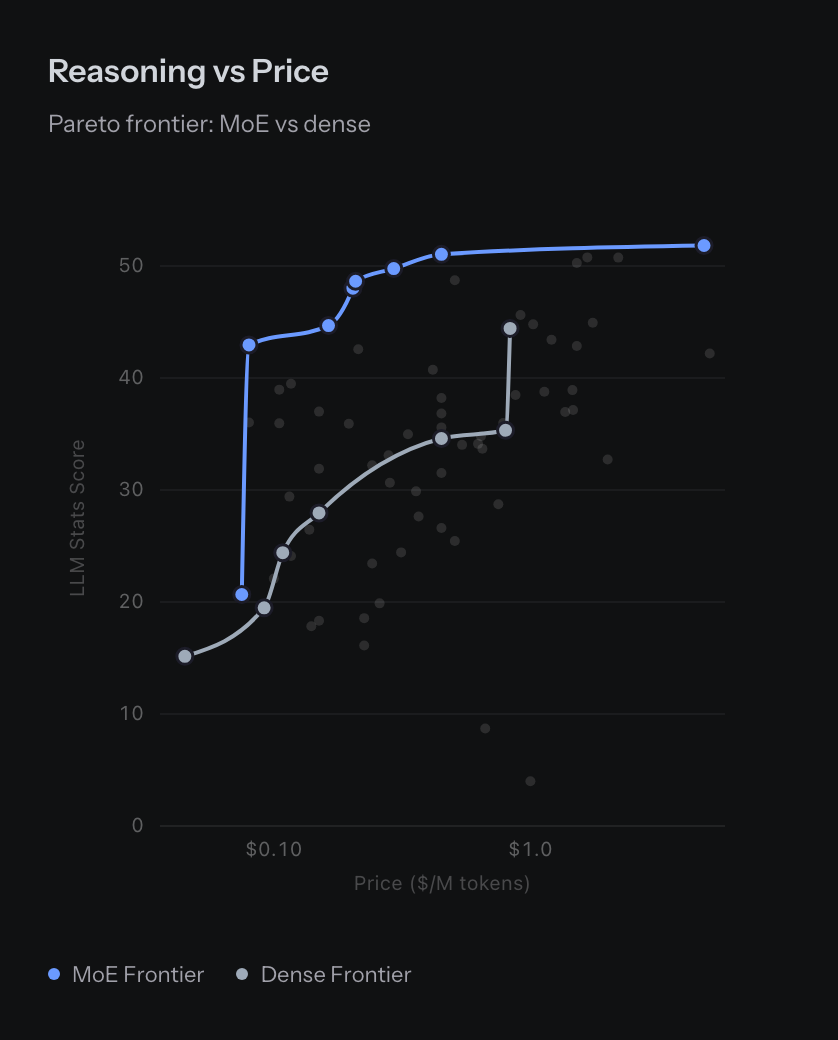
怎么看: 横轴为混合 API 价格并使用对数刻度,纵轴为 LLM Stats Score;蓝线与灰线分别连接 MoE、稠密模型各自的非劣点。
图表显示: 在本期可比较样本中,MoE 的价格能力前沿高于稠密模型,并覆盖更高得分区域。同一预算下,架构标签可以帮助筛选候选,但仍需比较具体模型。
关键模型 / 数据点:
- DeepSeek-V4-Flash-0731(MoE):0.08 美元/百万 token,综合分 43.0。
- DeepSeek-V4.1-Flash-1017(MoE):0.45 美元/百万 token,综合分 51.0。
- Qwen3.8-27B(稠密):0.83 美元/百万 token,综合分 44.4。
解读边界: 标题沿用 Reasoning,实际能力轴是 LLM Stats Score;只纳入架构与价格信息齐全的模型,前沿优势不能当作架构的单独因果效应。
证据依据
- 直接证据:标题为 Reasoning vs Price,纵轴明确为 LLM Stats Score。
- 视觉推断:两条前沿共同覆盖的价格范围内,MoE 线总体位于 Dense 上方。
- 直接证据:从本图的悬浮提示核对上述模型及指标;概括性总量另见图卡。
图 33|吞吐量与能力:架构前沿的有限样本
原始标题:Reasoning vs Throughput
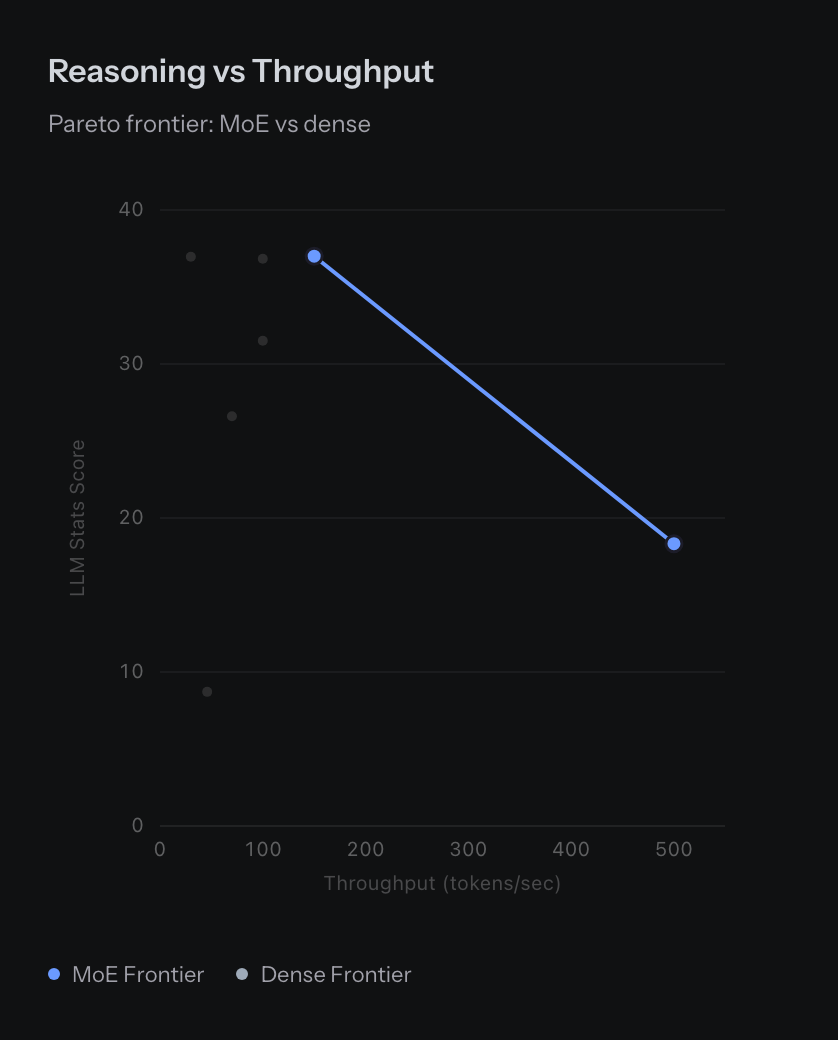
怎么看: 横轴为每秒生成 token 数,纵轴为综合分;越靠右上越理想,蓝线和灰线分别表示 MoE 与稠密模型前沿。
图表显示: 可读取的 7 个模型全部属于 MoE,不能据此比较两类架构。Step-3.5-Flash 与 GLM-5 同为 37.0 分,前者图示吞吐更高;追求 500 token/s 时,可见前沿对应的综合分降到 18.3。
关键模型 / 数据点:
- Step-3.5-Flash:150 token/s,综合分 37.0,MoE。
- GLM-5:30 token/s,综合分 37.0,MoE。
- LongCat-Flash-Lite:500 token/s,综合分 18.3,MoE。
解读边界: 图题写推理能力,实际纵轴是整体综合分。硬件、服务商、批量和推理配置未固定,前沿只对这组样本成立。
证据依据
- 直接证据:本图交互提示与图卡标注:Step-3.5-Flash:150 token/s,综合分 37.0,MoE;GLM-5:30 token/s,综合分 37.0,MoE;LongCat-Flash-Lite:500 token/s,综合分 18.3,MoE。
- 视觉推断:前沿位置与散点分布支持本图所述取舍;结论只覆盖本图可见样本。
图 34|参数量与能力:MoE 和稠密模型各有前沿
原始标题:Reasoning vs Size
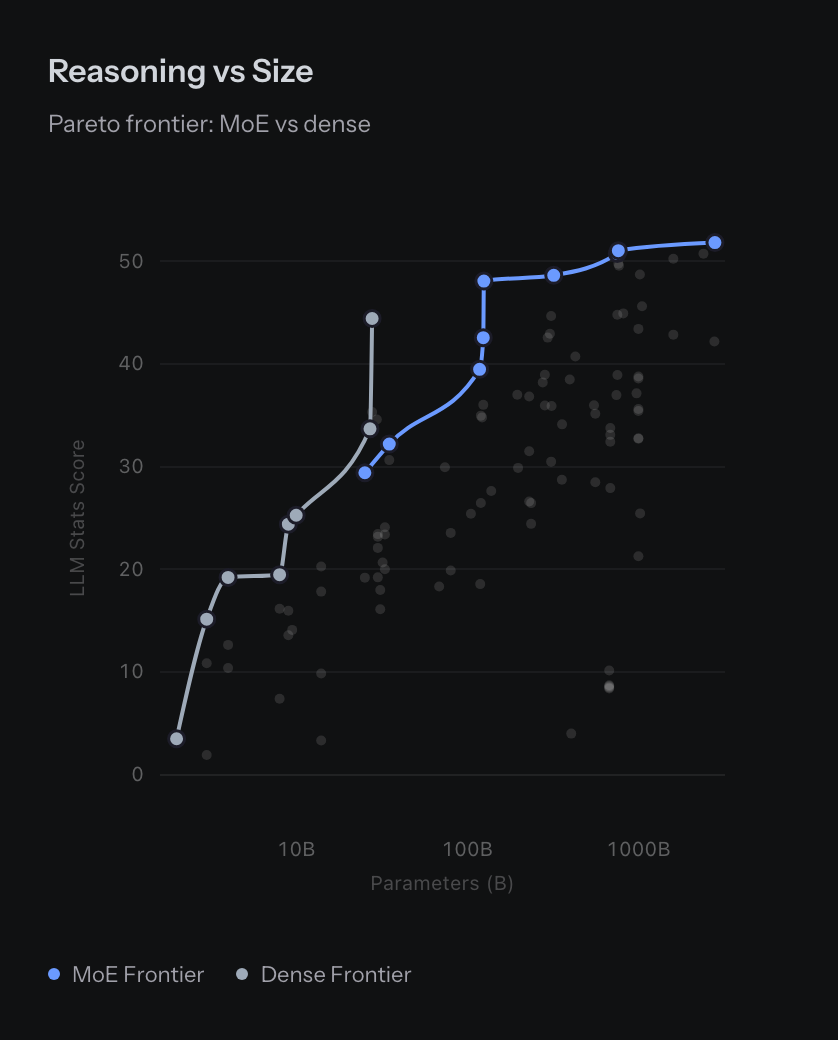
怎么看: 横轴是对数刻度的总参数量,纵轴是综合分。靠左上意味着以更少总参数取得更高分,连线连接各架构的非支配点。
图表显示: 稠密模型在较小规模也能形成有竞争力的前沿;MoE 的高分区向更大总参数规模延伸。大模型群内仍有明显纵向分散。
关键模型 / 数据点:
- Qwen3.8-27B:图示 28B 总参数,综合分 44.4,稠密架构。
- Qwen3.8-Flash-Next:125B,综合分 48.1,MoE。
- Kimi K3:2800B,综合分 51.8,MoE。
解读边界: 比较的是总参数量,不能直接换算每 token 激活参数、显存或实际延迟;不同训练数据和发布日期也未控制。参数数字按本图提示的取整精度保留。
证据依据
- 直接证据:本图交互提示与图卡标注:Qwen3.8-27B:图示 28B 总参数,综合分 44.4,稠密架构;Qwen3.8-Flash-Next:125B,综合分 48.1,MoE;Kimi K3:2800B,综合分 51.8,MoE。
- 视觉推断:前沿位置与散点分布支持本图所述取舍;结论只覆盖本图可见样本。
图 35|综合分与参数量:挑选规模合适的候选
原始标题:LLM Stats Score vs Parameters (Billions)
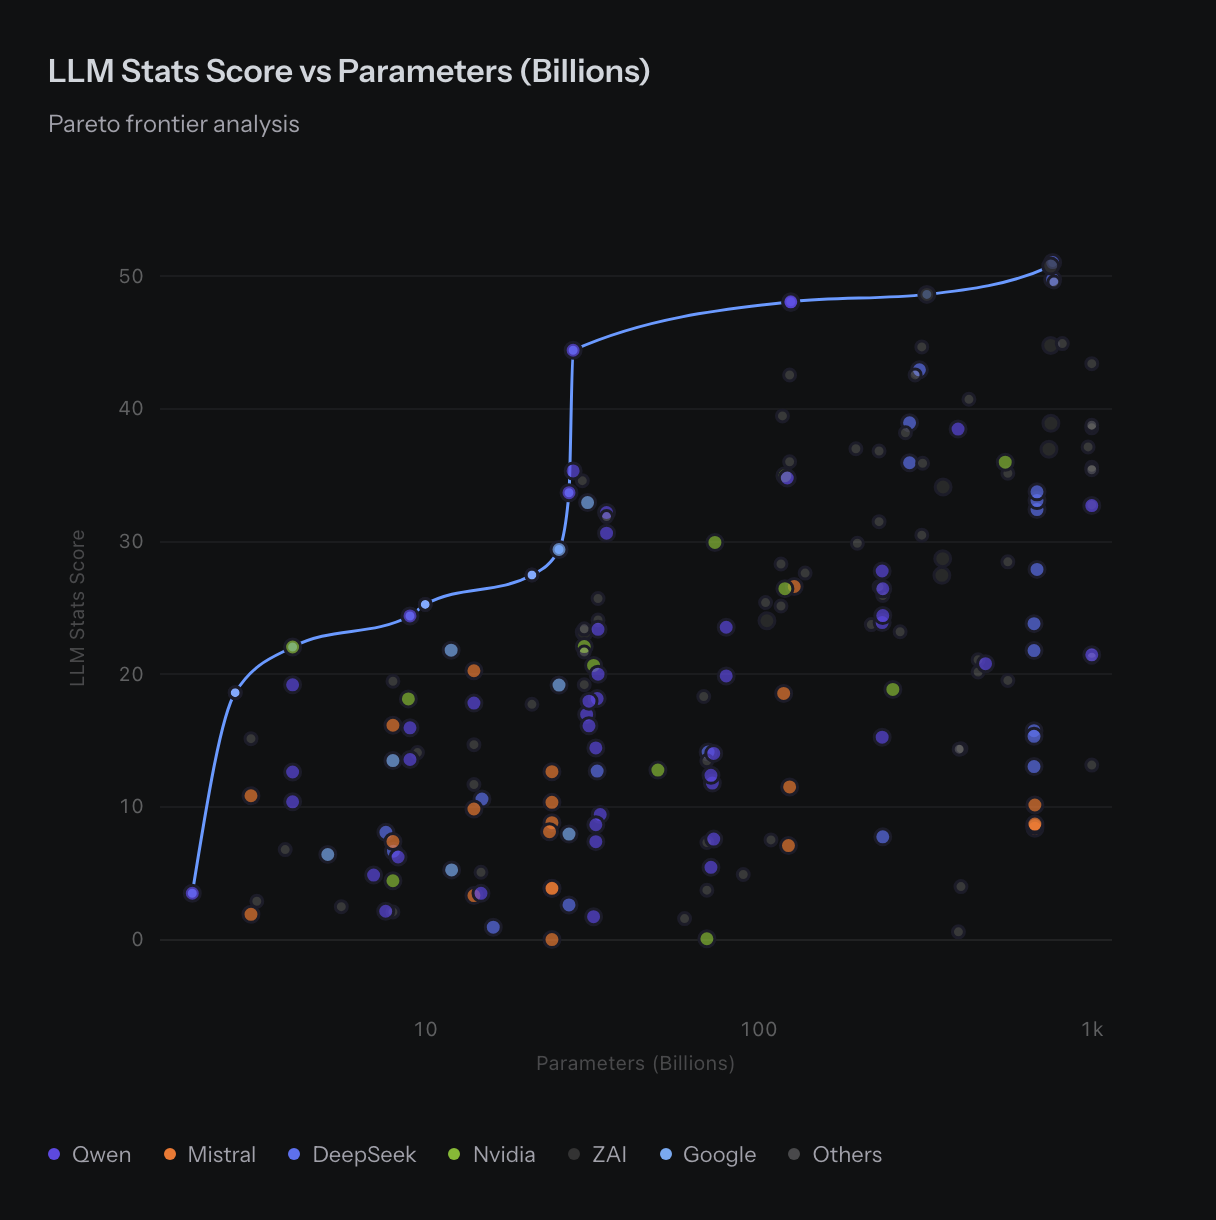
怎么看: 横轴为十亿参数数(B),使用对数刻度;纵轴为综合分,颜色区分机构,蓝线为参数—综合分前沿。
图表显示: 前沿只由少量模型组成,同一规模附近的分数分散很大。选择更大参数量,并不保证胜过更小且更靠近前沿的模型。
关键模型 / 数据点:
- Qwen3.8-27B:图示 28B 总参数,综合分 44.4。
- Qwen3.8-Flash-Next:125B,综合分 48.1。
- GLM-5.3:753B,综合分 50.8。
解读边界: 只包含同时具有参数与综合分的数据点,且截去参数量超过样本第 99 百分位或 1000B 的模型。图 31、34 中的 Kimi K3(2.8T)因此不会出现在本图,不能直接比较这些图的前沿上限。参数数字按本图提示的取整精度保留。
证据依据
- 直接证据:本图交互提示与图卡标注:Qwen3.8-27B:图示 28B 总参数,综合分 44.4;Qwen3.8-Flash-Next:125B,综合分 48.1;GLM-5.3:753B,综合分 50.8。
视觉推断:前沿位置与散点分布支持本图所述取舍;结论只覆盖本图可见样本。
- 直接证据:来源公开绘图逻辑将参数范围限制为不超过样本第 99 百分位与 1000B 中的较小值。
图 36|编程指数与参数量:代码任务需要单独比较
原始标题:Coding Index vs Parameters (Billions)
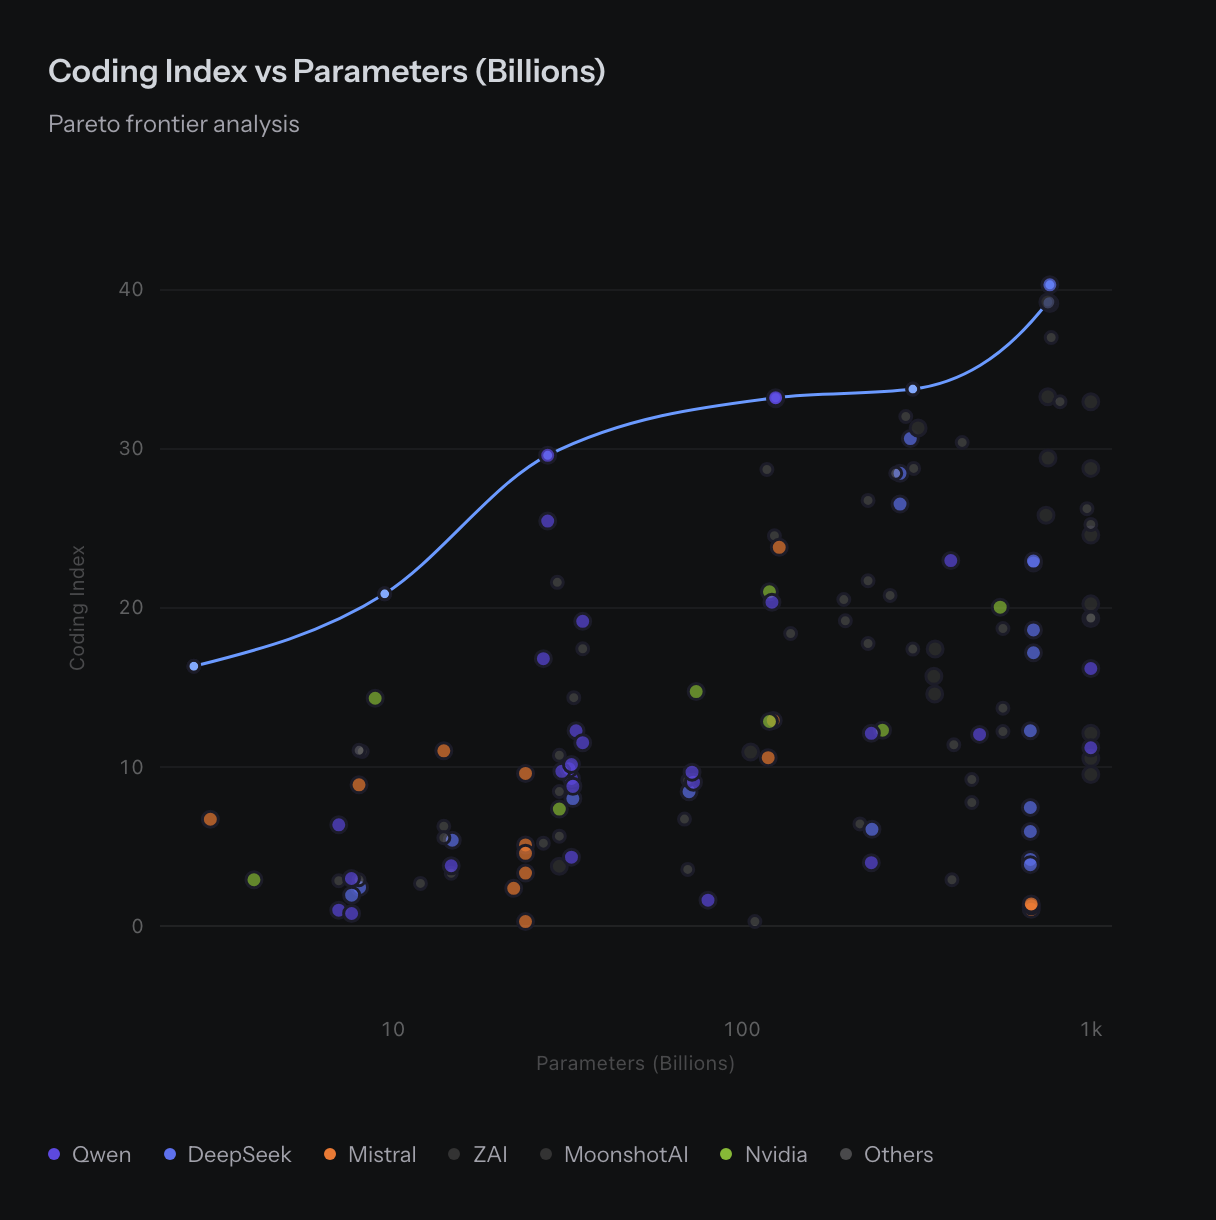
怎么看: 横轴为对数刻度的总参数量,纵轴是编程指数;左上方向表示以更少参数取得更高代码能力评分。
图表显示: 编程前沿随规模抬升,但大量大模型仍落在较小模型下方。综合分的高低不足以替代对编程任务的单独筛选。
关键模型 / 数据点:
- Qwen3.8-27B:图示 28B 总参数,编程指数 29.6。
- Qwen3.8-Flash-Next:125B,编程指数 33.2。
- DeepSeek-V4.1-Flash:763B,编程指数 40.3。
解读边界: 本图同样截去参数量超过样本第 99 百分位或 1000B 的模型,不能与包含数 T 模型的图 31、34 直接比较前沿上限。编程指数只覆盖来源收录的编程评测,参数量也不含工具调用、重试和测试执行的额外开销。参数数字按本图提示的取整精度保留。
证据依据
- 直接证据:本图交互提示与图卡标注:Qwen3.8-27B:图示 28B 总参数,编程指数 29.6;Qwen3.8-Flash-Next:125B,编程指数 33.2;DeepSeek-V4.1-Flash:763B,编程指数 40.3。
视觉推断:前沿位置与散点分布支持本图所述取舍;结论只覆盖本图可见样本。
- 直接证据:来源公开绘图逻辑将参数范围限制为不超过样本第 99 百分位与 1000B 中的较小值。
图 37|人类偏好与参数量:规模并不决定偏好
原始标题:Arena Rating vs Parameters (Billions)
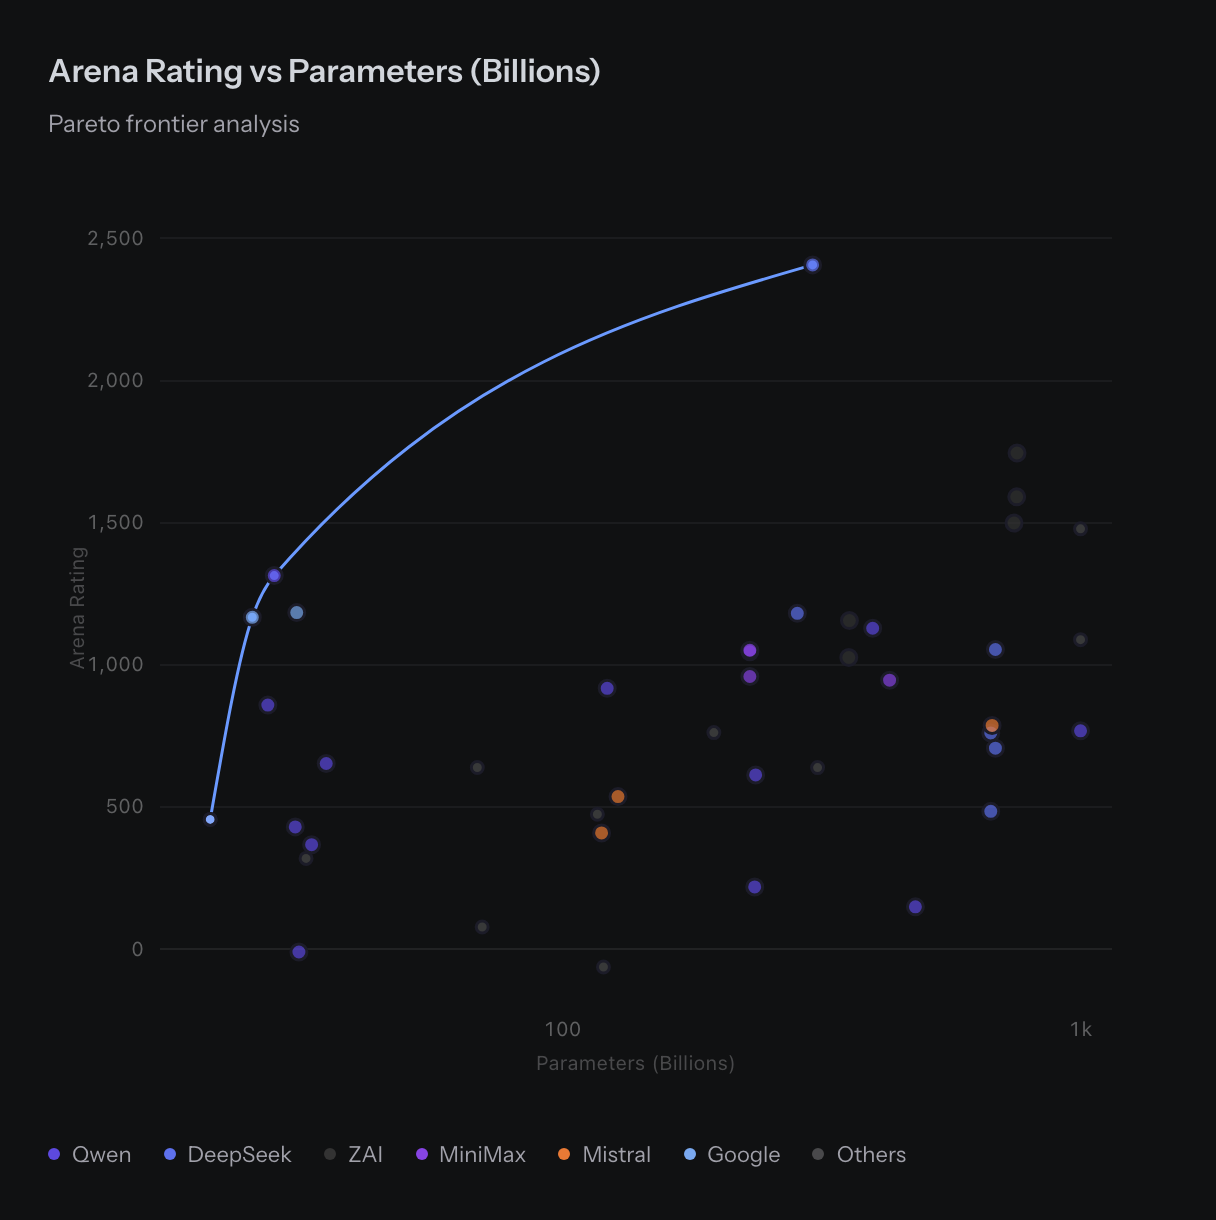
怎么看: 横轴为对数刻度的总参数量,纵轴为此图使用的原始 Arena rating;颜色区分机构,前沿偏向左上。
图表显示: 偏好得分并不随参数规模单调增长,部分中等规模点处在更大模型之上。按偏好选出的前沿与按综合分选出的前沿并不相同。
关键模型 / 数据点:
- Gemma 4 26B-A4B:图示 25B 总参数,Arena rating 1167。
- Qwen3.6-27B:图示 28B,Arena rating 1314。
- DeepSeek-V4-Flash-0731:304B,Arena rating 2407。
解读边界: 本图同样截去参数量超过样本第 99 百分位或 1000B 的模型,不能与包含数 T 模型的图 31、34 直接比较前沿上限。Arena 数值尺度与后面的约 20 分偏好图不同,不能混算,更不能解释成正确率。参数数字按本图提示的取整精度保留。
证据依据
- 直接证据:本图交互提示与图卡标注:Gemma 4 26B-A4B:图示 25B 总参数,Arena rating 1167;Qwen3.6-27B:图示 28B,Arena rating 1314;DeepSeek-V4-Flash-0731:304B,Arena rating 2407。
视觉推断:前沿位置与散点分布支持本图所述取舍;结论只覆盖本图可见样本。
- 直接证据:来源公开绘图逻辑将参数范围限制为不超过样本第 99 百分位与 1000B 中的较小值。
速度与上下文:容量上限和任务速度分别验收
本组结论: 上下文纪录仍为 200 万 token,吞吐前沿则显示速度与能力的取舍。不同吞吐图采用不同样本,长窗口和高 token/s 都不能单独代表整次任务完成得更快、更好。
图 38|上下文窗口:公开纪录仍为 200 万 token
原始标题:The Context Race
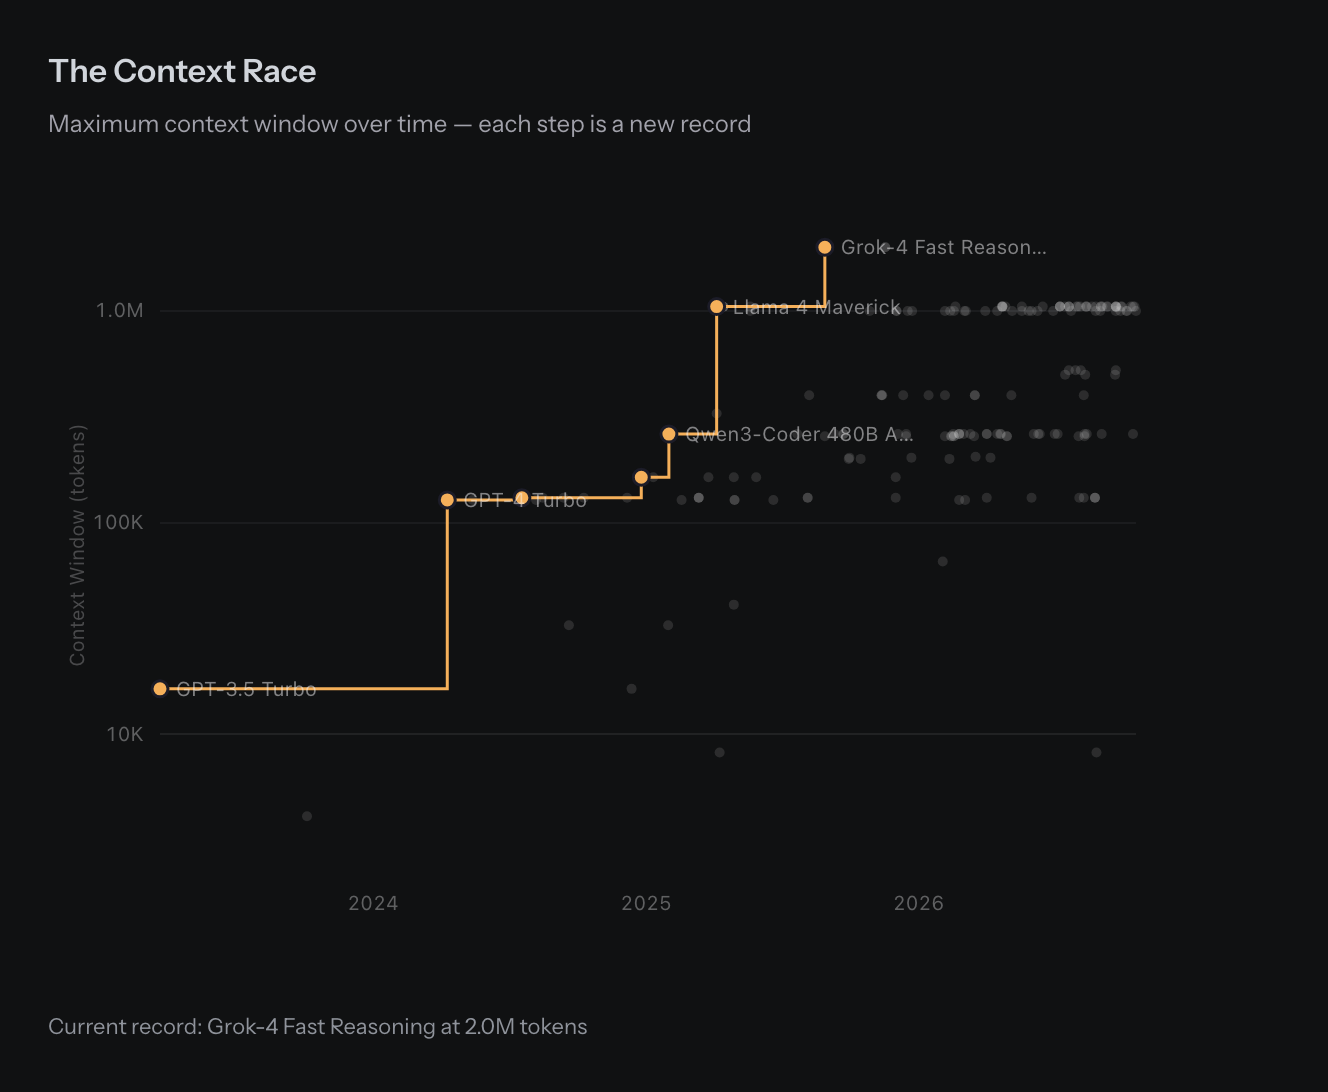
怎么看: 横轴是发布日期,纵轴是对数刻度的最大上下文窗口;灰点代表模型,橙色阶梯记录该样本的历史最高窗口。
图表显示: 本期图卡仍将 200 万 token 标为纪录,百万级窗口已有多款模型。窗口上限提供了输入容量,并不直接说明长文利用质量。
关键模型 / 数据点:
- Grok-4 Fast Reasoning:2.0M token,图示发布于 2025 年 8 月。
- Llama 4 Maverick:1.0M token,图示发布于 2025 年 4 月。
- GPT-6 Astra:1.1M token,图示发布于 2026 年 9 月。
解读边界: 这是来源收录的标称窗口,不能证明每个服务商均开放相同长度,也不能证明长上下文检索、推理或延迟达标。
证据依据
- 直接证据:本图交互提示与图卡标注:Grok-4 Fast Reasoning:2.0M token,图示发布于 2025 年 8 月;Llama 4 Maverick:1.0M token,图示发布于 2025 年 4 月;GPT-6 Astra:1.1M token,图示发布于 2026 年 9 月。
图 39|速度与能力:最高分和最高吞吐分属不同模型
原始标题:The Speed Tax
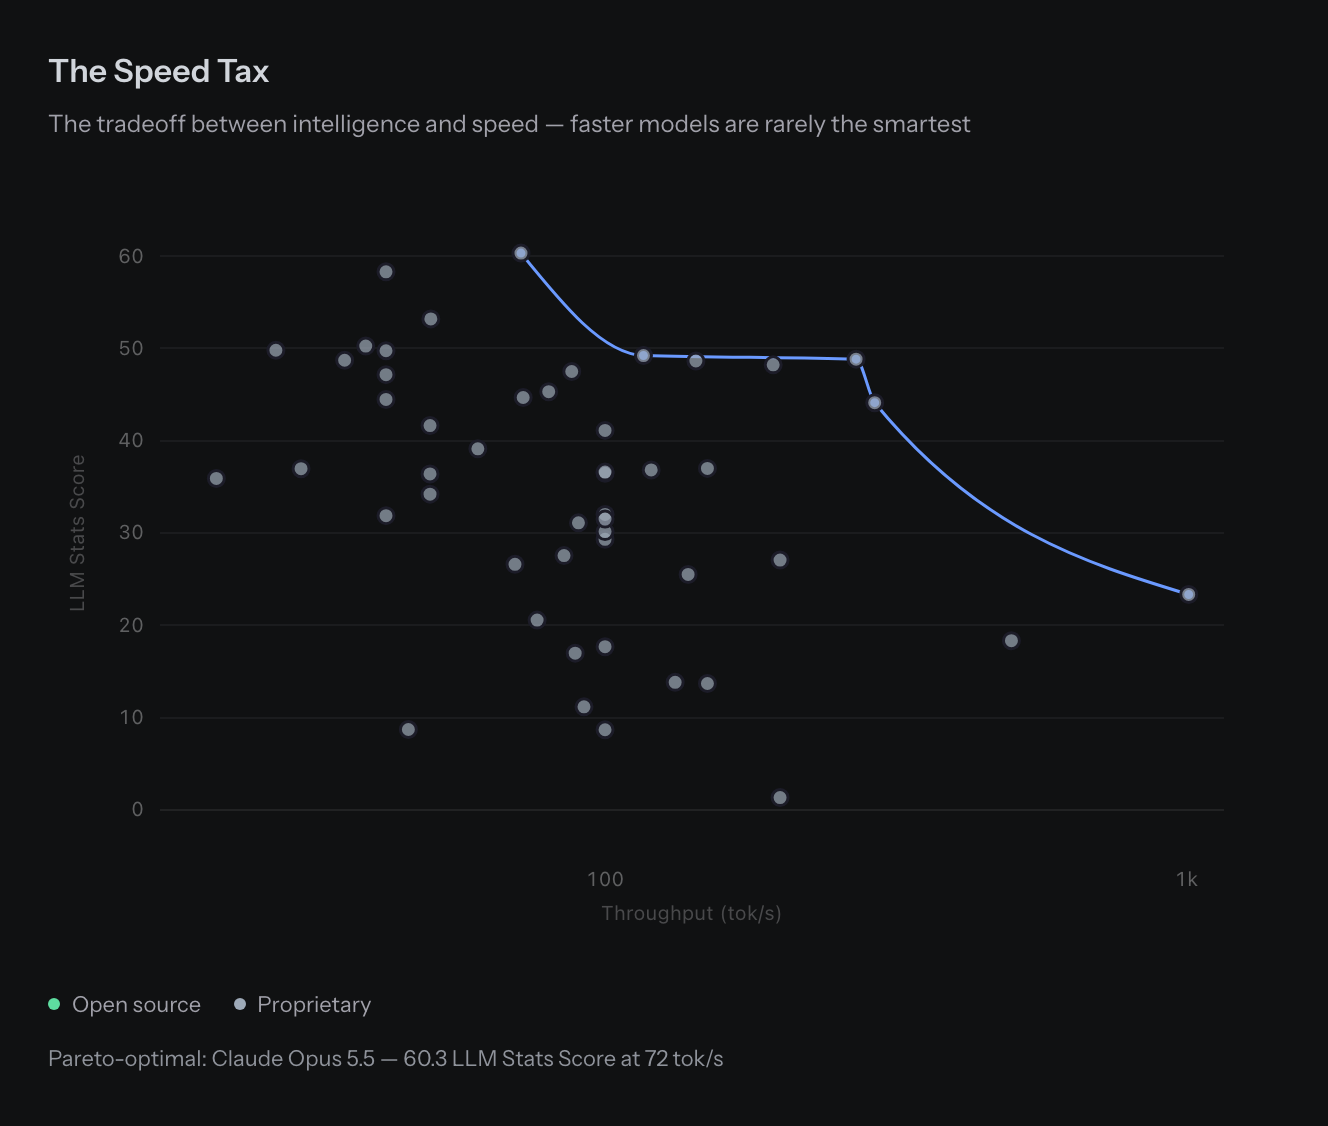
怎么看: 横轴是对数刻度吞吐量,纵轴是综合分;越靠右上越理想,曲线连接同图样本中的非支配模型。
图表显示: 本图最高能力点与最快点分离:Claude Opus 5.5 以 72 token/s 取得 60.3 分。前沿上不同位置代表不同速度与能力取舍。
关键模型 / 数据点:
- Claude Opus 5.5:综合分 60.3,吞吐 72 token/s。
- Step-3.5-Flash:综合分 37.0,吞吐 150 token/s。
- Mercury 2:综合分 23.3,吞吐 1009 token/s。
解读边界: 本图图例列出开放与专有类别,但本次点色不能可靠区分许可,本文只比较数值。吞吐不是首 token 延迟;相邻图样本不同,也未计入推理与工具等待。
证据依据
- 直接证据:本图交互提示与图卡标注:Claude Opus 5.5:综合分 60.3,吞吐 72 token/s;Step-3.5-Flash:综合分 37.0,吞吐 150 token/s;Mercury 2:综合分 23.3,吞吐 1009 token/s。
- 视觉推断:前沿位置与散点分布支持本图所述取舍;结论只覆盖本图可见样本。
图 40|综合分与吞吐量:另一个服务样本的前沿
原始标题:LLM Stats Score vs Throughput (tokens/sec)
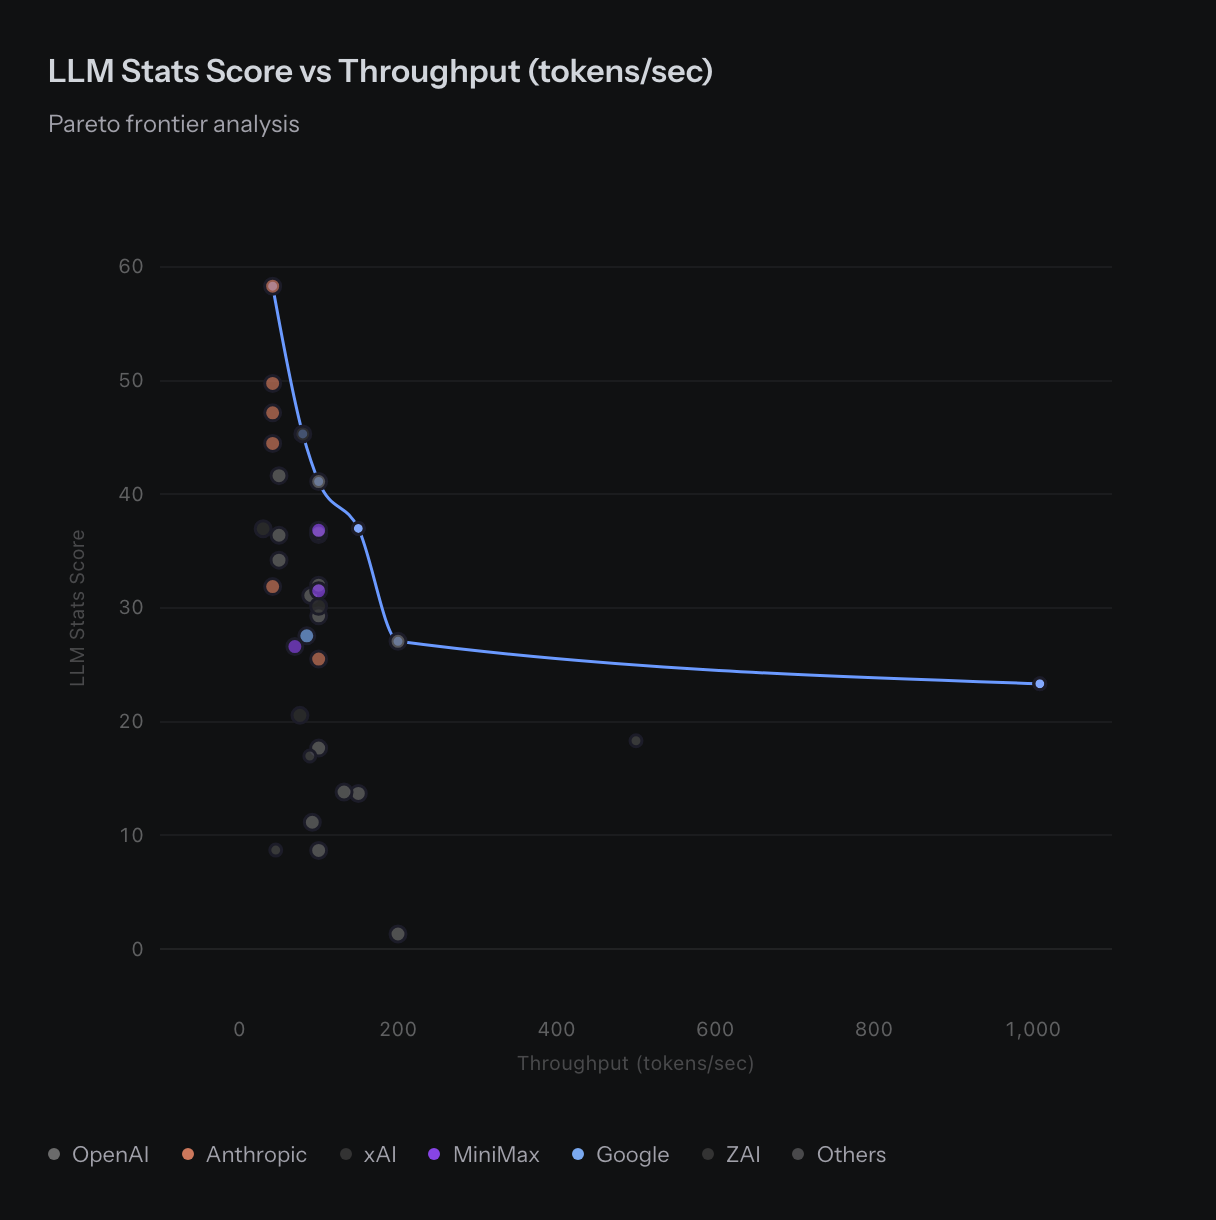
怎么看: 横轴为线性吞吐量,纵轴为综合分;颜色区分机构,蓝线显示同一可见样本中的能力—速度取舍。
图表显示: 线性横轴把超高速点单独拉到右侧;多数较高分模型聚集在较低吞吐区。这里的前沿适合给部署实验选择候选。
关键模型 / 数据点:
- Claude Sonnet 5.5:42 token/s,综合分 58.3。
- Step-3.5-Flash:150 token/s,综合分 37.0。
- Mercury 2:1009 token/s,综合分 23.3。
解读边界: 本图不能直接替换图 39:收录模型与吞吐数值有差异;缺少某个最新模型的点,不表示它的能力或速度为零。
证据依据
- 直接证据:本图交互提示与图卡标注:Claude Sonnet 5.5:42 token/s,综合分 58.3;Step-3.5-Flash:150 token/s,综合分 37.0;Mercury 2:1009 token/s,综合分 23.3。
- 视觉推断:前沿位置与散点分布支持本图所述取舍;结论只覆盖本图可见样本。
图 41|编程指数与吞吐量:代码质量和输出速度分开验收
原始标题:Coding Index vs Throughput (tokens/sec)
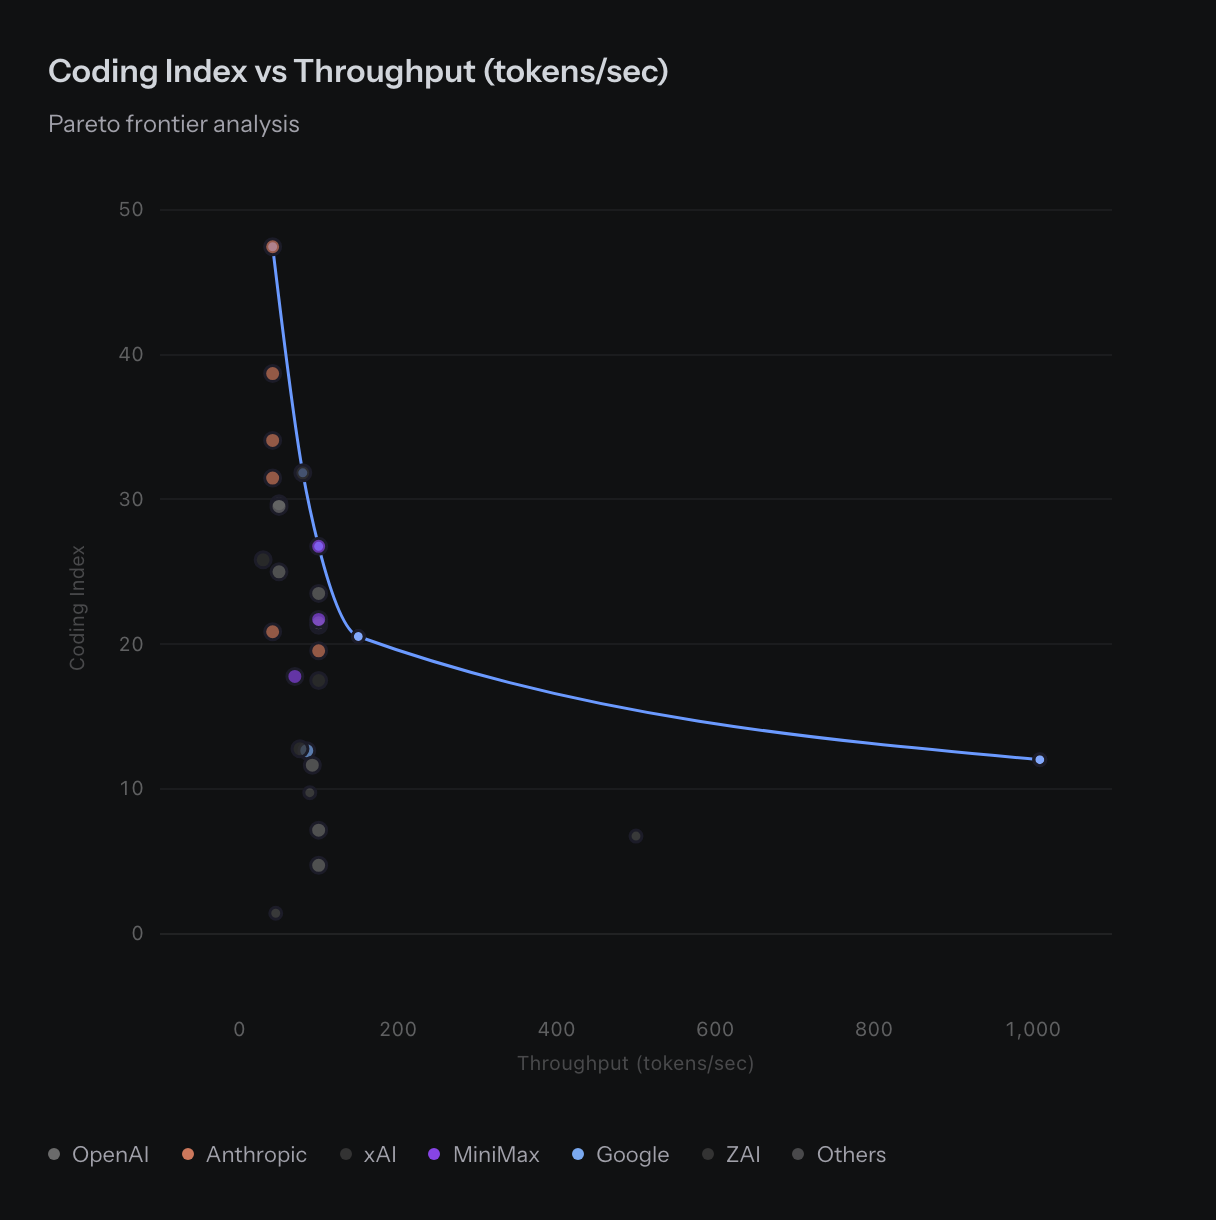
怎么看: 横轴为每秒生成 token 数,纵轴为编程指数;右上方向更优,蓝线是当前样本的非支配前沿。
图表显示: 吞吐量很高的模型未必有更高编程分。代码工作流应同时记录生成速度、测试通过率和修复轮次,才能理解实际效率。
关键模型 / 数据点:
- Claude Sonnet 5.5:42 token/s,编程指数 47.5。
- MiniMax M2.5:100 token/s,编程指数 26.8。
- Mercury 2:1009 token/s,编程指数 12.0。
解读边界: 编程指数和吞吐只是两个局部指标;本图没有统计构建、测试、工具等待或多轮重试的耗时。
证据依据
- 直接证据:本图交互提示与图卡标注:Claude Sonnet 5.5:42 token/s,编程指数 47.5;MiniMax M2.5:100 token/s,编程指数 26.8;Mercury 2:1009 token/s,编程指数 12.0。
- 视觉推断:前沿位置与散点分布支持本图所述取舍;结论只覆盖本图可见样本。
图 42|偏好与吞吐量:快速响应不等于更受偏爱
原始标题:Arena Rating vs Throughput (tokens/sec)
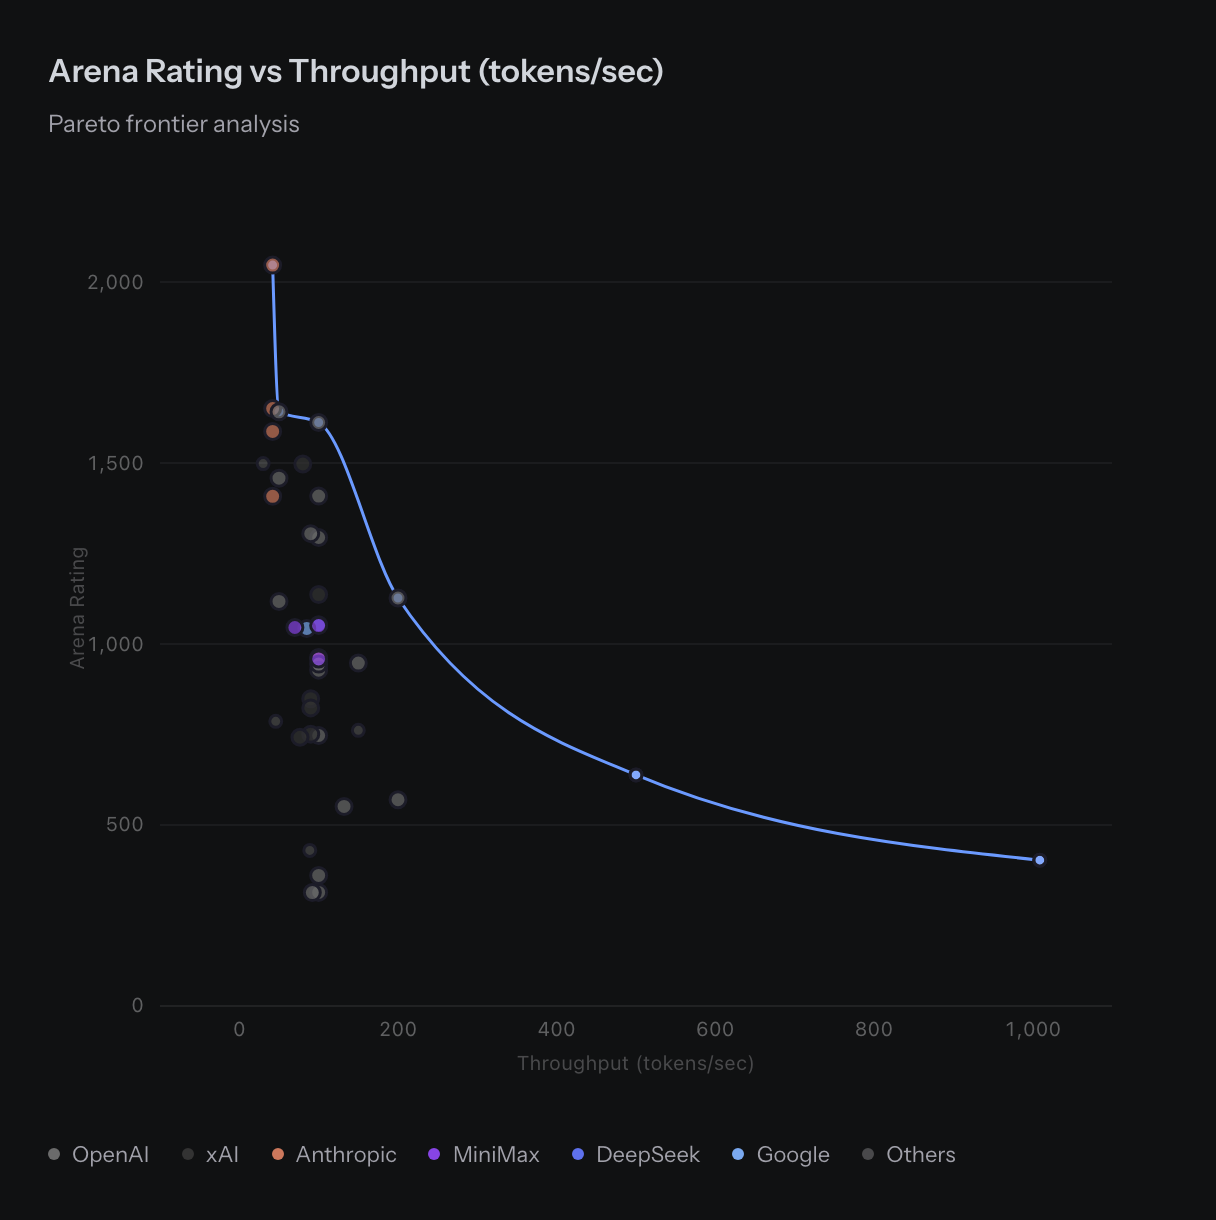
怎么看: 横轴是线性吞吐量,纵轴是此图的原始 Arena rating;前沿表示更快输出与更高偏好评分之间的可见取舍。
图表显示: 最高吞吐点与最高偏好点相距很远,说明单看生成速度无法替代体验评测。可以从不同前沿点选择候选,再验证具体交互任务。
关键模型 / 数据点:
- Claude Opus 4.6:42 token/s,Arena rating 2048。
- LongCat-Flash-Lite:500 token/s,Arena rating 639。
- Mercury 2:1009 token/s,Arena rating 403。
解读边界: 不同 Arena 图的评分尺度与样本范围不同;此图也没有直接测量等待体验,不能把偏好差异归因于速度。
证据依据
- 直接证据:本图交互提示与图卡标注:Claude Opus 4.6:42 token/s,Arena rating 2048;LongCat-Flash-Lite:500 token/s,Arena rating 639;Mercury 2:1009 token/s,Arena rating 403。
- 视觉推断:前沿位置与散点分布支持本图所述取舍;结论只覆盖本图可见样本。
人类偏好:能力有参考价值,价格解释力有限
本组结论: 综合分与编程指数的相关性高于它与偏好的相关性,价格对偏好差异的解释力仅 4%。各偏好图的样本和尺度并不一致,末图还保留 8 月榜单,读图时必须同时核对口径与更新边界。
图 43|评测相关性:综合分与编程更接近,与偏好并不等价
原始标题:Benchmark Correlation
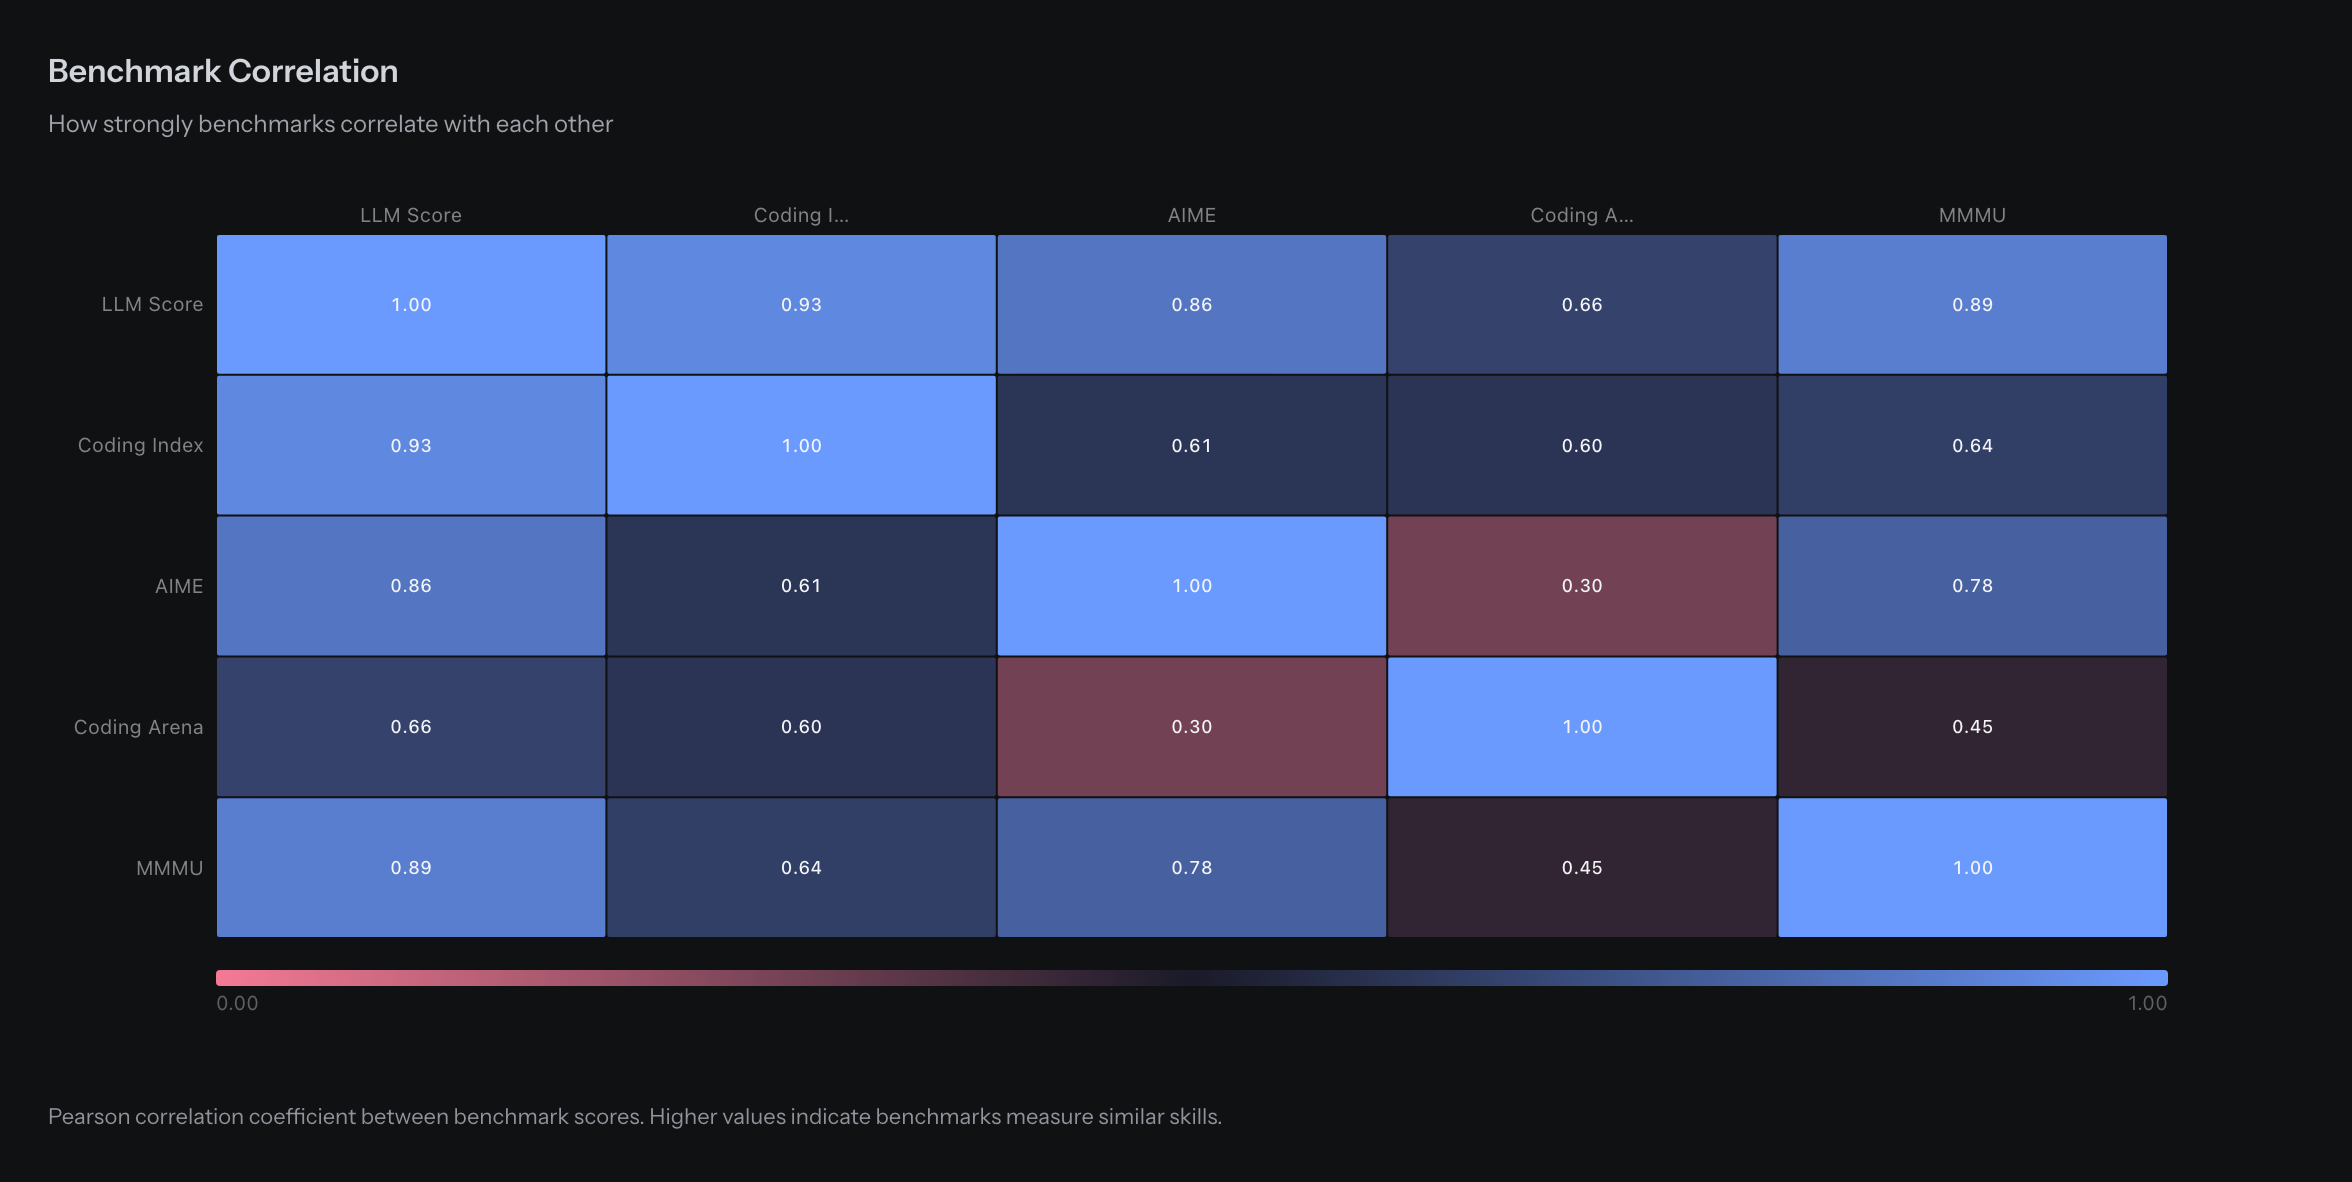
怎么看: 矩阵每格为两个指标的 Pearson r,越接近 1 表示样本内线性相关越强;对角线是指标与自身的相关。
图表显示: 综合分与编程指数高度相关,但数学题成绩与编程偏好的相关性弱得多。跨指标一致性有差别,仍需要保留任务维度。
关键模型 / 数据点:
- LLM Score × Coding Index:Pearson r = 0.93。
- LLM Score × MMMU:r = 0.89;× Coding Arena:r = 0.66。
- AIME × Coding Arena:r = 0.30,明显低于综合分与编程指数的相关。
解读边界: 相关性会受共享评测、模型样本和缺失值影响;高度相关既不证明两个任务相同,也不能单独证明因果。
证据依据
- 直接证据:图卡、SVG 可见标注:LLM Score × Coding Index:Pearson r = 0.93;LLM Score × MMMU:r = 0.89;× Coding Arena:r = 0.66;AIME × Coding Arena:r = 0.30,明显低于综合分与编程指数的相关。
图 44|综合分与编程偏好:有一致性,也有明显残差
原始标题:Do Humans Agree With the Indexes?
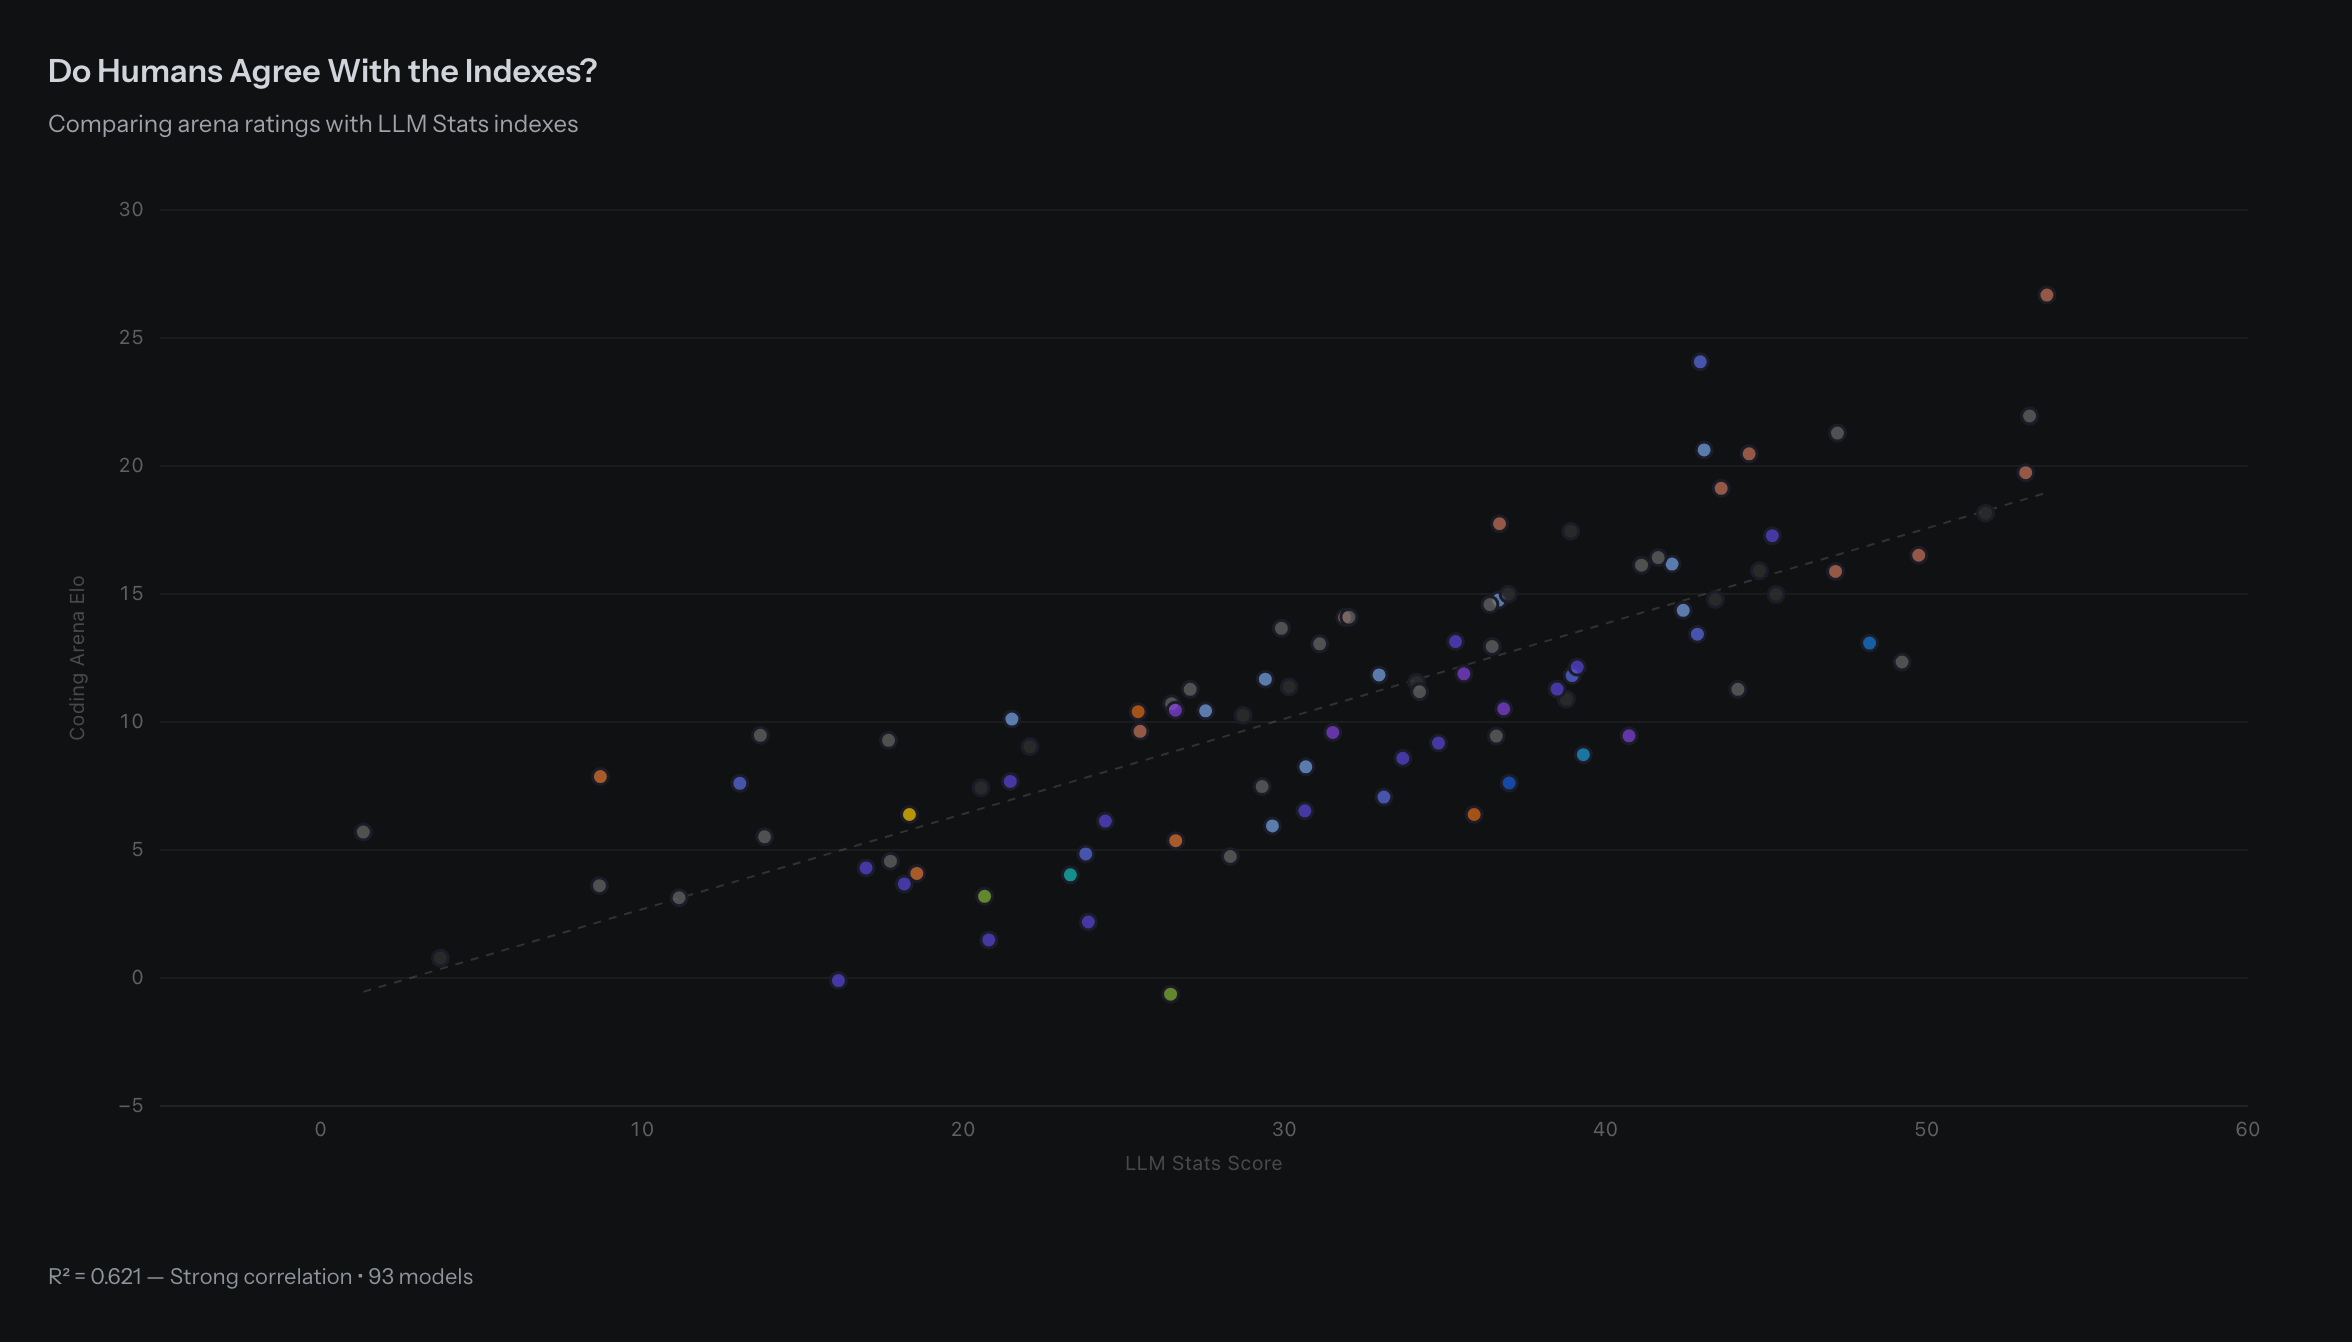
怎么看: 当前截图选中综合分标签:横轴是 LLM Stats Score,纵轴是该卡的 Coding Arena Elo;虚线表示拟合趋势。
图表显示: 本图 93 个模型的拟合 R² 为 0.621,综合分能解释这组编程偏好的部分差异,但同分附近仍出现不同偏好。
关键模型 / 数据点:
- 样本量 93 个,拟合 R² = 0.621。
- Claude Opus 5:综合分 53.7,Coding Arena Elo 显示为 27。
- GPT-5.6 Sol:综合分 53.2,Coding Arena Elo 显示为 22。
解读边界: 这是默认综合分视图,没有据此分析未选中的编程指数标签;R² 不能直接当成预测准确率。
证据依据
- 直接证据:本图交互提示与图卡标注:样本量 93 个,拟合 R² = 0.621;Claude Opus 5:综合分 53.7,Coding Arena Elo 显示为 27;GPT-5.6 Sol:综合分 53.2,Coding Arena Elo 显示为 22。
图 45|综合分与一般偏好:正相关仍不足以决定选型
原始标题:LLM Stats Score vs Arena
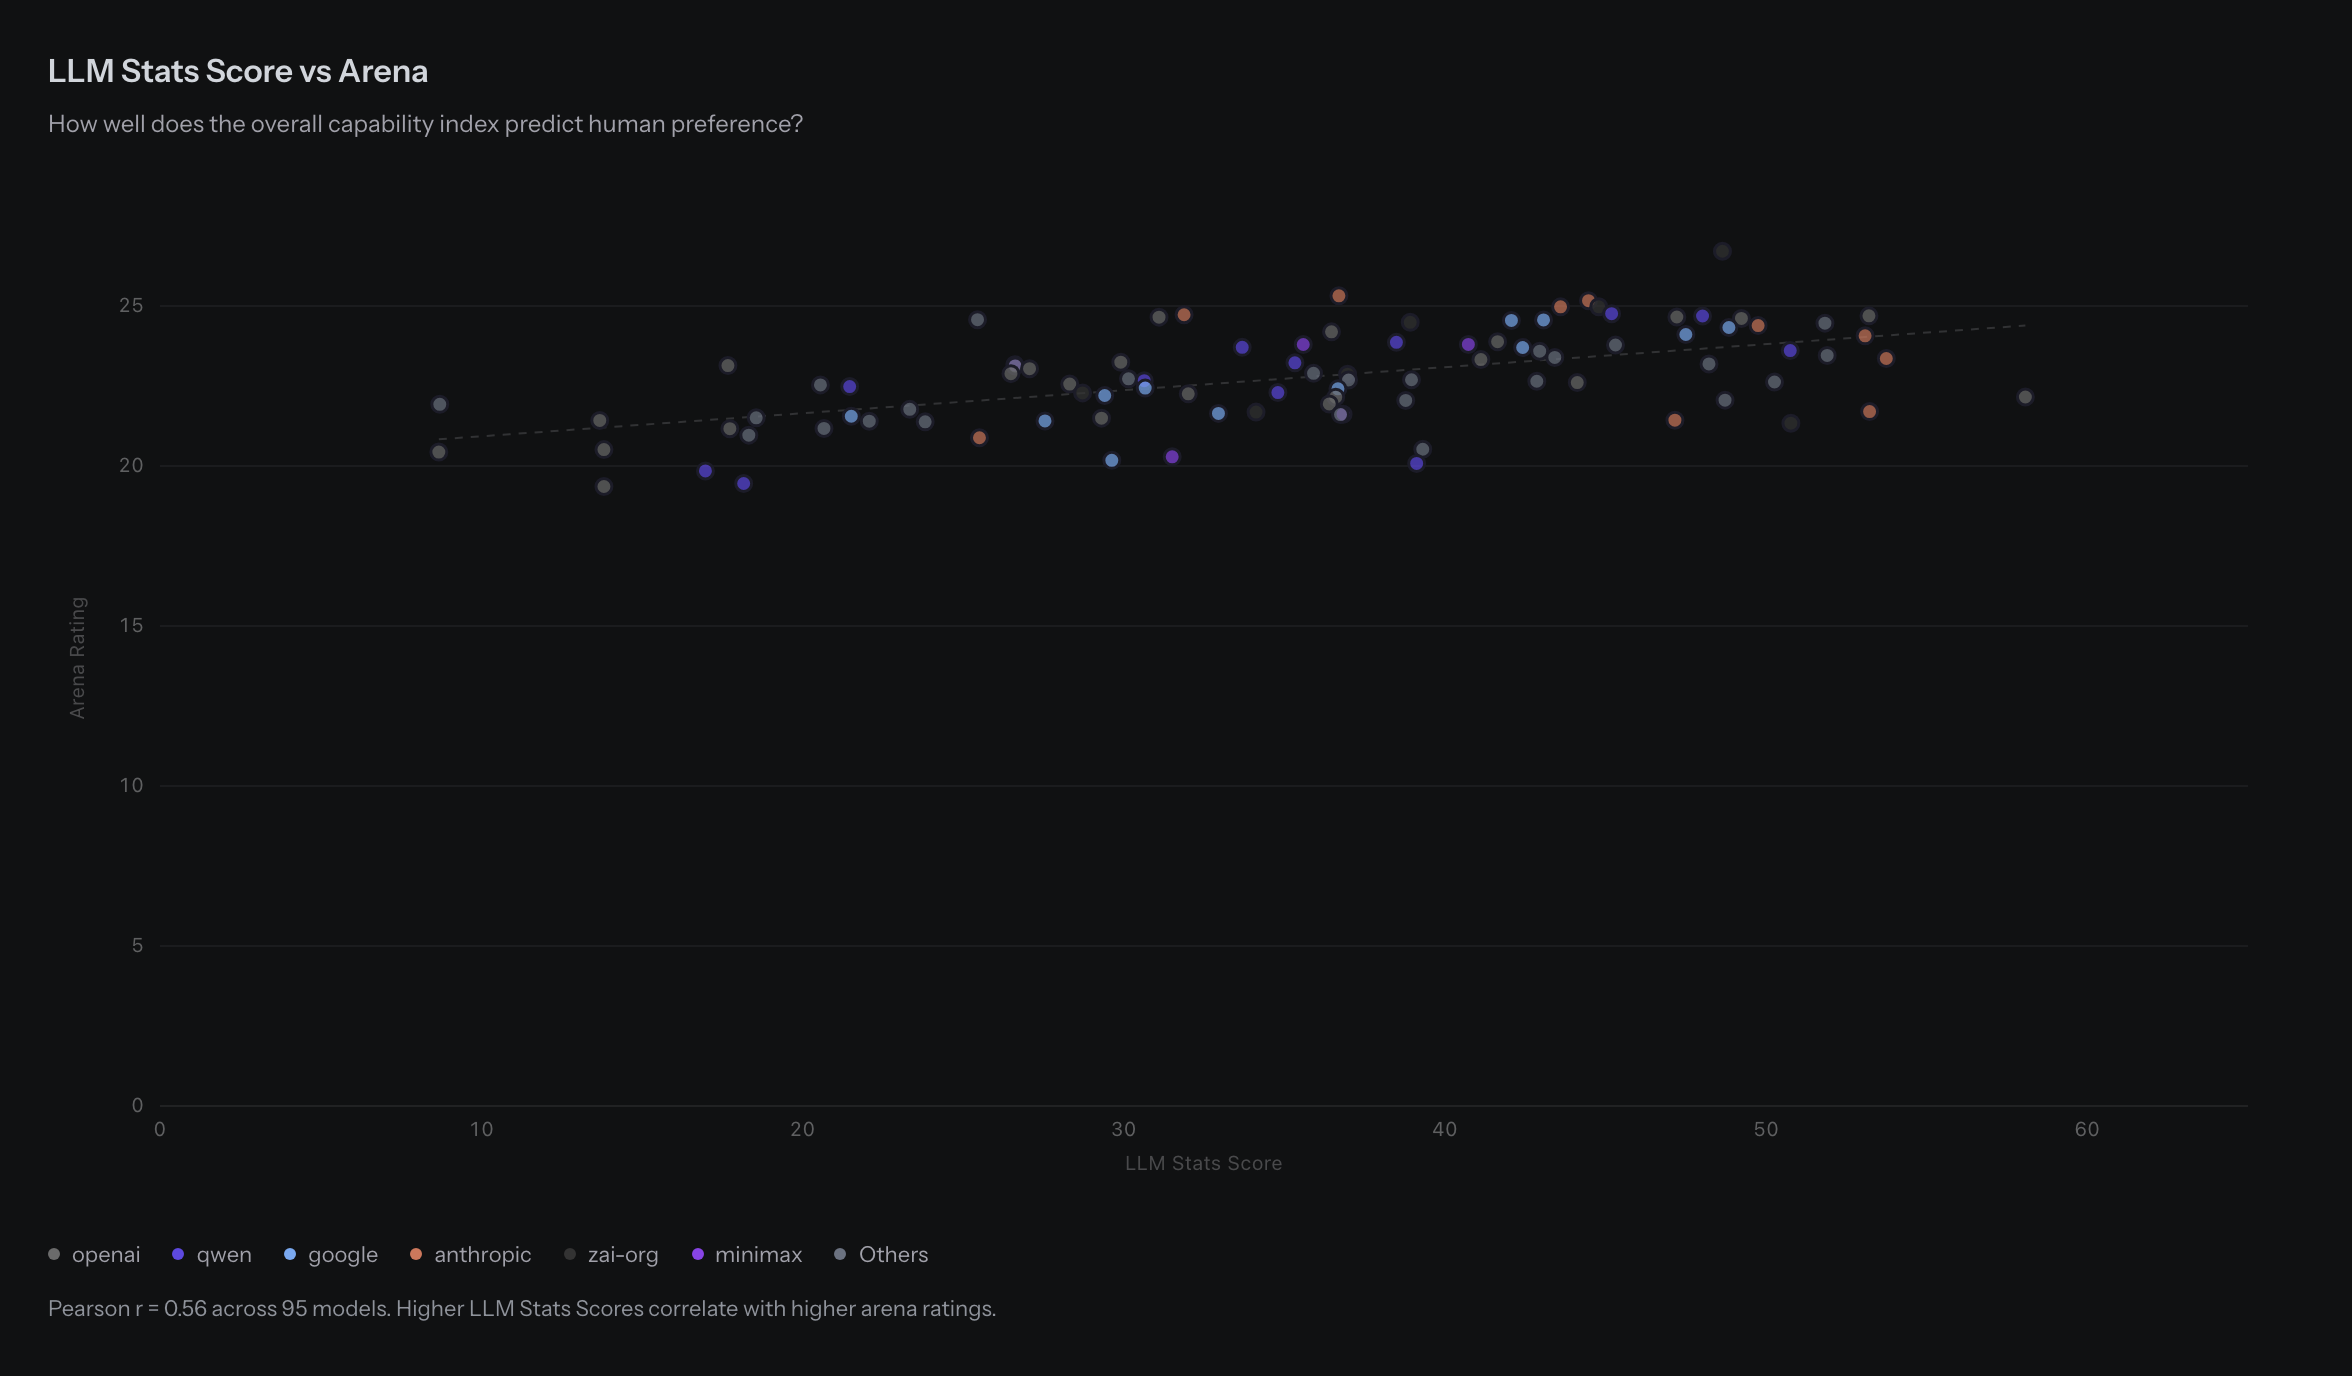
怎么看: 横轴是综合分,纵轴是该图标准化的 Arena rating;机构由颜色区分,虚线为拟合线。
图表显示: 95 个模型的 Pearson r 为 0.56,呈正向关系,但同一综合分区间的偏好仍有分散。综合能力可作为筛选线索,无法保证每种交互任务的偏好。
关键模型 / 数据点:
- 样本量 95 个,Pearson r = 0.56。
- GLM-5.3-Flash:综合分 48.6,Arena rating 26.7。
- GPT-6 Astra:综合分 58.1,Arena rating 22.2。
解读边界: 本图使用 r,图 44 和 46 使用 R²;样本与偏好口径也不同,不应把三个数直接排序为评测强弱。
证据依据
- 直接证据:本图交互提示与图卡标注:样本量 95 个,Pearson r = 0.56;GLM-5.3-Flash:综合分 48.6,Arena rating 26.7;GPT-6 Astra:综合分 58.1,Arena rating 22.2。
图 46|另一组用户评分:样本改变,结论也要限定
原始标题:User Ratings vs LLM Stats Score
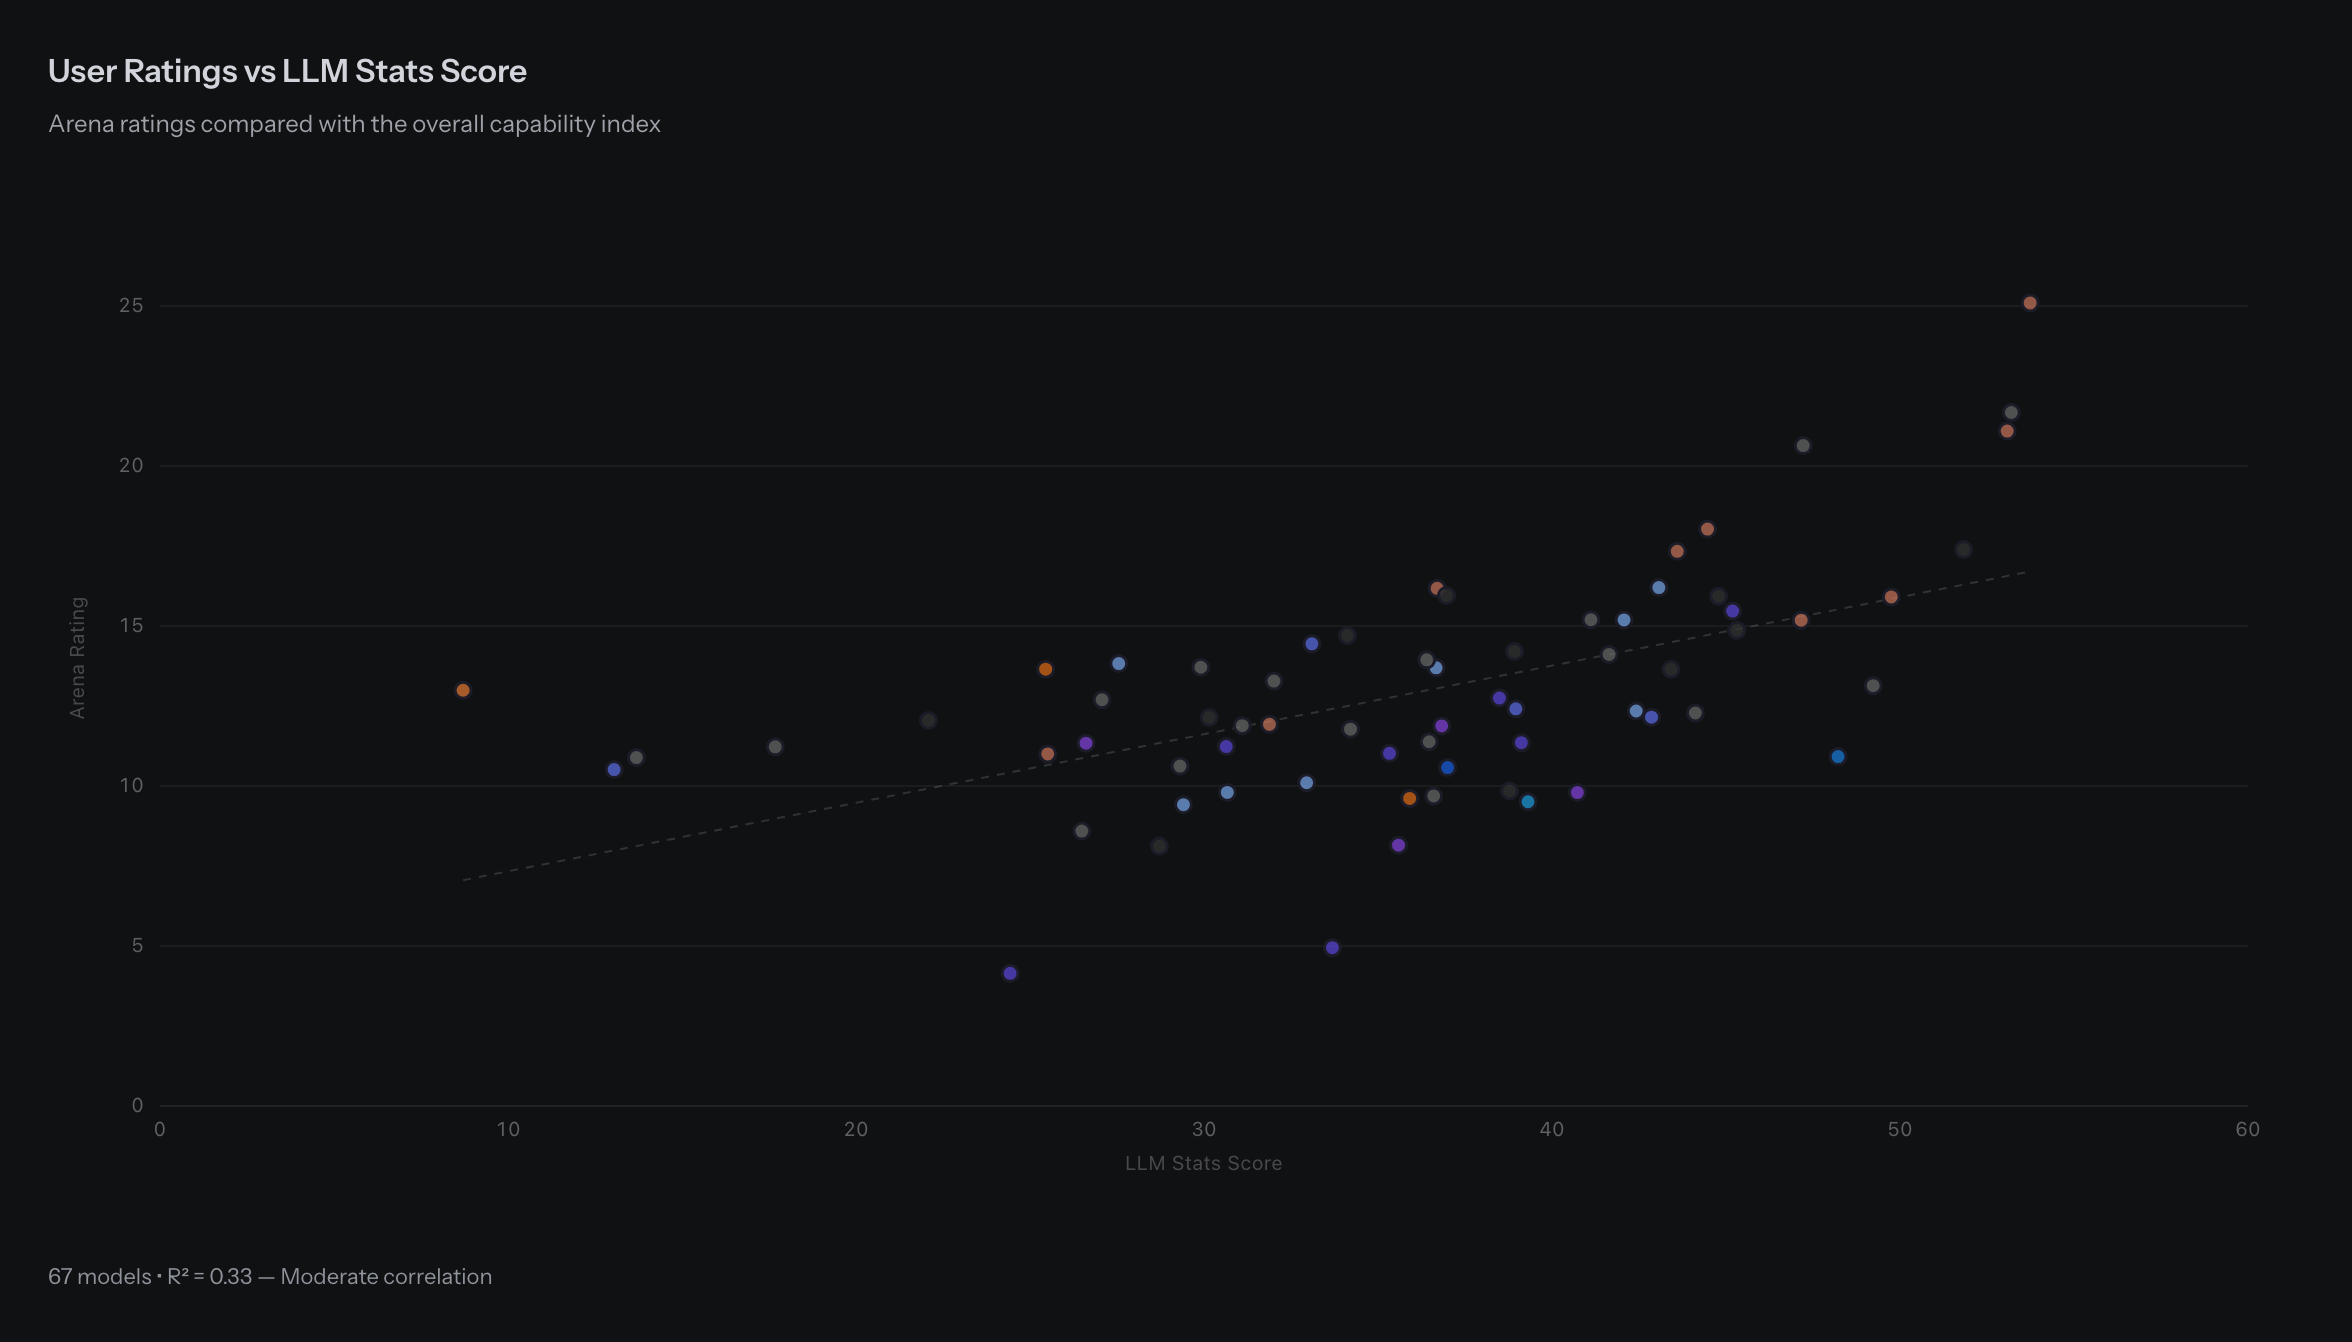
怎么看: 横轴是综合分,纵轴是这组 Arena rating;散点与虚线展示 67 个模型的关系。
图表显示: 这组样本 R² 为 0.33,综合分与偏好有一定关联,但仍有大量差异没有被这一条回归解释。
关键模型 / 数据点:
- 样本量 67 个,拟合 R² = 0.33。
- Claude Opus 5:综合分 53.7,Arena rating 显示为 25。
- GPT-5.6 Sol:综合分 53.2,Arena rating 显示为 22。
解读边界: 与图 45 的 95 模型样本不同,不能把本图视为对上一图的重复验证,更不能将两组拟合统计混为一个结论。
证据依据
- 直接证据:本图交互提示与图卡标注:样本量 67 个,拟合 R² = 0.33;Claude Opus 5:综合分 53.7,Arena rating 显示为 25;GPT-5.6 Sol:综合分 53.2,Arena rating 显示为 22。
图 47|价格与偏好:昂贵并不保证更好体验
原始标题:Cost vs Arena Rating
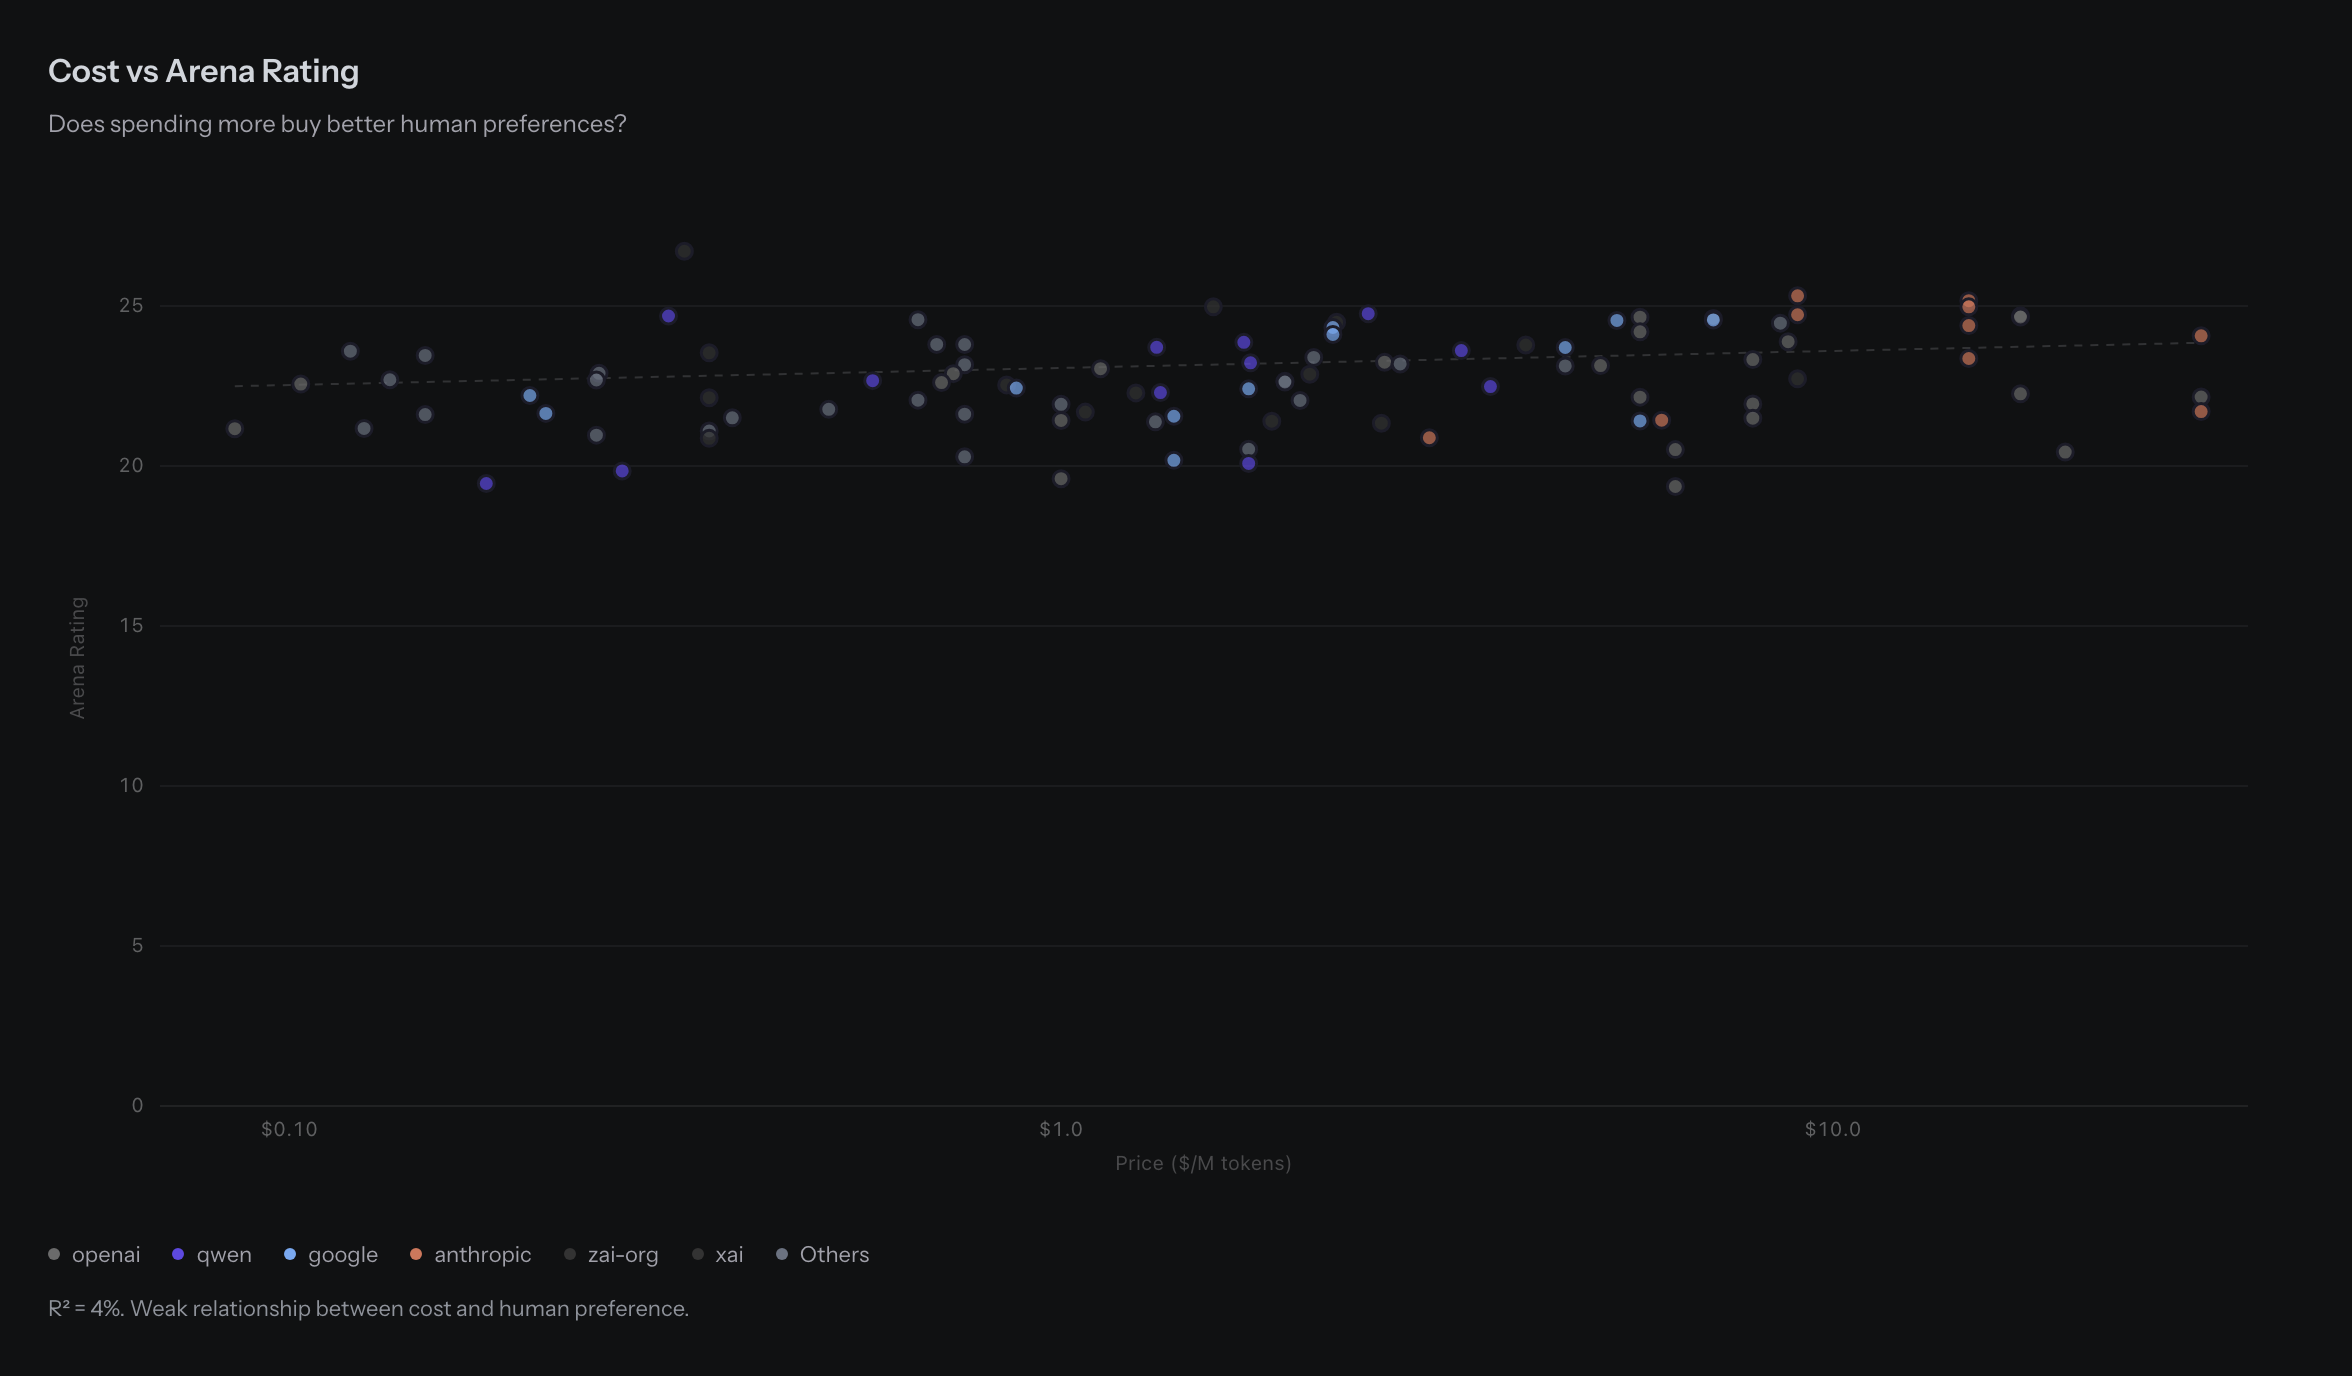
怎么看: 横轴是对数刻度的每百万 token 价格,纵轴为该图的 Arena rating;虚线表示样本内回归。
图表显示: 价格跨度很大,偏好分却高度重叠,图卡给出的 R² 仅 4%。API 单价对这组偏好差异的解释力很弱。
关键模型 / 数据点:
- 价格与 Arena 评分的拟合 R² = 4%。
- GLM-5.3-Flash:每百万 token 0.33 美元,Arena rating 26.7。
- Claude Fable 5:每百万 token 30.0 美元,Arena rating 24.1。
解读边界: 这是不同模型的横截面比较,不是降价实验;不同价格图的混合规则也可能不同。单价不等于基础设施成本或一次成功任务的总费用。
证据依据
- 直接证据:本图交互提示与图卡标注:价格与 Arena 评分的拟合 R² = 4%;GLM-5.3-Flash:每百万 token 0.33 美元,Arena rating 26.7;Claude Fable 5:每百万 token 30.0 美元,Arena rating 24.1。
图 48|偏好榜的时间边界:本图仍保留旧榜单
原始标题:Human Preference Map
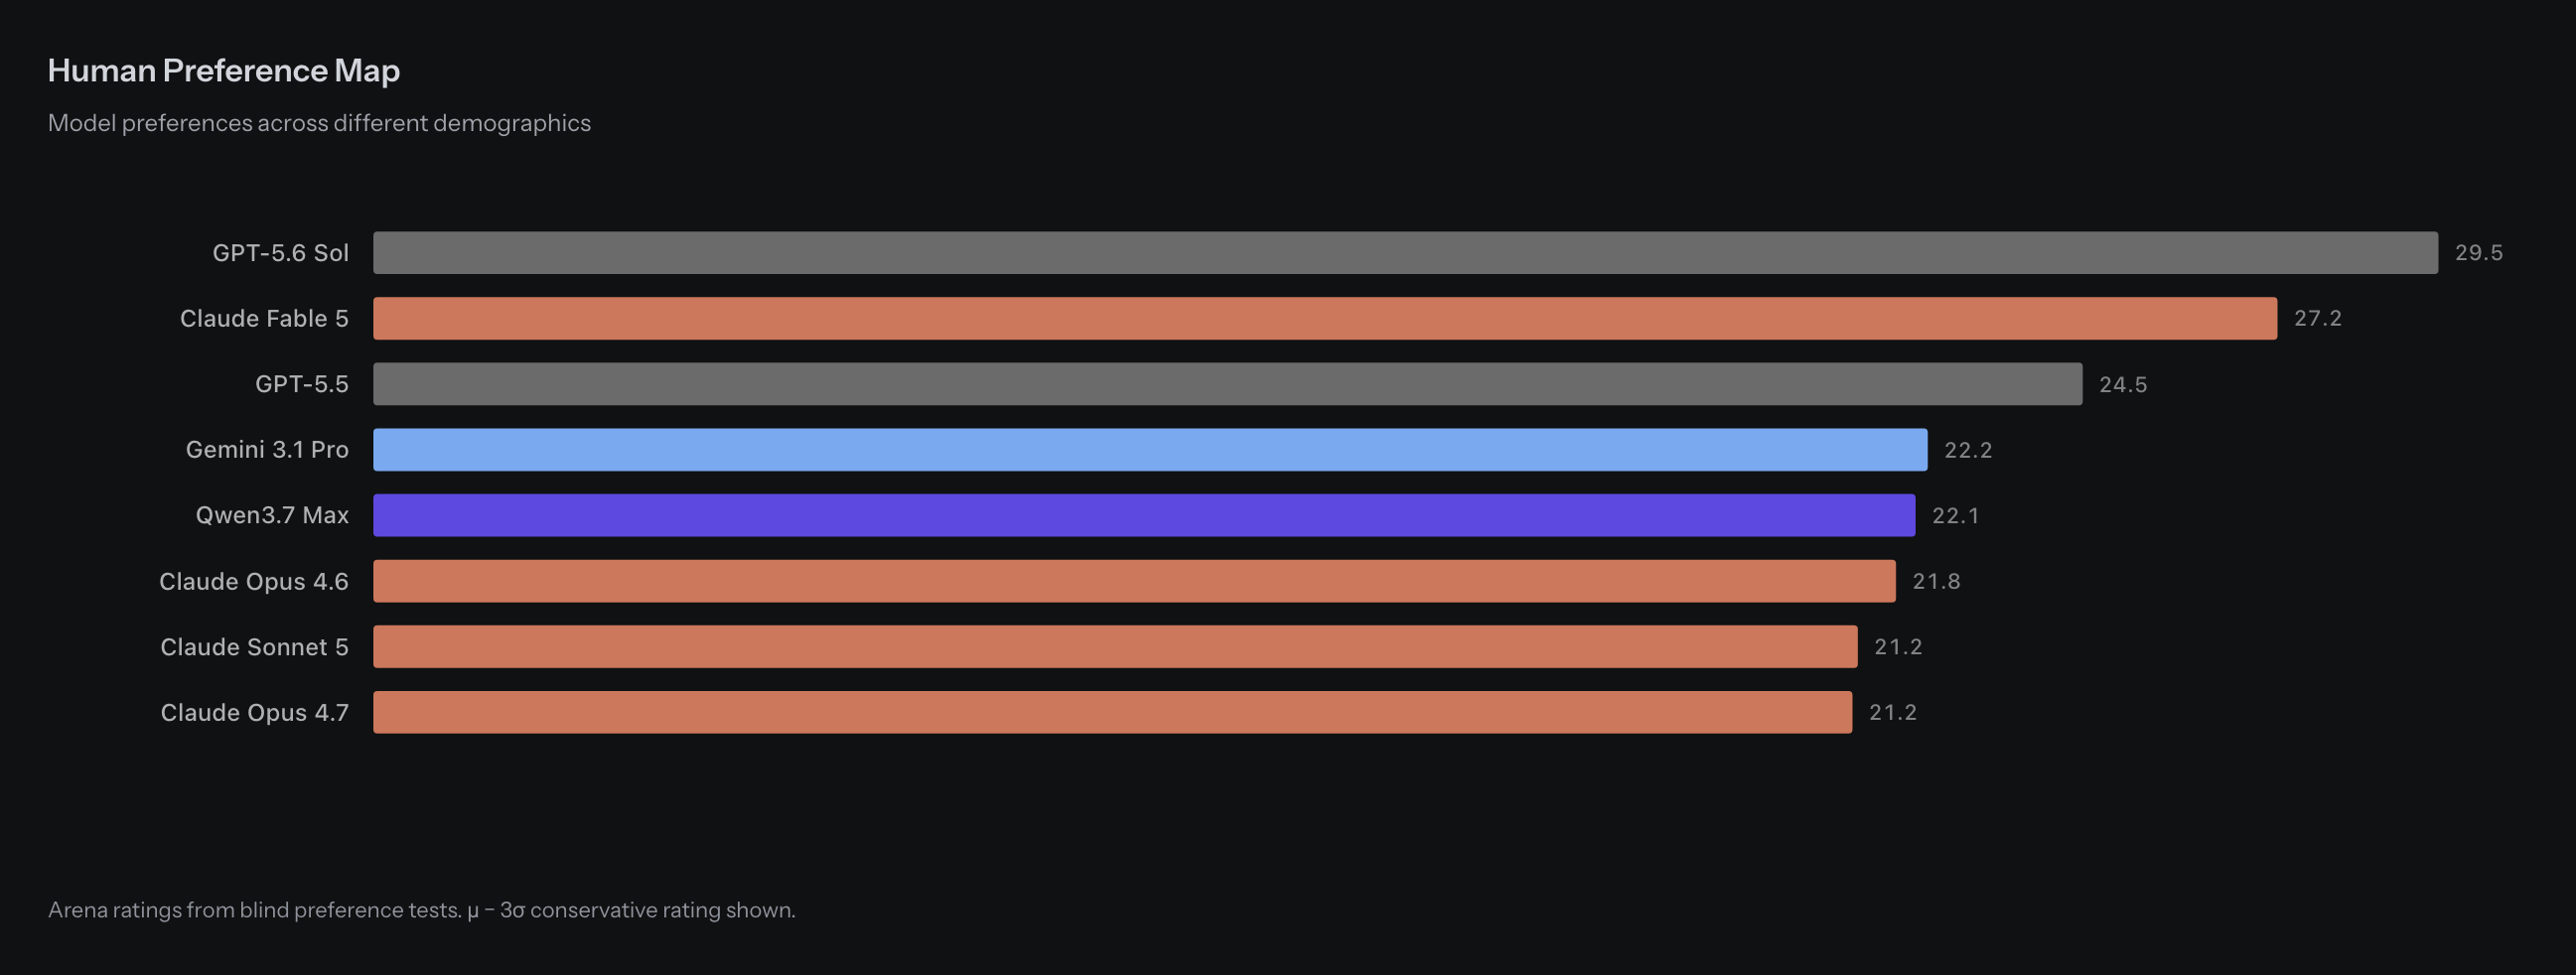
怎么看: 当前显示 Top Models 标签,横条越长代表保守偏好分越高。该卡使用 $\mu - 3\sigma$:$\mu$ 为估计均值,$\sigma$ 表示不确定性尺度。
图表显示: 本图八个模型及分数与 8 月快照完全相同。它能说明这张卡展示了哪些偏好数据,不能据此声称这些模型仍是 10 月所有新模型中的偏好前八。
关键模型 / 数据点:
- GPT-5.6 Sol:保守偏好分 29.5。
- Claude Fable 5:27.2;GPT-5.5:24.5。
- Gemini 3.1 Pro:22.2;Qwen3.7 Max:22.1。
- 全部 8 个模型及分数与 2026 年 8 月报告的同名图一致。
解读边界: 网页总标题更新到 10 月,不保证每张卡同步更新;未切换国家和年龄标签,因此本文不作人群差异判断。
证据依据
- 直接证据:图卡、SVG 可见标注:GPT-5.6 Sol:保守偏好分 29.5;Claude Fable 5:27.2;GPT-5.5:24.5;Gemini 3.1 Pro:22.2;Qwen3.7 Max:22.1;全部 8 个模型及分数与 2026 年 8 月报告的同名图一致。